Muse Wonder frente a Opus 5.5 y GPT-6: comparativa en 23 tareas
Comparativa de Muse Wonder con Opus 5.5, Fable 5.1, GPT-6 Astra y Gemini 3.8 Flash en 23 pruebas prácticas: agentes, código y costes reales por token.
Actualización (9 de noviembre de 2026): ya han salido Claude Fable 5.2 y Mythos 5.2 - precios, acceso y benchmarks en mi guía de Claude Fable 5.2.
👁 119 lecturas
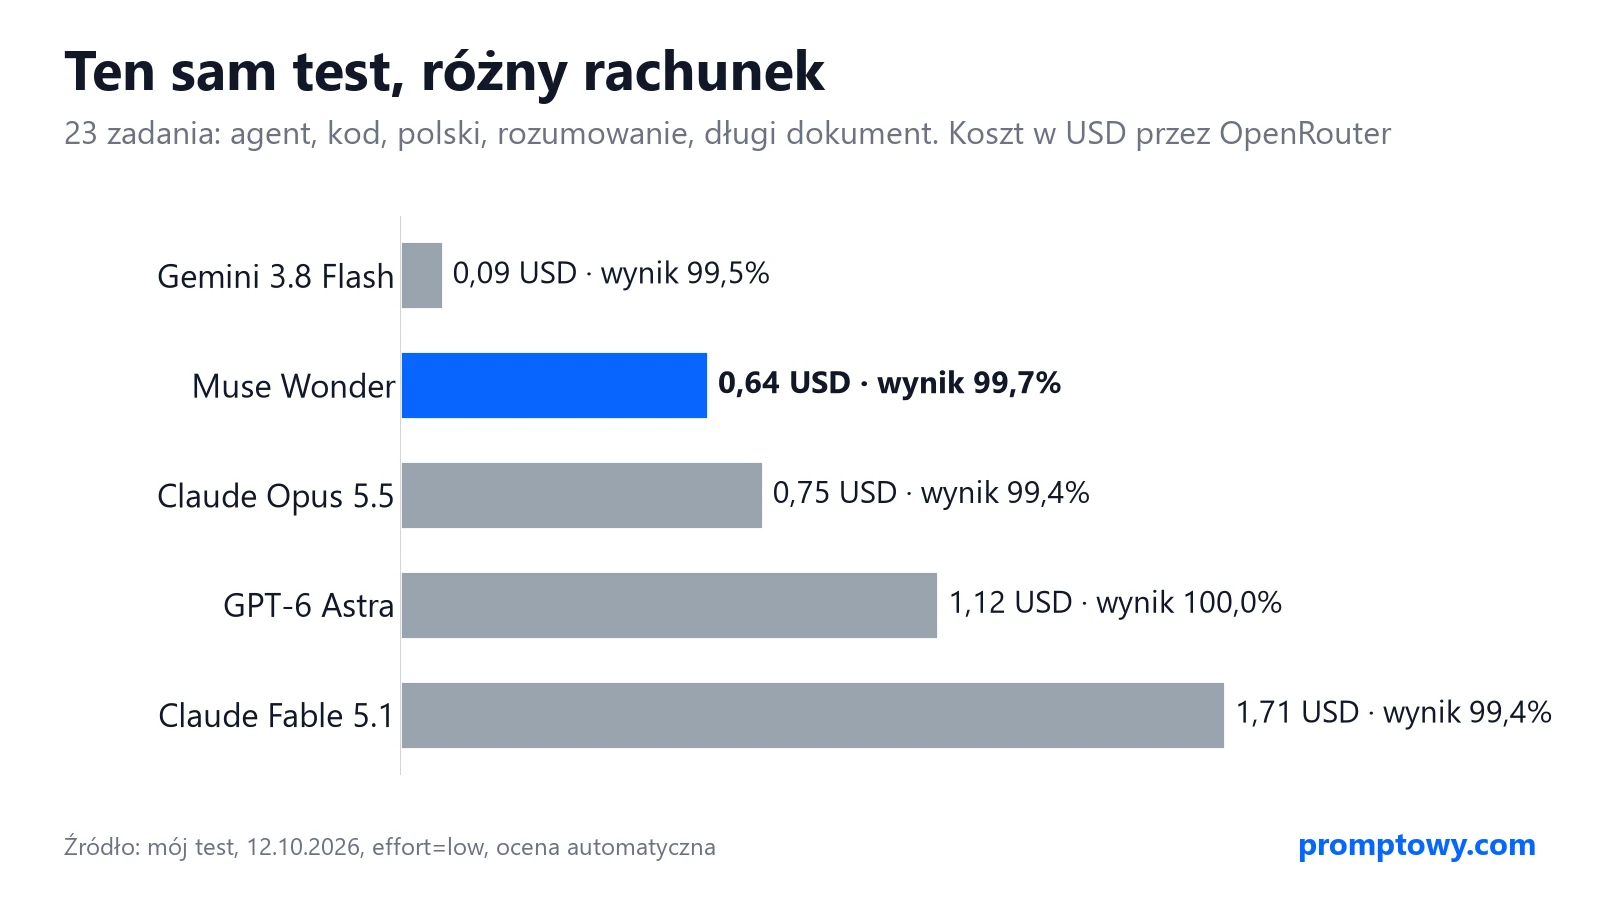
Sometí a Muse Wonder y a cuatro de sus principales rivales a las mismas 23 tareas: un agente con herramientas, código verificado mediante tests automáticos, redacción de documentos formales, razonamiento y un texto extenso de entre 47 000 y 88 000 tókenes. El resultado me sorprendió más que los propios benchmarks de Meta: en tareas prácticas, los cinco modelos obtuvieron entre un 99% y un 100%, y las diferencias reales aparecieron en la factura, el tiempo de respuesta y errores muy puntuales. Muse Wonder fue el segundo más barato y el segundo más rápido. A continuación tienes todos los datos, gráficos y fallos detectados, así como el análisis detallado del modelo en la guía sobre Muse Wonder.
Test realizado la tarde del 12 de octubre de 2026
- Modelos evaluados: Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra y Gemini 3.8 Flash. Todos ejecutados a través de OpenRouter con razonamiento configurado en nivel bajo (low).
- 23 tareas en dos rondas con evaluación automatizada (pruebas unitarias, validación de llamadas a herramientas y respuestas exactas), sin juez de IA.
- Prueba independiente de citas inventadas: 16 publicaciones por modelo, verificadas en Crossref y OpenAlex.
- Coste total del experimento: unos 4,51 EUR (5,04 USD; conversión según tipo de cambio de referencia del BCE del 12/10/2026: 1 EUR = 1,1181 USD, fuente: https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml). Registros y respuestas íntegras guardados en archivos.
Resultados de la comparativa
| Modelo | Puntuación (23 tareas) | Coste | Tiempo total | Fuentes reales | Fallos |
|---|---|---|---|---|---|
| Muse Wonder | 99,7% | aprox. 0,57 EUR (0,64 USD) | 165 s | 16/16 | errata en código (palabra inventada en numerales) |
| Claude Opus 5.5 | 99,4% | aprox. 0,67 EUR (0,75 USD) | 222 s | 16/16 | resumen por encima del límite de palabras |
| Claude Fable 5.1 | 99,4% | aprox. 1,53 EUR (1,71 USD) | 263 s | 16/16 | resumen por encima del límite de palabras |
| GPT-6 Astra | 100% | aprox. 1,00 EUR (1,12 USD) | 200 s | 16/16 | ninguno |
| Gemini 3.8 Flash | 99,5% | aprox. 0,08 EUR (0,09 USD) | 139 s | 7/16* | aplicó festivo de Nochebuena con retroactividad indebida a 2024 |
La puntuación es la media de las 23 tareas, todas con la misma ponderación (en tareas multicriterio se calcula el porcentaje cumplido). * Dato de Gemini 3.8 Flash obtenido en mi medición previa del 12 de octubre con el mismo prompt. Precios aproximados en EUR calculados con la tasa del BCE de 1 EUR = 1,1181 USD del 12/10/2026.
Pruebas realizadas en el test
| Categoría | Tareas | Criterio de evaluación |
|---|---|---|
| Agente con herramientas | planificación de viaje (3 herramientas, 4 condiciones, opciones trampa en precio), gestión de devolución en tienda (verificar si rechaza una devolución fuera de plazo), conversión de facturas en EUR con tipos de cambio oficiales y simulación de caída del servicio en la primera petición | precisión en las llamadas a herramientas, decisiones lógicas y resultado numérico exacto |
| Código | validación de identificación fiscal corporativa, fusión de intervalos, cálculo de días laborables con festivos legales recientes, conversión de cantidades numéricas a texto para facturación | pruebas unitarias ejecutadas en entorno local (de 8 a 19 casos por tarea) |
| Lenguaje y redacción | corrección de 10 errores ortotipográficos, resumen en 3 puntos de máximo 60 palabras, recurso administrativo ante la seguridad social, declinación y concordancia compleja de nombres propios (probado originalmente en polaco) | lista de control de elementos obligatorios y formas léxicas exactas |
| Razonamiento | 11 problemas con respuesta unívoca (combinatoria, cálculo de calendarios, acertijos lógicos de caballeros y escuderos) | solución exacta |
| Documento extenso | análisis de 80 actas de juntas directivas con 5 preguntas (incluyendo una decisión revocada en actas posteriores y una consulta sobre un dato inexistente) | respuestas exactas fundamentadas |
Conclusión principal: las tareas cotidianas ya no diferencian a los modelos
En la planificación del viaje, los cinco modelos ejecutaron las herramientas en paralelo (4 llamadas en 2 turnos), descartaron el vuelo económico que salía a horas intempestivas y el hotel con valoración mediocre de 7,4, calculando el importe exacto requerido. En la prueba de devoluciones, ninguno tramitó una solicitud presentada tras 32 días cuando el límite eran 30. En las facturas, todos reintentaron la consulta tras la caída de la API bancaria, ignoraron las facturas ya liquidadas y arrojaron el importe pendiente correcto. Además, todos detectaron que la información sobre cierta campaña en redes no figuraba en el documento y que la superficie del almacén se había modificado en un acta posterior. Es una excelente noticia para ti como usuario, aunque mala para el marketing de los proveedores: en tareas de este tipo pagas por la marca, no por una mayor eficacia.
Dónde se aprecian las diferencias reales
Coste: Muse Wonder resulta más económico que Opus pese a costar lo mismo por token
Las tarifas oficiales por token en Muse Wonder y Claude Opus 5.5 coinciden: 4 USD por millón de tókenes de entrada (aprox. 3,58 EUR) y 20 USD por millón de salida (aprox. 17,89 EUR; referencia BCE 12/10/2026). Sin embargo, Opus resultó un 18% más caro en el cómputo total. La razón se aprecia en la prueba del documento largo: el mismo texto de entrada (redactado originalmente en polaco) representó 46 929 tókenes para Meta, 53 511 para Gemini, 55 371 para GPT-6 Astra y 87 675 para los modelos de Anthropic. El tokenizador de Claude segmenta lenguas con caracteres especiales de forma menos eficiente, requiriendo casi el doble de tókenes que el de Meta. Al procesar textos largos en idiomas distintos al inglés, la diferencia en el presupuesto es notable: una consulta sobre las 80 actas costó unos 0,17 EUR (0,19 USD) en Muse Wonder, 0,31 EUR (0,35 USD) en Opus 5.5 y 0,79 EUR (0,88 USD) en Fable 5.1.
| Modelo | Tókenes para el mismo documento | Coste de la consulta al documento |
|---|---|---|
| Muse Wonder | 46 929 | aprox. 0,17 EUR (0,19 USD) |
| Gemini 3.8 Flash | 53 511 | aprox. 0,04 EUR (0,04 USD) |
| GPT-6 Astra | 55 371 | aprox. 0,62 EUR (0,69 USD) |
| Claude Opus 5.5 | 87 675 | aprox. 0,31 EUR (0,35 USD) |
| Claude Fable 5.1 | 87 675 | aprox. 0,79 EUR (0,88 USD) |
En tareas cortas ocurre lo contrario: Muse Wonder genera una cadena de pensamiento interna extensa incluso en nivel bajo (en la planificación del viaje produjo 636 tókenes de razonamiento frente a 46 de Opus), por lo que en preguntas breves aisladas puede resultar algo más caro que Opus.
Velocidad de procesamiento
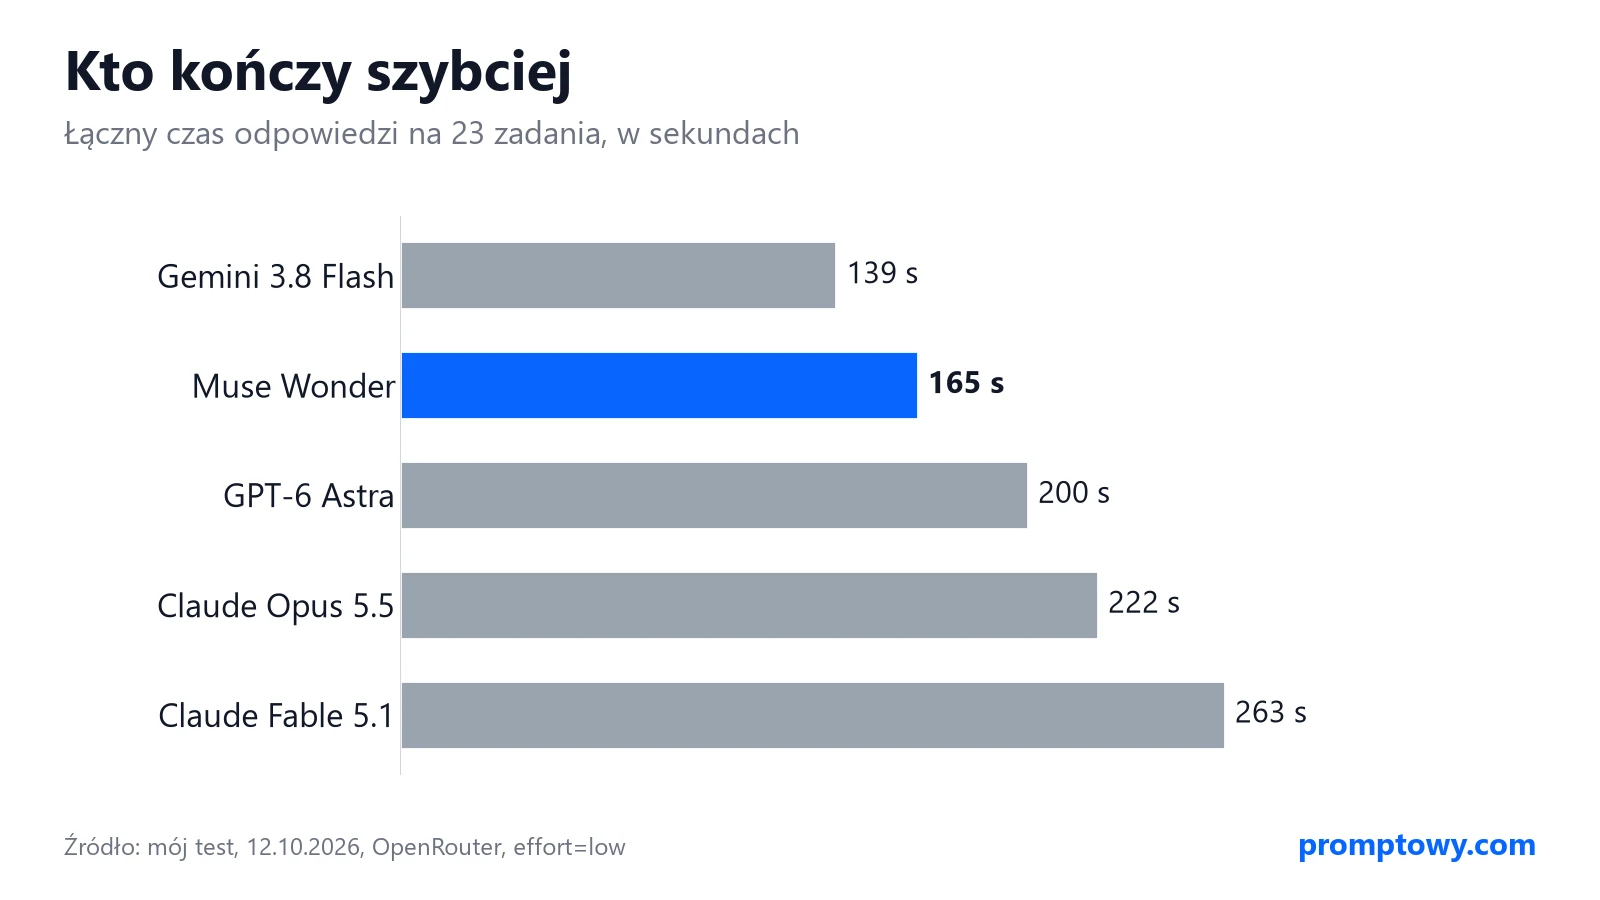
El modelo más lento fue Fable 5.1: necesitó 80 segundos y un coste de aprox. 0,25 EUR (0,28 USD) para redactar un escrito formal de recurso, mientras que Muse Wonder completó la misma tarea en 12 segundos por aprox. 0,03 EUR (0,03 USD).
Fallos detectados durante la evaluación
- Muse Wonder: término inexistente en código numérico.Al construir la función para transcribir números a letras, el modelo introdujo en la matriz un término inexistente (en el test original en polaco generó «grafía corrupta en el test original en polaco» en vez de «traducción del original en polaco: trece»). Superó 15 de las 16 pruebas unitarias, pero convirtió una cifra como 12,13 en una expresión errónea inaceptable para una factura oficial.
- Muse Wonder: fecha inventada en documento formal. En un borrador de escrito judicial introdujo la fecha fija «14 de octubre de 2026» sin haber sido proporcionada en el prompt. El resto de modelos dejó corchetes para rellenar. No le resté puntuación por ello, pero exige revisión humana obligatoria.
- Claude Opus 5.5 y Fable 5.1: superación del límite de palabras. El resumen debía contener como máximo 60 palabras; Opus generó 62 y Fable 66. Muse Wonder se ajustó exactamente a 60 y GPT-6 Astra a 59.
- Gemini 3.8 Flash: anacronismo legal en festivos. Añadió el 24 de diciembre como festivo en todos los años evaluados, omitiendo que en la legislación evaluada la norma entraba en vigor en 2025. El test unitario correspondiente a diciembre de 2024 falló.
Alucinación de referencias bibliográficas
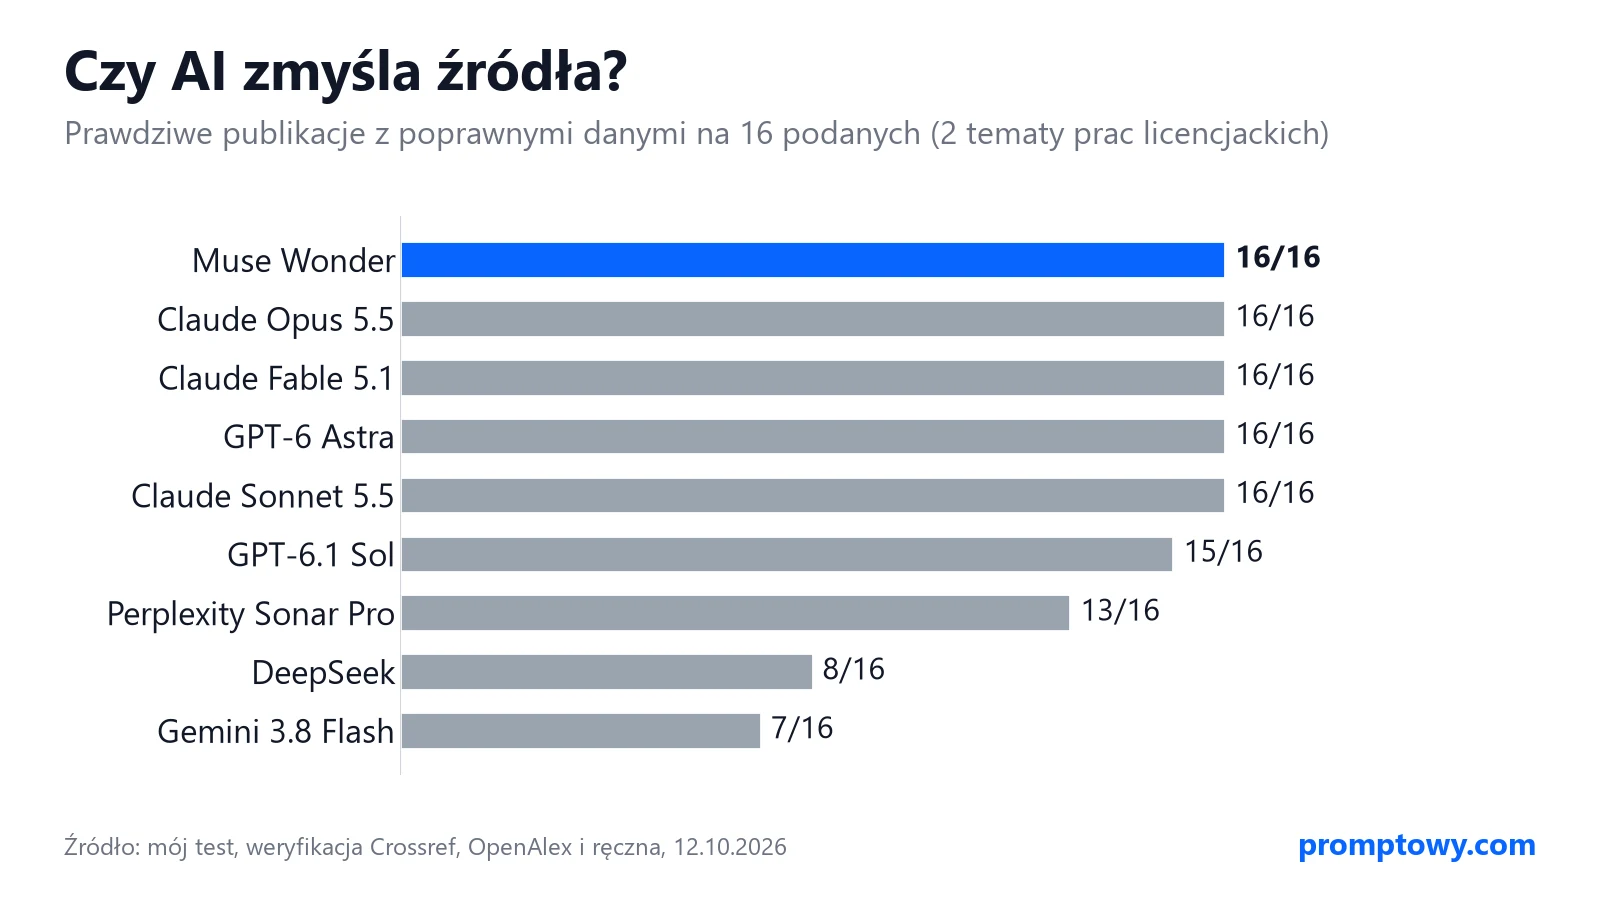
Solicité 8 publicaciones académicas para dos trabajos de fin de grado: el impacto de las redes sociales en adolescentes y la gestión de presupuestos participativos municipales. Contrasté cada referencia en Crossref y OpenAlex, revisando a mano cuatro documentos que no figuraban en los índices (informes sectoriales locales y un artículo de la revista francesa Métropoles). Todas existen en la realidad. Muse Wonder, Opus 5.5, Fable 5.1 y Astra aportaron 16 fuentes reales de 16. En cambio, en una prueba previa con el mismo prompt, Gemini 3.8 Flash solo identificó 7 referencias reales, inventando por completo las 7 restantes en la temática no anglosajona. Un modelo económico solventa tareas operativas comunes, pero no es fiable para recopilar bibliografía.
Puntos de comparación: benchmarks de Meta y redacción avanzada
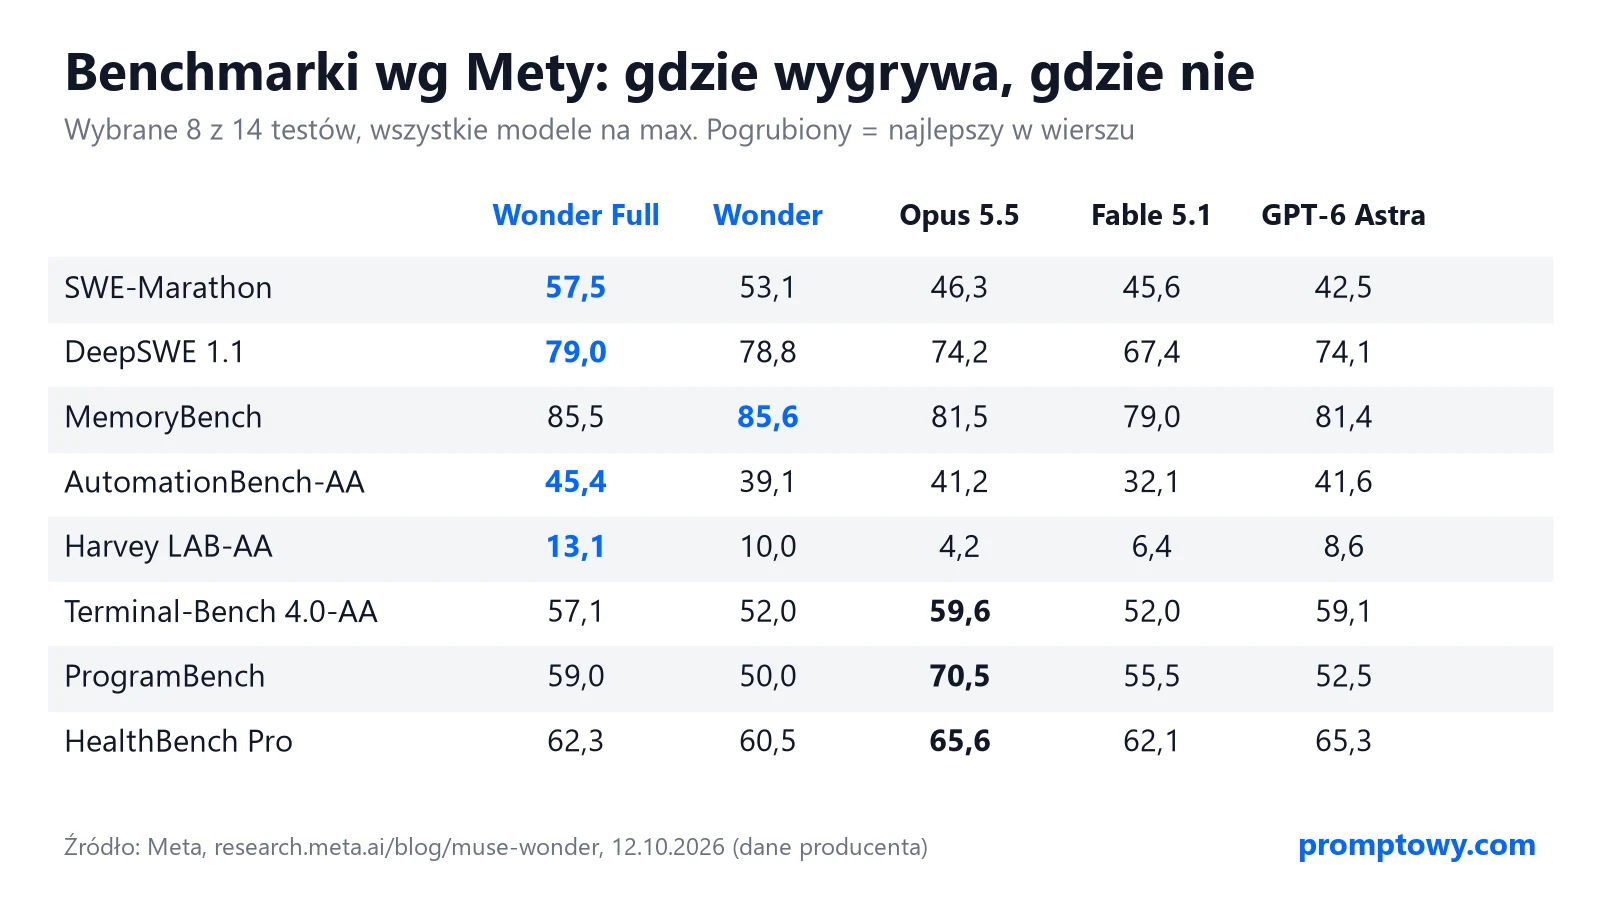
Meta muestra en sus tablas oficiales la ventaja de Muse Wonder Full en tareas extensas de ingeniería de software y agentes autónomos, cediendo terreno frente a Opus 5.5 en ProgramBench, Terminal-Bench y HealthBench Pro. Mi evaluación examinó la versión estándar de Muse Wonder disponible en la API comercial, y en tareas de escala empresarial cotidiana no se aprecia una brecha técnica definitiva entre ellos. En pruebas de redacción compleja con evaluación ciega de estilo, Muse Wonder registra 87,0 puntos, frente a los 90,1 de Opus 5.5, los 85,3 de Astra y los 83,9 de Fable 5.1 (tienes el desglose detallado en el análisis de Muse Wonder y rendimiento lingüístico).
Límites metodológicos del análisis
- Se realizó una única ejecución por tarea. Con precisiones situadas entre el 99% y el 100%, fallar un punto aislado responde a variabilidad estadística y no a una deficiencia estructural del modelo.
- El esfuerzo de razonamiento se fijó en nivel bajo (low) en todos los sistemas para estandarizar el consumo y el gasto. En niveles de razonamiento máximo, tanto las respuestas como los costes diferirían.
- Se trata de casos de uso operativos de oficina y desarrollo habitual, no de problemas límite. Para medir el techo técnico absoluto (proyectos de programación de días completos o matemáticas avanzadas) resultan más representativos índices globales como Artificial Analysis.
- La corrección automatizada evalúa hechos, sintaxis y formato lógico, sin ponderar la elegancia del estilo de redacción.
Balance
Si utilizas modelos de IA en producción a través de API para flujos de trabajo diarios que incluyan textos extensos en lenguas con caracteres especiales o estructura compleja, Muse Wonder ofrece una solvencia idéntica a la de Opus 5.5, Fable 5.1 o Astra, pero reduce el gasto notablemente gracias a la compresión de su tokenizador. Por otro lado, la mejor relación entre coste y rendimiento bruto en mi banco de pruebas sigue perteneciendo a Gemini 3.8 Flash, siempre que no dependas de él para extraer fuentes y referencias reales. Esta valoración corresponde a mi prueba empírica del 12 de octubre de 2026.
Preguntas frecuentes
¿Qué modelo obtuvo la mejor puntuación en la prueba?
GPT-6 Astra alcanzó el 100%, Muse Wonder el 99,7%, Gemini 3.8 Flash el 99,5%, y tanto Opus 5.5 como Fable 5.1 se situaron en el 99,4%. Las distancias se deben a fallos muy específicos y no a una diferencia técnica sustancial.
¿Es Muse Wonder más barato que Claude Opus 5.5?
Su precio nominal por token en la API es idéntico, pero el tokenizador de Muse Wonder es sensiblemente más eficiente en textos no anglosajones. En las 23 tareas del test, el gasto fue de unos 0,57 EUR (0,64 USD) con Muse Wonder frente a 0,67 EUR (0,75 USD) con Opus, y al consultar un documento largo la diferencia fue de 0,17 EUR (0,19 USD) frente a 0,31 EUR (0,35 USD).
¿Inventa referencias académicas Muse Wonder?
En este análisis no inventó ninguna: proporcionó 16 publicaciones científicas reales comprobadas sobre 16 solicitadas.
Fuentes y metodología
- Prueba realizada mediante OpenRouter el 12/10/2026: 23 tareas, parámetro effort=low, evaluación automatizada (tests unitarios locales, verificación de llamadas a herramientas y contraste de respuestas unívocas).
- Comprobación bibliográfica: validación en Crossref y OpenAlex, con 4 revisiones manuales en repositorios oficiales.
- Tarifas y catálogo de modelos en OpenRouter
- Meta AI Research: informe técnico y benchmarks de Muse Wonder
- Artificial Analysis: comparativas independientes de modelos
More on this from FULGOR

 benchmarks·Muse Wonder vs Claude Opus 5.5: comparativa técnicaComparamos a fondo Muse Wonder y Claude Opus 5.5 en precio, ventana de contexto y benchmarks.