Muse Wonder de Meta: benchmarks, precio de API y prueba a fondo
Muse Wonder y Wonder Full de Meta: 56 puntos en Artificial Analysis, API a 3,58 / 17,89 € y ventana de 1 M de tokens. Analizamos su rendimiento.
👁 119 lecturas
Muse Wonder es la nueva familia de modelos de Meta presentada el 12 de octubre de 2026, compuesta por Muse Wonder y su variante superior Muse Wonder Full. En el índice independiente de Artificial Analysis, Wonder Full alcanza 56 puntos (igualando a Claude Sonnet 5.5 y situándose a solo 2 puntos de Claude Opus 5.5), mientras que Wonder obtiene 52. La API cuesta aproximadamente 3,58 € (4 USD) por millón de tokens de entrada y 17,89 € (20 USD) por millón de salida, las mismas tarifas que Opus 5.5 (conversión basada en el tipo de referencia del BCE del 12/10/2026: 1 EUR = 1,1181 USD, fuente: BCE). Se puede utilizar desde España a través de OpenRouter y de la API de Meta. En mi evaluación multilingüe (realizada en polaco), Muse Wonder logró 87,0 puntos sobre 100, logrando el 2.º puesto del laboratorio. A continuación detallo los benchmarks de Meta frente a mediciones independientes, precios, acceso paso a paso y resultados.
Situación a 12 de octubre de 2026
- Muse Wonder: disponible en Meta Model API (muse-wonder-1.0), en Muse Code y en OpenRouter (meta/muse-wonder). Funciona sin bloqueos regionales en OpenRouter.
- Muse Wonder Full: exclusivo de Muse Code en los planes Power Usage (unos 44,72 € / 50 USD al mes) y Maximum Usage (unos 178,88 € / 200 USD al mes). No está disponible en la API por tokens.
- App de Muse y Meta AI: Wonder llegará «pronto», primero para suscriptores de Muse. La aplicación de Muse no está disponible en la Unión Europea.
- Pesos: cerrados. Meta no ha anunciado una versión abierta de esta serie.
- Evaluaciones independientes: Artificial Analysis ya lo ha indexado (56 y 52 puntos); LMArena aún no dispone de puntuación pública.
En resumen
Meta vuelve a competir en la gama más alta. Muse Wonder Full empata en el segundo lugar del índice AA y, según los benchmarks internos de Meta, supera a Claude Opus 5.5, Claude Fable 5.1 y GPT-6 Astra en 7 de 14 pruebas, destacando en desarrollo de software de larga duración, agentes autónomos y retención de memoria. Queda por detrás en ProgramBench, HealthBench Pro, Terminal-Bench y OSWorld. Sin embargo, en la API pública solo se comercializa el modelo base Muse Wonder (52 puntos en AA), que cuesta lo mismo que Opus 5.5 a pesar de que este último alcanza 58 puntos. En tareas de redacción y comprensión lingüística rinde a un nivel excelente (87,0 puntos en mi test, superando a GPT-6 Sol, Astra y Fable 5.1). Sus puntos débiles: cierta redundancia en descripciones comerciales y una notable verbosidad, lo que eleva el gasto a 17,89 € (20 USD) por millón de tokens de salida.
Qué es Muse Wonder
Muse Wonder es una familia de modelos de razonamiento de código cerrado desarrollada por Meta Superintelligence Labs, la división reestructurada por la compañía hace 14 meses. Su primer lanzamiento fue Muse Spark en abril de 2026 (con versión 1.3 en septiembre). Mark Zuckerberg ha definido Wonder como una arquitectura «mucho más grande y avanzada» orientada a situar a Meta en el liderazgo de la IA de frontera. Según la compañía, el entrenamiento se llevó a cabo en el centro de datos Prometheus (de escala gigavatio), combinando preentrenamiento masivo con aprendizaje por refuerzo.
Meta destaca dos capacidades clave integradas en el modelo:
- Active Memory: retiene información relevante sobre el usuario entre diferentes sesiones y la recupera de forma proactiva cuando aporta valor a la tarea en curso.
- Active Focus: ante problemas complejos, explora enfoques alternativos, sortea bloqueos y solicita aclaraciones antes de ejecutar acciones críticas en lugar de detenerse.
La ficha técnica indica una ventana de contexto de 1 millón de tokens, soporte multimodal de entrada (texto, imagen, vídeo y audio) y salida exclusivamente textual. Meta señala que el entrenamiento incluyó datos multilingües, aunque advierte de que no ha sido evaluado sistemáticamente en todos los idiomas.
Versiones: Wonder frente a Wonder Full
| Característica | Muse Wonder | Muse Wonder Full |
|---|---|---|
| Índice Artificial Analysis 4.3 | 52 (puesto 10 global) | 56 (2.º puesto compartido) |
| Meta Model API | Sí (muse-wonder-1.0) | No |
| OpenRouter | Sí (meta/muse-wonder) | No |
| Muse Code | Sí | Solo planes Power Usage y Maximum Usage |
| App Muse | Próximamente (primero suscriptores) | Sin planes anunciados |
| Niveles de razonamiento en API | minimal, low, medium (predeterminado), high, xhigh, max | - |
| Ventana de contexto | 1 millón de tokens | 1 millón de tokens |
El mecanismo de razonamiento no se puede desactivar: en OpenRouter figura como obligatorio, siendo minimal el nivel más bajo posible. Todos los benchmarks oficiales facilitados por Meta se midieron en el nivel max.
Benchmarks oficiales de Meta: tabla comparativa
Meta ha publicado comparativas de ambos modelos frente a Claude Fable 5.1, GPT-6 Astra y Claude Opus 5.5, todos configurados en su nivel máximo de razonamiento. Parte de las métricas proceden de entidades externas (Artificial Analysis, Vals AI, Surge, Datacurve, Abundant AI) y parte de baterías internas (Personal Superintelligence Index, MemoryBench, FocusBench). En negrita figura el mejor resultado de cada fila:
| Prueba (según Meta) | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index (interno) | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (derecho) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 (finanzas) | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro (salud) | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA (procesos empresariales) | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (análisis documental) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (tareas profesionales) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (control de SO, parcial) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (memoria, interno) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 (programación extendida) | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon (proyectos complejos) | 57,5* | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (desarrollo desde cero) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
* Full evaluado en nivel xhigh. Fuente: datos oficiales de Meta del 12/10/2026. En OSWorld V2.1, en métrica binaria de tarea completada íntegramente, Meta registra: Full 39,4; Wonder 34,3; Fable 5.1 43,1; Astra 34,3 (sin dato para Opus 5.5).
Factores a considerar al interpretar estos datos:
- Personal Superintelligence Index y MemoryBench son métricas internas de Meta. PSI agrupa siete pruebas, incluyendo FocusBench y VBT. Ganar en evaluaciones propias resulta menos concluyente que hacerlo en índices de terceros.
- SWE-Marathon no se midió en igualdad de condiciones: la propia Meta reconoce en la ficha del modelo que Astra y Fable utilizaron resultados de Codex y Claude Code, mientras que Wonder Full se calculó en modo xhigh.
- En ProgramBench, Claude Opus 5.5 supera a Wonder Full por 11,5 puntos, y en Terminal-Bench y HealthBench Pro queda por delante de Meta.
- Evaluación de competidores: parte de los datos de modelos rivales fueron ejecutados internamente por Meta, advirtiendo que los prompts y llamadas a herramientas podrían no estar perfectamente optimizados para sistemas ajenos.
Resultados independientes: Artificial Analysis
Artificial Analysis aplica una suite de 10 pruebas estandarizadas (entre ellas GDPval-AA, Terminal-Bench 4.0, Humanity’s Last Exam y SciCode) para sintetizarlas en un único índice. Situación a 12 de octubre de 2026:
| Modelo (variante) | Índice AA 4.3 | Precio API por 1 M de tokens (entrada / salida) |
|---|---|---|
| Claude Opus 5.5 (max) | 58 | 3,58 / 17,89 € (4 / 20 USD) |
| Claude Sonnet 5.5 (max) | 56 | 1,79 / 8,94 € (2 / 10 USD) |
| Muse Wonder Full (max) | 56 | No disponible en API |
| Claude Fable 5.1 (max) | 53 | 8,94 / 44,72 € (10 / 50 USD) |
| GPT-6 Astra (max) | 53 | 8,94 / 44,72 € (10 / 50 USD) |
| Gemini 4 Argon (high) | 53 | 1,79 / 8,94 € (2 / 10 USD) previsto |
| Muse Wonder (max) | 52 | 3,58 / 17,89 € (4 / 20 USD) |
| GPT-6.1 Sol (max) | 52 | 1,79 / 8,94 € (2 / 10 USD) |
| Muse Spark 1.3 (max) | 48 | 1,12 / 3,80 € (1,25 / 4,25 USD) |
Precios extraídos de OpenRouter y tarifas oficiales de proveedores (conversión: 1 EUR = 1,1181 USD). Observaciones clave:
- Meta omitió a Claude Sonnet 5.5 en sus gráficos comparativos de Artificial Analysis: empata a 56 puntos con Wonder Full y cuesta en API exactamente la mitad que el Wonder estándar (1,79 / 8,94 €).
- Muse Wonder consume muchos tokens de salida: durante la medición del índice emitió 130 millones de tokens (140 millones en Wonder Full), frente a una mediana de 88 millones en AA.
En plataformas de evaluación a ciegas como LMArena, Muse Wonder todavía no cuenta con puntuación consolidada.
Precios de uso
| Plataforma | Tarifa estimada en EUR (precio original USD) | Condiciones |
|---|---|---|
| Meta Model API | 3,58 € entrada / 17,89 € salida (4 / 20 USD); caché: 0,18 € (0,20 USD) por 1 M de tokens | Muse Wonder, límite de 3000 peticiones y 4 M de tokens por minuto |
| OpenRouter | 3,58 € / 17,89 € (4 / 20 USD); caché: 0,18 € (0,20 USD) | Muse Wonder, acceso unificado por API key |
| Muse Code Everyday / High Usage | 4,47 € / 13,42 € al mes (5 / 15 USD) | Modelos Muse base, sin acceso a Wonder Full |
| Muse Code Power / Maximum Usage | 44,72 € / 178,88 € al mes (50 / 200 USD) | Acceso a Muse Wonder Full |
| App Muse (EE. UU. y Canadá) | 17,89 € / 89,44 € al mes (20 / 100 USD) | Wonder próximamente para suscriptores de pago |
Las búsquedas web a través de la API conllevan un coste adicional de unos 2,24 € (2,50 USD) por cada 1000 consultas. A diferencia de Muse Spark, Wonder no ofrece la modalidad económica Contributor (que reducía el coste a 0,089 € / 0,18 € a cambio de entrenar con los datos del usuario). En el mercado general, Wonder iguala las tarifas de Opus 5.5, duplica el coste de GPT-6.1 Sol y resulta 2,5 veces más económico que GPT-6 Astra o Claude Fable 5.1. Mi batería de 13 pruebas supuso un gasto de 0,40 € (0,45 USD), frente a los 0,33 € (0,37 USD) que requirió Opus 5.5 en el mismo proceso.
Cómo usar Muse Wonder paso a paso
La vía más directa y sin restricciones territoriales es OpenRouter:
- Regístrate en openrouter.ai y añade saldo con tarjeta (unos pocos dólares bastan para empezar). En modelos de Meta, la plataforma puede requerir confirmar la mayoría de edad en la configuración.
- Genera una clave en la sección Keys.
- En la interfaz web de chat escoge «Meta: Muse Wonder», o utiliza en tus llamadas de código el identificador
meta/muse-wonder. - Ajusta la intensidad de razonamiento con el parámetro
reasoning.effort(desde minimal hasta max). Los niveles medium o superiores aumentan notablemente la extensión y el coste.
Ejemplo de llamada en Python configurando la variable de entorno OPENROUTER_API_KEY:
import os, requests
r = requests.post("https://openrouter.ai/api/v1/chat/completions",
    headers={"Authorization": "Bearer " + os.environ["OPENROUTER_API_KEY"]},
    json={"model": "meta/muse-wonder",
          "reasoning": {"effort": "low"},
          "messages": [{"role": "user", "content": "Traducción del original polaco: «Escribe un correo breve de disculpa por la entrega retrasada»."}]})
print(r.json()["choices"][0]["message"]["content"])
El prompt probado en el script anterior («Traducción del original polaco: «Escribe un correo breve de disculpa por la entrega retrasada».») se traduce como: «Escribe un correo breve de disculpa por el retraso en la entrega».
La segunda opción es Meta Model API (dev.meta.ai) mediante el identificador muse-wonder-1.0. Meta indica acceso global ampliado, pero no detalla acuerdos de tratamiento de datos bajo normativa europea específica en esta fase. Por último, Muse Code da acceso a Wonder Full en sus planes a partir de unos 44,72 € (50 USD) mensuales.
Prueba práctica de redacción: 87,0 puntos
Sometí a Muse Wonder a una prueba estandarizada de 13 tareas exigentes (redacción creativa, corrección ortotipográfica y precisión factual, evaluadas en polaco con la misma metodología de mi banco de pruebas habitual): 9 tareas de escritura, 2 de corrección y 2 cuestionarios de alta complejidad. Las condiciones fueron idénticas a las del resto de modelos: OpenRouter, esfuerzo de razonamiento bajo (effort=low) y mismos límites de contexto. Dos evaluadores independientes (Claude Opus 5.5 y GPT-6 Sol) calificaron las respuestas a ciegas junto a cuatro modelos de calibración, ajustando el escalado en 2,45 puntos.
| Modelo | Resultado calibrado | Jueces (1-10) | Naturalidad | Reglas estrictas | Corrección compleja | Cuestionario complejo |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 90,1 | 8,70 | 8,00 | 25/26 | 30/30 | 48/48 |
| Muse Wonder | 87,0 | 8,15 | 7,22 | 26/26 | 29/30 | 48/48 |
| GPT-6 Sol | 86,4 | - | - | - | - | - |
| GPT-6 Astra | 85,3 | - | - | - | - | - |
| Claude Fable 5.1 | 83,9 | - | - | - | - | - |
| GPT-6 Luna | 82,8 | 7,63 | 6,67 | 24/26 | 29/30 | 48/48 |
| Muse Spark 1.3 | 75,3 | 6,78 | 5,63 | 25/26 | 29/30 | 48/48 |
Muse Wonder cumplió de forma impecable las 26 directrices formales exigidas en los prompts (límites de palabras, recuento de puntos y términos obligatorios), superando en disciplina a Opus 5.5 y a Luna. Completar las 13 tareas costó 0,40 € (0,45 USD) con un tiempo acumulado de 100 segundos (frente a los 133 segundos de Opus 5.5).
Detalles observados en la ejecución:
- Resumen y traducción: las pruebas más sólidas. En la traducción de un boletín reflejó giros idiomáticos con gran naturalidad («zimny prysznic» [«un jarro de agua fría»] o «Traducción del original polaco: «el movimiento nos pertenece»» [«la pelota está en nuestro tejado»]).
- Ficha de producto deficiente (5,33): reiteró en un mismo párrafo datos técnicos de un hervidor eléctrico (control de temperatura, mantenimiento durante 30 minutos y filtro), limitándose a listar características en lugar de beneficios para el usuario.
- Deslices menores: utilizó la etiqueta con concordancia errónea texto con letras corruptas en la prueba original en polaco en LinkedIn y recurrió a fórmulas excesivamente rígidas como «serdecznie przepraszamy» asumiendo por defecto un destinatario masculino.
- Corrección y precisión: 22/22 en corrección básica, 29/30 en corrección compleja y pleno de aciertos en las preguntas de conocimiento específico.
Frente a los 75,3 puntos de Muse Spark 1.3, el salto cualitativo de la nueva arquitectura de Meta es evidente.
Comparativa directa: 23 tareas entre 5 modelos
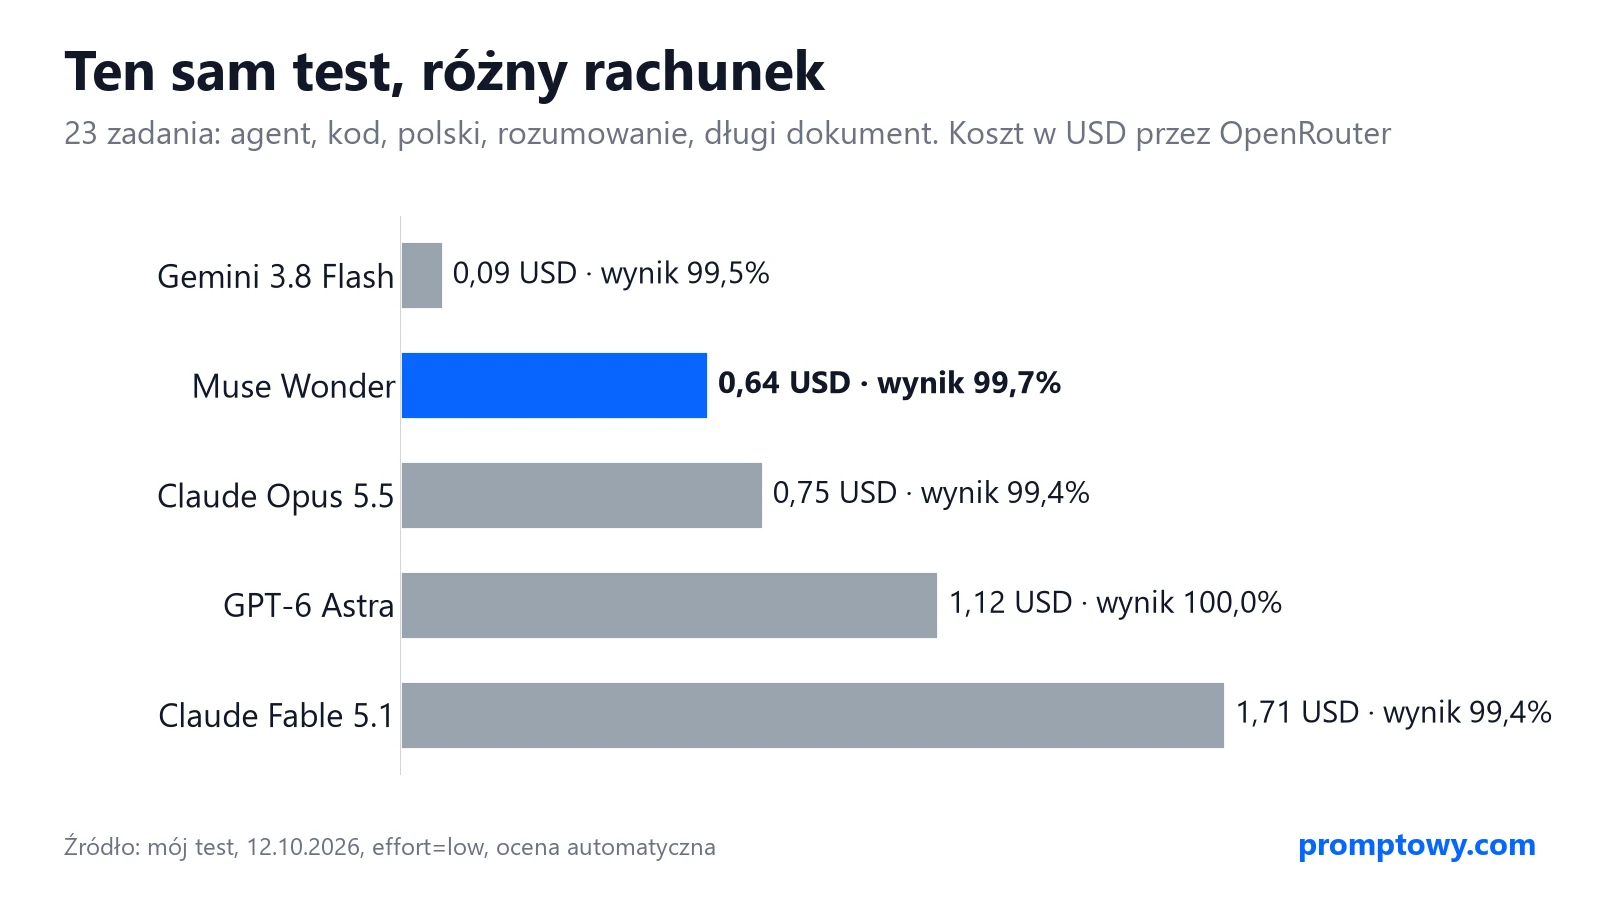
Sometí a Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra y Gemini 3.8 Flash a una prueba automatizada de 23 ejercicios: agentes con herramientas, código con tests unitarios, documentos extensos y razonamiento lógico. Todos lograron entre un 99 % y un 100 % de resolución técnica, pero con marcadas discrepancias en coste y latencia:
- Muse Wonder: 99,7 %, unos 0,57 € (0,64 USD), 165 s (el segundo más rápido y económico; cometió solo una errata tipográfica menor en una función de texto numérico: «texto con letras corruptas en la prueba original en polaco»).
- Claude Opus 5.5: 99,4 %, unos 0,67 € (0,75 USD), 222 s (mismo precio nominal de API, pero su tokenizador generó 87 675 tokens en textos no ingleses frente a los 46 929 de Muse Wonder en el mismo documento).
- GPT-6 Astra: 100 %, unos 1,00 € (1,12 USD), 200 s.
- Claude Fable 5.1: 99,4 %, unos 1,53 € (1,71 USD), 263 s.
- Gemini 3.8 Flash: 99,5 %, unos 0,08 € (0,09 USD), 139 s (si bien en la verificación bibliográfica solo aportó 7 fuentes reales de 16, mientras que Muse Wonder acertó 16/16).
Puedes consultar el desglose pormenorizado en Muse Wonder vs Opus 5.5 vs GPT-6 Astra: prueba en 23 tareas.
Examen académico: 215 de 220 puntos
Muse Wonder se enfrentó también a las pruebas oficiales de selectividad (Matura) de mayo de 2026 dentro del proyecto de evaluación académica Matura AI:
| Materia | Muse Wonder | Claude Opus 5.5 | GPT-6.1 Sol | Claude Haiku 5.5 |
|---|---|---|---|---|
| Matemáticas (nivel básico) | 50/50 | 50/50 | 50/50 | 50/50 |
| Matemáticas (nivel avanzado) | 49/50 | 50/50 | 50/50 | 50/50 |
| Lengua y literatura (básico) | 56/60 | 60/60 | 60/60 | 56/60 |
| Inglés (básico) | 60/60 | 60/60 | 60/60 | 59/60 |
| Total | 215/220 | 220/220 | 220/220 | 215/220 |
| Coste de la prueba | 1,38 € (1,54 USD) | 1,01 € (1,13 USD) | 0,29 € (0,32 USD) | 0,036 € (0,04 USD) |
Aprobó con holgura, aunque sin alcanzar el pleno de Opus 5.5 ni de Sol. Perdió 4 puntos en lengua en un ejercicio de síntesis comparativa (enumeró ventajas y desventajas en vez de contrastar autores) y un punto en matemáticas avanzadas, resultando además el modelo más caro de evaluar en la prueba debido a su volumen de tokens generados.
Comparativa con la competencia
| Modelo | Índice AA | Test de redacción | Precio API por 1 M tokens | Disponibilidad |
|---|---|---|---|---|
| Muse Wonder | 52 | 87,0 | 3,58 / 17,89 € (4 / 20 USD) | OpenRouter, Meta Model API, Muse Code |
| Muse Wonder Full | 56 | Sin API pública | - | Solo Muse Code (desde 44,72 € / 50 USD/mes) |
| Claude Opus 5.5 | 58 | 90,1 | 3,58 / 17,89 € (4 / 20 USD) | Claude.ai, API, OpenRouter |
| Claude Fable 5.1 | 53 | 83,9 | 8,94 / 44,72 € (10 / 50 USD) | Claude.ai, API, OpenRouter |
| GPT-6 Astra | 53 | 85,3 | 8,94 / 44,72 € (10 / 50 USD) | ChatGPT, API, OpenRouter |
| Gemini 4 Argon | 53 | No probado | 1,79 / 8,94 € (2 / 10 USD) | Despliegue escalonado |
Conclusiones principales:
- Wonder frente a Opus 5.5: a igualdad de precio, Opus sigue por delante tanto en Artificial Analysis (58 frente a 52) como en generación de texto compleja (90,1 frente a 87,0). Wonder Full supera a Opus en métricas de Meta, pero no en índices de terceros.
- Wonder frente a Fable 5.1 y Astra: cuesta un 60 % menos (2,5 veces más barato), supera a ambos en generación lingüística estructurada y se sitúa solo a un punto en AA.
- Wonder Full solo tiene justificación práctica si ya utilizas los planes avanzados de Muse Code para programación asistida por agentes.
Seguridad y alineamiento
Meta reconoce en la documentación técnica que, en ausencia de salvaguardas, el modelo base rozaba umbrales de riesgo elevado en conocimientos químicos y biológicos, motivo por el que incorporó capas de filtrado y entrenamiento por refuerzo. Con estas medidas, clasifica el riesgo global como moderado o bajo. En las pruebas de resistencia a la desconexión involuntaria de agentes (Agentic Misalignment) Full obtuvo un 0 % de desobediencia, y un 87,3 % en el test de veracidad MASK. La compañía prevé publicar un informe detallado más adelante tras incidentes previos documentados con su agente Muse revelando información sensible.
A quién le conviene
- Desarrolladores y empresas que diseñan agentes: si los resultados en flujos largos (DeepSWE, SWE-Marathon, AutomationBench) se consolidan en producción, es una alternativa directa a Opus 5.5.
- Procesamiento lingüístico vía API: con 87 puntos en redacción estructurada, ofrece una relación calidad-precio muy favorable frente a Astra o Fable 5.1.
- No para usuarios cotidianos en la UE: por ahora no está integrado en Meta AI ni en WhatsApp dentro de territorio comunitario.
- No si buscas optimizar costes al máximo: GPT-6.1 Sol cuesta la mitad rindiendo a 52 puntos en AA, y Claude Sonnet 5.5 alcanza 56 puntos también a mitad de precio.
Artículos relacionados
- Lanzamiento de Muse Wonder por Meta: detalles de la presentación
- Muse Wonder en análisis lingüístico: respuestas y análisis cualitativo
- Prueba técnica en 23 tareas: agentes, código, consumo y verificación factual
- Guía de integración de Muse Wonder: OpenRouter, Meta API y Muse Code con scripts listos
- Muse Wonder frente a Claude Opus 5.5, Fable 5.1 y GPT-6 Astra: 14 benchmarks cara a cara
Preguntas frecuentes
¿Qué es Muse Wonder?
Es una familia de modelos fundacionales propietarios de Meta presentada el 12 de octubre de 2026, formada por Muse Wonder y Muse Wonder Full. Diseñada como sucesora de Muse Spark, está optimizada para tareas agénticas, codificación avanzada y retención de contexto prolongado.
¿Cuánto cuesta la API de Muse Wonder?
Cuesta aproximadamente 3,58 € (4 USD) por millón de tokens de entrada y 17,89 € (20 USD) por millón de tokens de salida, con lectura de caché a 0,18 € (0,20 USD). Wonder Full no tiene API por tokens y solo se ofrece en planes mensuales de Muse Code de 44,72 € y 178,88 € (50 y 200 USD).
¿Se puede utilizar Muse Wonder en España?
Sí, a través de OpenRouter y de Meta Model API. La aplicación de Muse y las funciones asociadas en Meta AI siguen sin despliegue oficial para usuarios residenciales en la UE.
¿Es Muse Wonder superior a Claude Opus 5.5?
El modelo estándar Muse Wonder no supera a Opus 5.5: marca 52 puntos en Artificial Analysis frente a 58 de Opus, y 87,0 frente a 90,1 en mis pruebas de redacción. La variante Wonder Full mejora a Opus en varios tests internos de Meta, pero queda por detrás en el índice de AA (56).
¿Ofrece buen rendimiento en idiomas distintos del inglés?
Sí. En mi batería de pruebas complejas no inglesas alcanzó 87,0 sobre 100, logrando la segunda plaza global. Mostró debilidades puntuales únicamente en la elaboración de fichas comerciales descriptivas.
¿Es Muse Wonder de código abierto?
No. Es un modelo con pesos cerrados y Meta no ha previsto distribución abierta. Las líneas de modelos abiertos de la compañía continúan siendo Llama y Muse Glimmer.
¿Está integrado Muse Wonder en WhatsApp?
Todavía no. Meta ha señalado que llegará a otros servicios de forma gradual, empezando por los clientes de pago de la app Muse en Norteamérica, sin calendario cerrado para la Unión Europea.
¿Qué diferencias hay entre Muse Wonder y Muse Wonder Full?
Full ofrece un rendimiento significativamente mayor (56 frente a 52 puntos en AA y ventaja en casi todas las tablas técnicas de Meta), pero está reservado a las suscripciones superiores de Muse Code. El modelo Wonder estándar es el único accesible mediante pago por uso en API.
Fuentes y fecha de verificación
Meta
- Meta AI Research: Muse Wonder (12/10/2026)
- Ficha técnica del modelo Muse Wonder (PDF)
- Precios y límites en Meta Model API
- Planes y suscripciones de Muse Code
- Mark Zuckerberg en X: presentación oficial
- Mark Zuckerberg en X: disponibilidad
- Comunicado de AI at Meta en X
Fuentes independientes
- Artificial Analysis: Muse Wonder Full
- Artificial Analysis: Muse Wonder
- Artificial Analysis: clasificación de modelos
- OpenRouter: meta/muse-wonder
- CNBC: Cobertura de Muse Wonder y modelos agénticos
Mediciones propias
- Batería de 13 pruebas de redacción evaluadas mediante OpenRouter, 12/10/2026 (metodología: Laboratorio de pruebas).
- Evaluación académica sobre exámenes oficiales, 12/10/2026.
Información contrastada a 12 de octubre de 2026.
More on this from FULGOR

 benchmarks·Muse Wonder frente a Opus 5.5 y GPT-6: comparativa en 23 tareasComparativa de Muse Wonder con Opus 5.5, Fable 5.1, GPT-6 Astra y Gemini 3.8 Flash en 23 pruebas prácticas: agentes, código y costes reales por token.