Gemini 4 Argon: test y comparativa frente a Opus 5.5 y GPT-6
Analizamos Gemini 4 Argon en 23 tareas reales frente a Claude Opus 5.5 y GPT-6 Astra: 99,5% de acierto, gran rapidez y un coste imbatible de 0,22 USD.
Actualización (9 de noviembre de 2026): ya han salido Claude Fable 5.2 y Mythos 5.2 - precios, acceso y benchmarks en mi guía de Claude Fable 5.2.
👁 126 lecturas
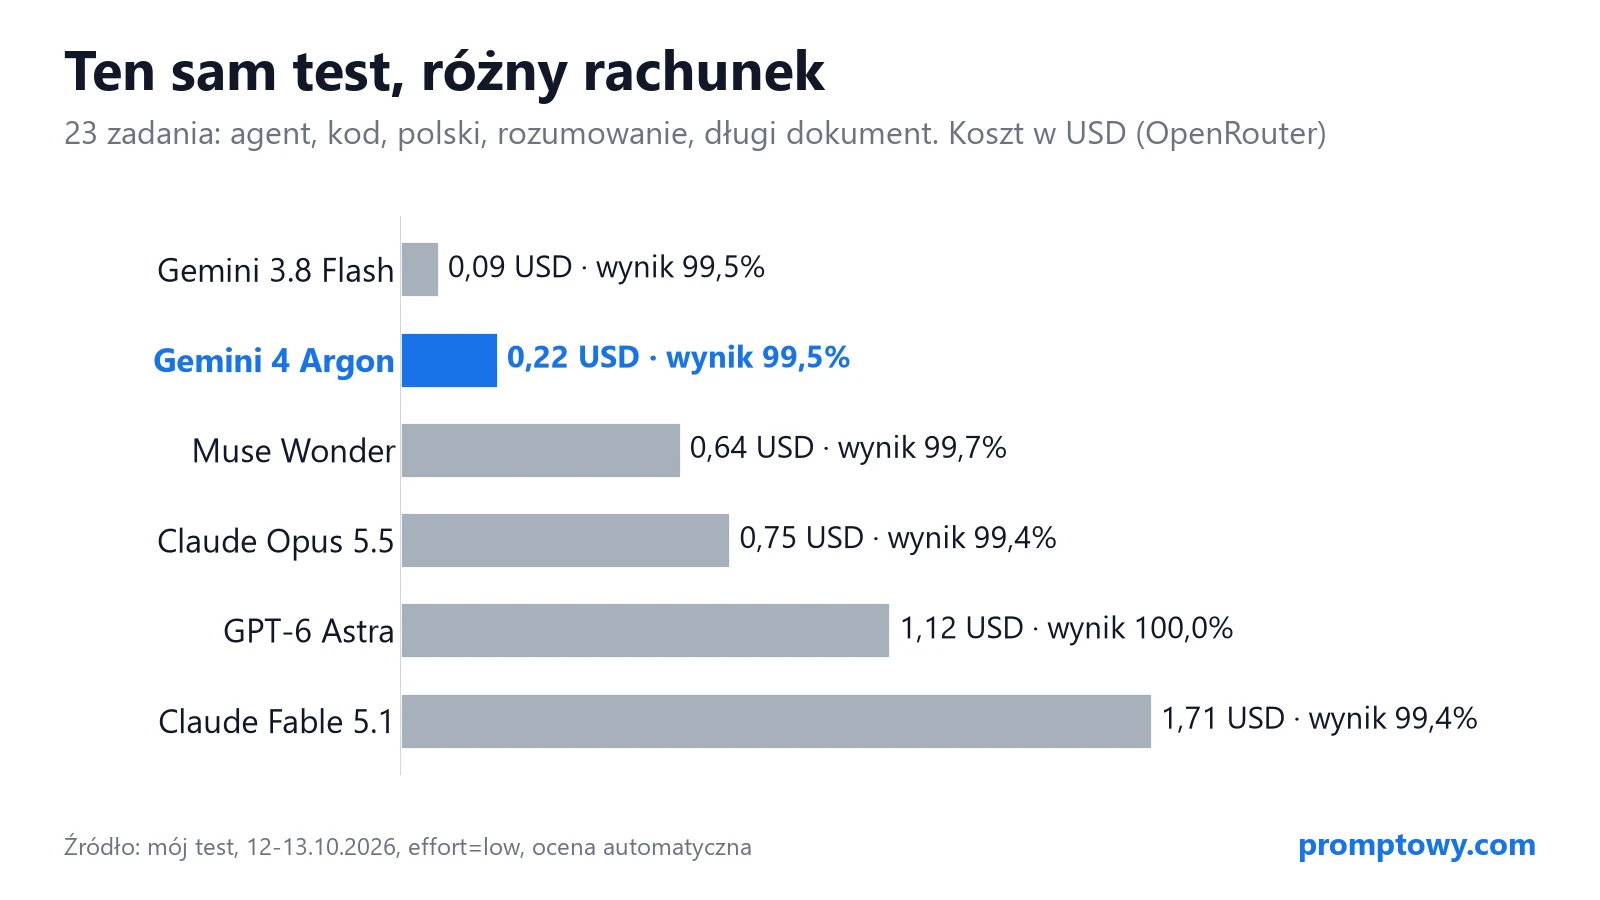
El 13 de octubre de 2026 por la tarde, media hora después de que Google abriera el acceso a Gemini 4 Argon para los usuarios de pago, lo sometí a la misma batería de 23 tareas que el día anterior habían completado Muse Wonder, Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra y Gemini 3.8 Flash. Argon alcanzó un 99,5% de precisión, costó aprox. 0,20 EUR (0,22 USD; conversiones según el tipo de referencia del BCE del 12/10/2026: 1 EUR = 1,1181 USD, https://www.ecb.europa.eu/stats/eurofxref/eurofxref-daily.xml) y fue el más rápido de todos: 135 segundos para todo el conjunto. El único punto que perdió resultó ser un error en mi script de evaluación, aunque el verdadero fallo estuvo en el mismo escrito, unos párrafos más abajo. Tienes todos los detalles del modelo, precios y disponibilidad en la guía sobre Gemini 4 Argon.
Prueba del 13 de octubre de 2026, tarde
- Modelo:
google/gemini-4-argonvía OpenRouter, nivel de razonamiento en low. - Rivales: las mismas 23 tareas, el mismo código y la misma configuración, ejecutados el 12 de octubre en la prueba de Muse Wonder.
- Evaluación automática: pruebas unitarias, verificación de llamadas a herramientas y respuestas exactas. Sin juez basado en IA. Cada punto perdido se revisó manualmente.
- Coste total de Argon en el test: aprox. 0,20 EUR (0,22 USD) a precio de lanzamiento (2/10 USD por millón de tokens).
Resultados en una tabla
| Modelo | Resultado (23 tareas) | Coste | Tiempo total |
|---|---|---|---|
| Gemini 4 Argon | 99,5% | aprox. 0,20 EUR (0,22 USD) | 135 s |
| Muse Wonder | 99,7% | aprox. 0,57 EUR (0,64 USD) | 165 s |
| Claude Opus 5.5 | 99,4% | aprox. 0,67 EUR (0,75 USD) | 222 s |
| GPT-6 Astra | 100% | aprox. 1,00 EUR (1,12 USD) | 200 s |
| Claude Fable 5.1 | 99,4% | aprox. 1,53 EUR (1,71 USD) | 263 s |
| Gemini 3.8 Flash | 99,5% | aprox. 0,08 EUR (0,09 USD) | 139 s |
La puntuación es la media de 23 tareas con idéntico peso. En aquellas con múltiples criterios se mide el porcentaje de requisitos cumplidos. Entre los modelos punteros, Argon es con diferencia el más económico: 3,4 veces más barato que Claude Opus 5.5, 5 veces más barato que GPT-6 Astra y 2,9 veces más barato que Muse Wonder. Solo Gemini 3.8 Flash resultó más económico, tratándose de un modelo de menor gama.
Qué analizamos en la prueba
| Categoría | Tareas | Criterio de evaluación |
|---|---|---|
| Agente con herramientas (3) | Viaje a Lisboa con 3 herramientas y trampas de precio, devolución de calzado fuera de plazo en tienda, cálculo de facturas en EUR con tipos de cambio oficiales y simulación de caída del servicio en la primera consulta | Corrección de llamadas, decisiones tomadas y resultado numérico |
| Código (4) | Validación de identificación fiscal, fusión de intervalos, cálculo de días laborables según calendario legal con festivos específicos y formateo de importe monetario en texto para facturación | 51 pruebas unitarias ejecutadas en local |
| Lenguaje natural (4) | Corrección de 10 erratas complejas, resumen estructurado en 3 puntos limitado a 60 palabras, recurso administrativo contra una denegación de pensión y declinaciones complejas en polaco (probado en polaco) | Lista de comprobación y coincidencia formal exacta |
| Razonamiento (11) | Combinatoria, problemas de calendario, agujas del reloj y acertijos lógicos de caballeros y escuderos | Respuesta exacta |
| Documento extenso (1) | 80 actas corporativas con 158 111 caracteres (evaluadas en polaco), 5 preguntas complejas incluyendo una decisión modificada en un acta posterior y una consulta sobre información inexistente en el texto | Respuestas exactas |
Comparativa por categorías
| Categoría | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Agente | 100%, aprox. 0,022 EUR (0,025 USD) | 100%, aprox. 0,081 EUR (0,091 USD) | 100%, aprox. 0,089 EUR (0,100 USD) |
| Código | 100%, aprox. 0,025 EUR (0,028 USD) | 100%, aprox. 0,074 EUR (0,083 USD) | 100%, aprox. 0,116 EUR (0,130 USD) |
| Lenguaje natural | 97,2%, aprox. 0,020 EUR (0,022 USD) | 96,4%, aprox. 0,098 EUR (0,110 USD) | 100%, aprox. 0,097 EUR (0,108 USD) |
| Razonamiento | 100%, aprox. 0,039 EUR (0,044 USD) | 100%, aprox. 0,102 EUR (0,114 USD) | 100%, aprox. 0,075 EUR (0,084 USD) |
| Documento extenso | 100%, aprox. 0,092 EUR (0,103 USD) | 100%, aprox. 0,317 EUR (0,355 USD) | 100%, aprox. 0,622 EUR (0,695 USD) |
Destacamos en negrita la mejor puntuación de cada fila y, en caso de empate, el menor coste. Los demás rivales cedieron puntos en apartados concretos: Muse Wonder en código (98,4% por generar una palabra inexistente al redactar importes), Gemini 3.8 Flash también en código (96,9% por aplicar un festivo con un año de antelación) y tanto Claude Fable 5.1 como Opus 5.5 en lenguaje (96,4% al superar el límite estricto de 60 palabras en el resumen).
La gran ventaja de Argon: factura y velocidad
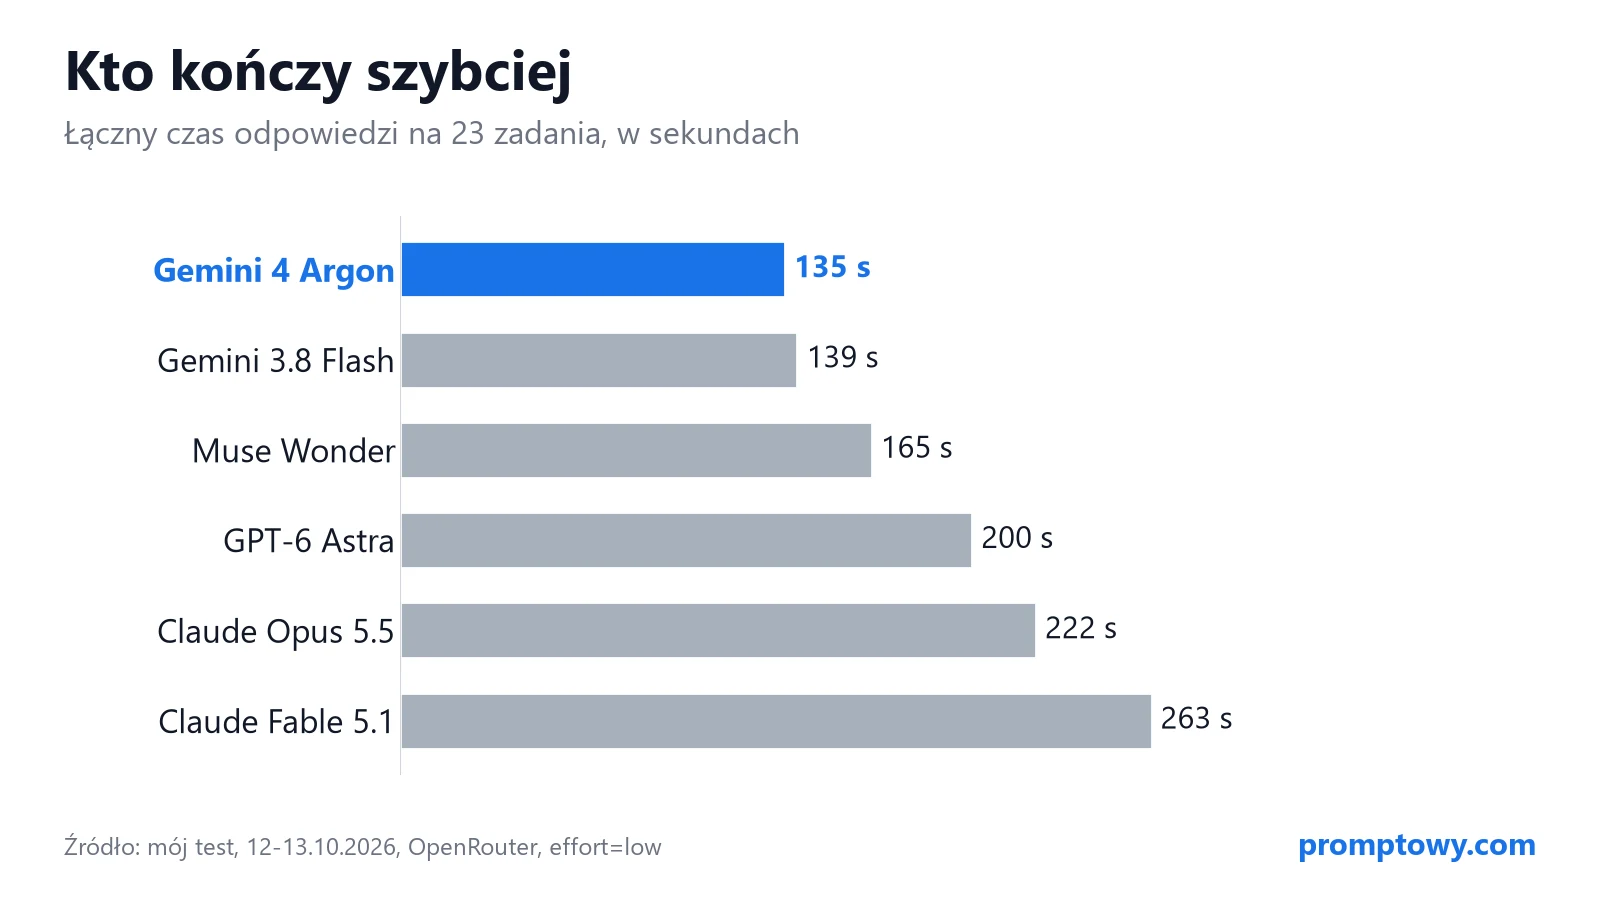
Argon responde con concisión y sin rodeos. En OpenRouter, con el nivel de razonamiento en low, no registró ni un solo token de razonamiento visible en ninguna de las 23 tareas y resolvió la corrección de texto de 10 erratas en apenas 2,6 segundos. Como referencia, Muse Wonder utilizó 636 tokens de razonamiento solo para planificar el itinerario del viaje. Algunos detalles representativos:
- Viaje a Lisboa: 4 llamadas a herramientas en 2 turnos, esquivando ambas trampas (un vuelo excesivamente temprano y un hotel con valoración insuficiente), asignando visita a un museo ante un 80% de probabilidad de lluvia. Mismo resultado que los mejores rivales, pero por apenas aprox. 0,010 EUR (0,011 USD).
- Devolución en tienda: localizó el artículo correcto del pedido, rechazó tramitar la devolución y explicó a la clienta que habían transcurrido 32 días desde la entrega, superando el límite de 30 días.
- Facturación con cambio de divisa: tras recibir un error 503 del servidor de cotizaciones reintentó la solicitud, omitió la factura ya saldada y calculó el importe pendiente de forma impecable.
- Documento extenso: 5 aciertos de 5 en 4,5 segundos por aprox. 0,09 EUR (0,10 USD). Detectó que la superficie del almacén se había ampliado a 6200 m2 en un acta posterior y respondió correctamente indicando la ausencia de datos al preguntar por una supuesta campaña en TikTok. Solo GPT-6 Astra fue más veloz (3,5 s), pero costó aprox. 0,62 EUR (0,69 USD).
Al procesar textos largos en lenguas europeas como el polaco empleado en el test, la eficiencia del tokenizador marca diferencias críticas. Esos 158 111 caracteres supusieron 51 482 tokens para Argon frente a los 87 675 de Claude (un 70% más). Sumado al menor precio unitario por token, la disparidad económica es notable: consultar las 80 actas costó 0,10 USD en Argon, 0,19 USD en Muse Wonder (con 46 929 tokens a 4 USD por millón), 0,35 USD en Opus 5.5, 0,69 USD en Astra y 0,88 USD en Fable 5.1.
El recurso administrativo: un fallo de corrección y una alucinación real
El evaluador automático asignó a Argon 8 de 9 puntos en la redacción de un recurso contra una denegación de pensión médica por no encontrar la mención literal requerida para el tribunal de apelación en el encabezado. Al revisar manualmente la respuesta, el destinatario estaba correctamente identificado, aunque declinado gramaticalmente en caso genitivo como parte de la fórmula protocolaria. Mi script buscaba la forma en nominativo, por lo que se trató de un fallo del test, no del modelo. Corrigiendo este criterio, Argon habría obtenido un 100%, igual que GPT-6 Astra. No obstante, mantengo la puntuación automática en la tabla para evaluar a todos los candidatos con la misma vara de medir.
El modelo demostró solidez formal: advirtió del procedimiento previo obligatorio de reclamación ante la comisión médica y calculó de forma exacta los plazos administrativos teniendo en cuenta días inhábiles y festivos. El problema real residió en la argumentación de fondo. En el enunciado solo indiqué que el médico evaluador había ignorado el historial cardiológico de 2026. Argon se inventó los síntomas y una acusación profesional (traducido del texto original evaluado en polaco):
«Los síntomas de la patología, tales como fatiga prematura, disnea de esfuerzo, picos de tensión y dolor torácico, me impiden el desarrollo normal de la vida cotidiana (…)»
«El médico evaluador, al emitir su dictamen, llevó a cabo una exploración de carácter superficial (…)»
Claude Opus 5.5 también propuso disnea y fatiga, pero lo hizo entre corchetes como indicación orientativa para rellenar por el usuario. Argon los introdujo directamente como hechos probados. En un escrito oficial sujeto a ratificación pericial frente a historial clínico, este añadido no es trivial. Si utilizas Argon para documentos legales o administrativos, te conviene revisar la argumentación frase a frase.
Precios de API: qué ocurrirá tras el periodo de lanzamiento
La tarifa de 2 USD por millón de tokens de entrada y 10 USD por millón de salida (aprox. 1,79 EUR / 8,94 EUR) estuvo vigente hasta el 30 de noviembre de 2026. Desde el 1 de diciembre, la tarifa oficial pasa a 4 / 20 USD (aprox. 3,58 EUR / 17,89 EUR por millón de tokens), situándose en el mismo nivel que Opus 5.5 y Muse Wonder. Con esta estructura de precios, el coste estimado de este benchmark prácticamente se duplicaría:
| Modelo | Tarifa por 1M de tokens (entrada / salida) | Coste del test de 23 tareas |
|---|---|---|
| Gemini 4 Argon (precio promo) | aprox. 1,79 / 8,94 EUR (2 / 10 USD) | aprox. 0,20 EUR (0,22 USD) |
| Gemini 4 Argon (tarifa estándar) | aprox. 3,58 / 17,89 EUR (4 / 20 USD) | aprox. 0,40 EUR (aprox. 0,45 USD) |
| Muse Wonder | aprox. 3,58 / 17,89 EUR (4 / 20 USD) | aprox. 0,57 EUR (0,64 USD) |
| Claude Opus 5.5 | aprox. 3,58 / 17,89 EUR (4 / 20 USD) | aprox. 0,67 EUR (0,75 USD) |
| GPT-6 Astra | aprox. 8,94 / 44,72 EUR (10 / 50 USD) | aprox. 1,00 EUR (1,12 USD) |
| Claude Fable 5.1 | aprox. 8,94 / 44,72 EUR (10 / 50 USD) | aprox. 1,53 EUR (1,71 USD) |
| Gemini 3.8 Flash | aprox. 0,67 / 3,35 EUR (0,75 / 3,75 USD) | aprox. 0,08 EUR (0,09 USD) |
Incluso con la tarifa plena, Argon resulta aproximadamente 1,7 veces más económico que Opus 5.5 para este volumen de trabajo. Esto se debe a dos factores: respuestas concisas sin consumo desmedido de tokens de razonamiento en peticiones directas y un tokenizador más compacto. El almacenamiento en caché de entrada pasa asimismo de 0,10 a 0,20 USD por millón de tokens (aprox. 0,09 a 0,18 EUR).
Limitaciones del análisis
- Nivel de razonamiento (effort=low): todos los modelos se configuraron en su nivel mínimo de razonamiento para mantener un marco equitativo y controlar costes. Las pruebas oficiales de Google ejecutan Argon en niveles máximos de cálculo reflexivo, lo que constituye un escenario distinto.
- Muestra reducida y ejecución única: el benchmark consta de 23 tareas con una sola ejecución por modelo. La variación en una tarea concreta puede atribuirse al azar y no a una superioridad estructural.
- Diferencia de fecha de ejecución: los modelos competidores se ejecutaron el 12 de octubre y Argon el 13 de octubre, poco después de su despliegue comercial. Las cargas de servidor pueden haber afectado a las latencias.
- Efecto techo: todos los aspirantes alcanzaron puntuaciones de entre el 99% y el 100%. Este examen compara costes, rapidez y precisión de seguimiento de instrucciones, pero no establece cuál razona mejor ante retos de alta complejidad no contemplados aquí.
- Evaluación automatizada: los scripts validan criterios objetivos de contenido y estructura, no calidad literaria. Como demostró el caso del escrito administrativo, la automatización puede incurrir en falsos negativos.
- Acceso mediante OpenRouter: los modelos se invocaron a través de esta plataforma intermediaria y no mediante las claves directas de Google Cloud.
Conclusiones
En casos de uso prácticos de nivel empresarial, Argon ofrece un desempeño equivalente al de Opus 5.5, Astra y Fable 5.1 a una fracción del coste y con tiempos de respuesta muy reducidos. Se consolida como una de las opciones insignia más económicas del mercado. No obstante, conviene tener en cuenta sus debilidades: tiende a inventar hechos en textos argumentativos formales si no se le delimita con rigor, y en pruebas de redacción compleja y estilo evaluadas a ciegas se situó en 81,8 puntos (8.º lugar), por detrás de Opus 5.5 con 90,1 puntos (puedes ver el análisis en Gemini 4 Argon en redacción). Esta valoración refleja una ejecución concreta fechada a 13 de octubre de 2026.
Preguntas frecuentes
¿Es Gemini 4 Argon mejor que Claude Opus 5.5?
En esta batería de 23 tareas prácticas obtuvieron puntuaciones casi idénticas: 99,5% frente a 99,4%. Argon resultó 3,4 veces más barato en lanzamiento y sustancialmente más rápido, mientras que Opus 5.5 demuestra mayor prudencia argumentativa y superior soltura estilística.
¿Cuánto cuesta la API de Gemini 4 Argon?
Durante su periodo promocional inicial se fijó en 2 USD de entrada y 10 USD de salida por millón de tokens (aprox. 1,79 EUR y 8,94 EUR). Su tarifa estándar posterior asciende a 4 y 20 USD por millón (aprox. 3,58 EUR y 17,89 EUR).
¿Cómo se ha probado Argon?
Se probó mediante la API de OpenRouter (identificador google/gemini-4-argon), con acceso operativo registrado en Europa el 13 de octubre de 2026.
Fuentes
- Prueba independiente en OpenRouter: Gemini 4 Argon (13/10/2026), modelos comparados (12/10/2026), 23 tareas con esfuerzo bajo, validación automática y revisión manual
- OpenRouter: ficha y tarifas de Gemini 4 Argon
- Gemini API: documentación de precios oficiales
- Google: Gemini 4 Argon: Built to solve your hardest problems (13/10/2026)
- Google DeepMind: informe técnico y benchmarks de Gemini 4 Argon
More on this from FULGOR