Qwen-Image-2.1 frente a modelos cerrados: 4 pruebas en RTX 4090
Qwen-Image-2.1 en local con RTX 4090 frente a Ideogram 4.5 y FLUX 3: texto complejo, composicion con marcos, 10 ediciones consecutivas y detalle en 4K.
👁 115 lecturas
Qwen-Image-2.1 es actualmente el mejor modelo abierto de generación de imágenes en la clasificación de Artificial Analysis, así que lo he sometido a las mismas cuatro pruebas que realicé con Ideogram 4.5 y FLUX 3. Se ejecutó en local en mi tarjeta RTX 4090, mientras que los rivales funcionaron mediante API. El resultado muestra dos caras: una sola imagen luce genial y se genera en 6-20 segundos con un gasto mínimo de electricidad; sin embargo, al recrear texto complejo con diacríticos, respetar una composición fija o encadenar ediciones sucesivas, los modelos comerciales cerrados siguen siendo claramente superiores.
Lectura relacionada: Qué puede hacer Qwen-Image-2.1: diez imágenes de diez mundos.
La clasificacion de Artificial Analysis se basa en votaciones a ciegas de usuarios que eligen la imagen mas atractiva entre dos opciones. Es un buen indicador estetico, pero no aclara si un modelo puede renderizar palabras dificiles con caracteres especiales, colocar una taza en una esquina exacta o sobrevivir a diez modificaciones consecutivas. Por eso mido estos aspectos de forma independiente, utilizando los mismos scripts y las mismas instrucciones que con la competencia.
Como he realizado las pruebas
- Hardware: RTX 4090 (24 GB), ComfyUI, Qwen-Image-2.1 en variante cuantizada int8 (16,6 GB de archivos), 25 pasos, muestreador euler, cfg 1,0 (configuracion recomendada en la plantilla oficial).
- Rivales: las mismas tareas ejecutadas mediante la API de fal.ai, analizadas en las pruebas de Ideogram 4.5 y FLUX 3 del 1 de octubre de 2026.
- Un unico intento por tarea, semilla fija, sin seleccionar los resultados mas favorables.
- Fecha: 2 de octubre de 2026.
Resultados resumidos
| Prueba | Qwen-Image-2.1 (local) | Mejor resultado del grupo |
|---|---|---|
| Textos complejos en polaco (13 a reproducir) | 6/13 | 13/13 - GPT Image 2.5, Nano Banana Pro, Nano Banana 2, Grok |
| Objetos en posiciones fijadas (16) | 2/16, IoU 0,17 | 16/16, IoU 0,89 - FLUX 3 con marcos JSON |
| Detalle en plano amplio | 2752 × 1536, efectivamente 3,1 Mpx | 16,8 Mpx - FLUX 3 en 4K |
| Rotulos pequenos legibles (8) | 2/8 | 8/8 - GPT Image 2.5, Grok, Seedream |
| 10 ediciones consecutivas (SSIM tras el decimo paso) | 0,11 | 0,95 - Ideogram 4.5 |
| Tiempo por imagen de 1024 × 1024 | aprox. 6 s | rivales mediante API: 20-60 s |
| Coste por imagen | electricidad, fraccion de centimo | aprox. 0,021-0,197 EUR (0,024-0,22 USD) via API (cambio de referencia del BCE a fecha 12/10/2026: 1 EUR = 1,1181 USD) |
Prueba 1: textos complejos con caracteres especiales
Planteamos cuatro tareas evaluadas originalmente en polaco: el cartel de unas rebajas, el menú de un comedor tradicional, la portada de un libro ficticio cargado de diacríticos («Brizna y bilis», traducción del original en polaco) y el paquete de unas empanadillas típicas («empanadillas polacas», traducción del original en polaco). En total, 13 palabras o frases para reproducir letra por letra. Verifiqué manualmente la lectura de OCR en cada imagen. En el menú corregí un falso positivo de lectura errónea (el texto del menú del día estaba bien escrito).
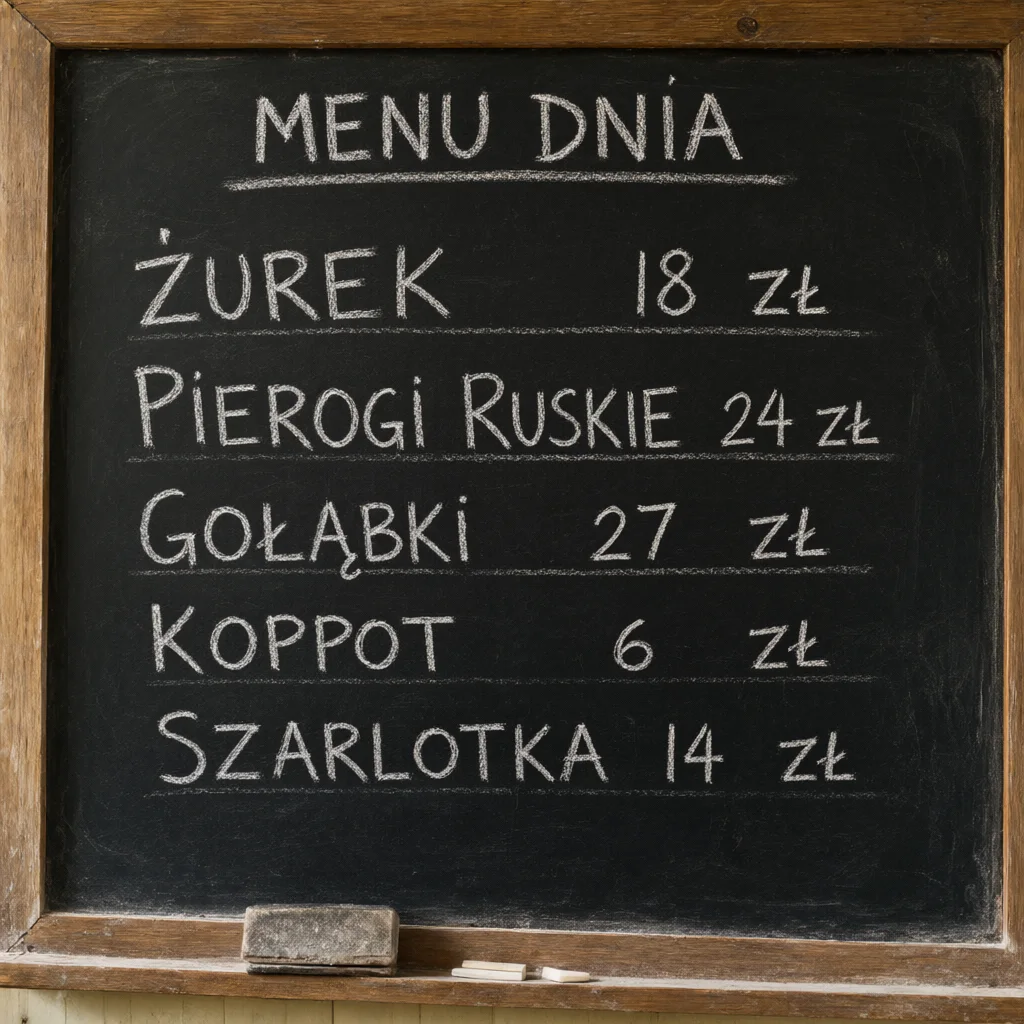
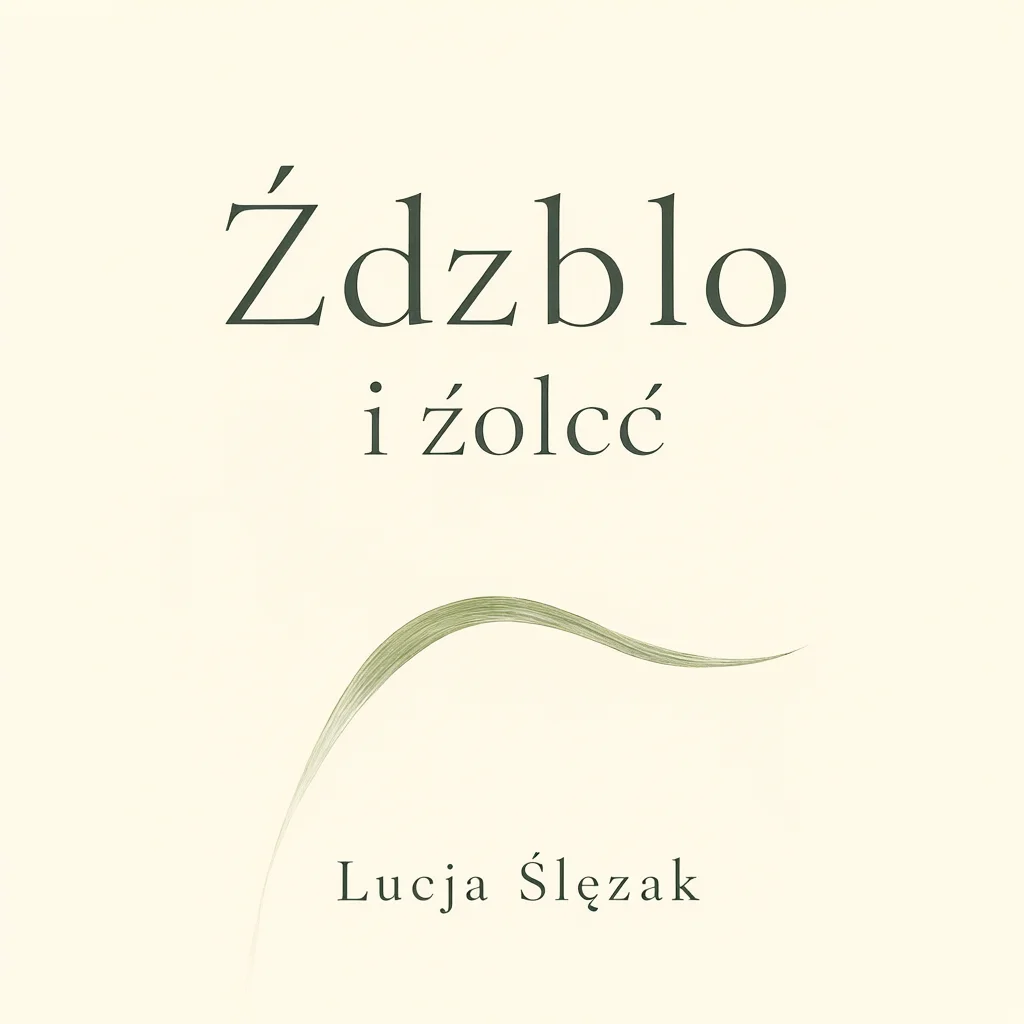
Las palabras habituales, grandes y claras salen bien cuando no presentan combinaciones complejas. El problema surge con grupos consonanticos raros o diacriticos densos, ademas de la tipografia pequena. En el empaque alimentario deformo las palabras secundarias inventando caracteres, y en el cartel desfiguro el termino de la estacion del ano. Si necesitas graficos con texto exigente o multilingue con grafias especiales, este modelo requiere retoque manual obligatorio.
Prueba 2: objetos en ubicaciones concretas
Diseñé cuatro escenas con cuatro elementos en cada una, especificando su posición exacta en porcentajes relativos al ancho y al alto del encuadre. Qwen-Image-2.1 no admite instrucciones de coordenadas en formato JSON, así que recibió la descripción en texto plano, igual que Nano Banana Pro, GPT Image 2.5 y Seedream. Un modelo de visión artificial identificó dónde cayó cada elemento y calculé el solapamiento con la caja delimitadora exigida (IoU).
| Modelo | IoU medio | Objetos en su sitio |
|---|---|---|
| FLUX 3 Image (marcos JSON) | 0,89 | 16/16 |
| Seedream 5.0 Pro | 0,79 | 15/16 |
| GPT Image 2.5 Sunburst | 0,54 | 11/16 |
| Nano Banana Pro | 0,48 | 7/16 |
| Ideogram 4.5 | 0,37 | 7/16 |
| Qwen Image 3 (API) | 0,35 | 6/16 |
| Qwen-Image-2.1 (local) | 0,17 | 2/16 |
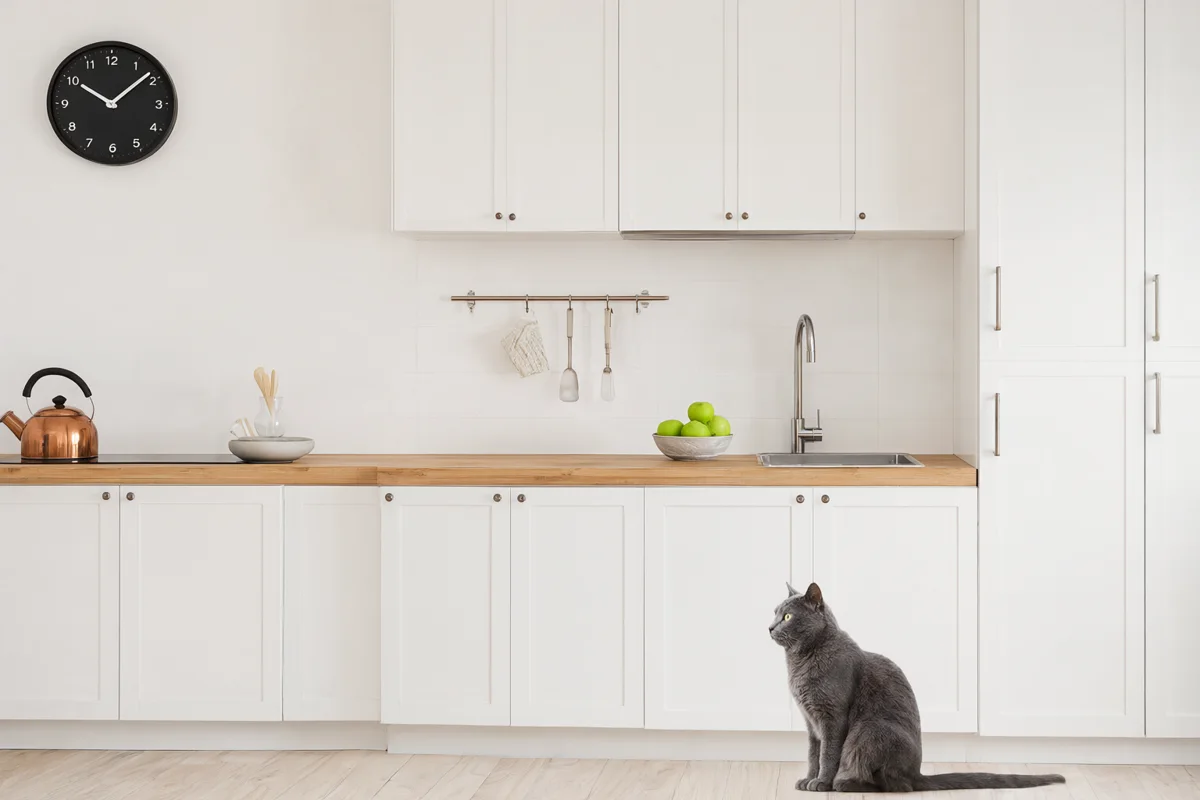
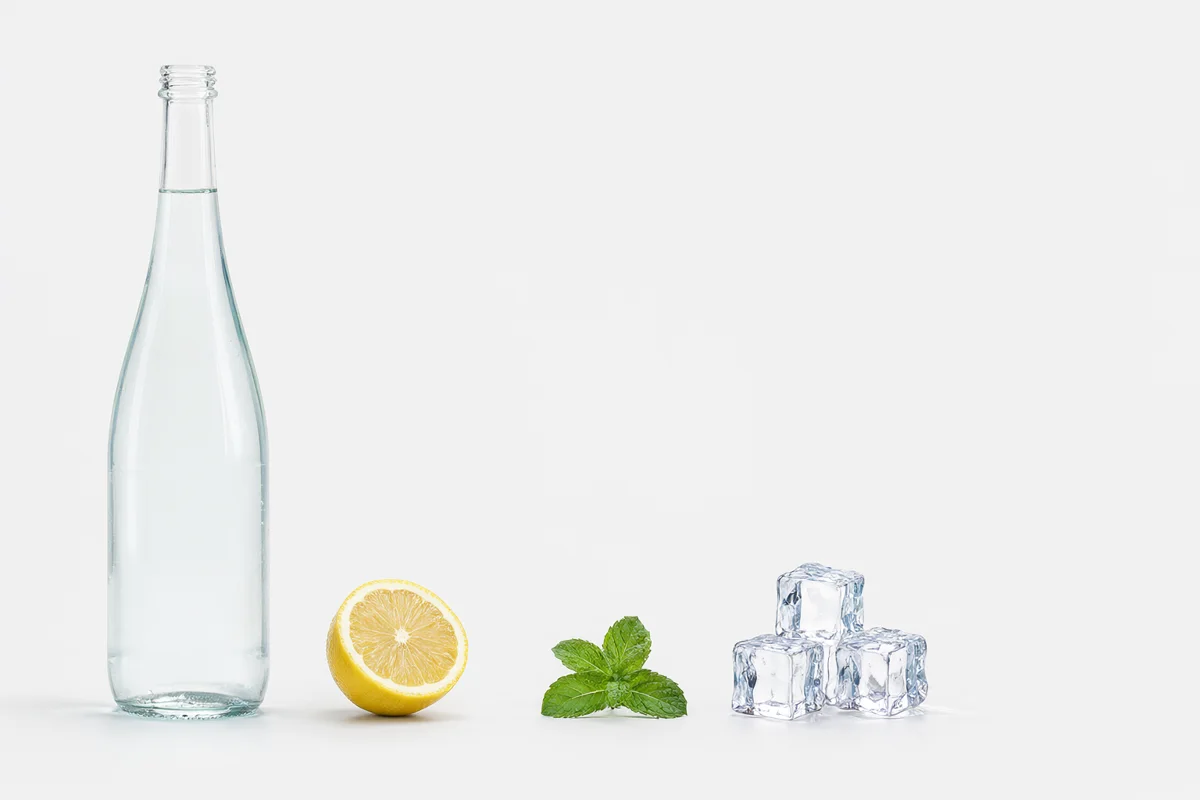
Las imagenes son visualmente atractivas e integran todo lo solicitado. El problema es que el modelo compone la escena a su propio criterio estetico e interpreta las indicaciones porcentuales como una mera sugerencia contextual. Si tu maqueta exige dejar espacio reservado para un logotipo o un titular, es preferible utilizar FLUX 3 con cajas JSON o Seedream.
Prueba 3: nivel de detalle en planos amplios
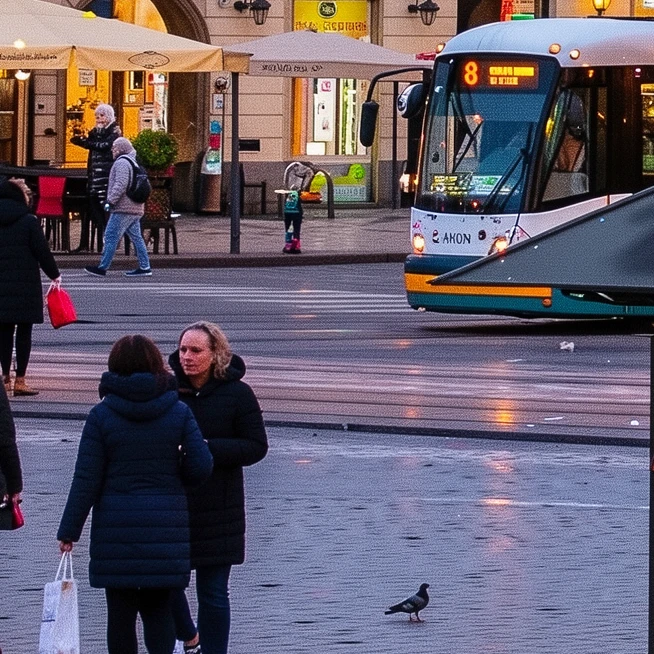
Utilizamos el mismo encuadre urbano de una plaza historica con varios rotulos en tiendas, un quiosco y un tranvia. Qwen-Image-2.1 lo renderizo en su proporcion 16:9 maxima admitida (2752 × 1536 px) en 49 segundos. La resolucion real efectiva rondo los 3,1 megapixeles de detalle autentico, una cifra similar a Grok Imagine 2 (3,3 Mpx). Tan solo 2 de los 8 carteles resultaron legibles: el rotulo de una floristeria y el titular de un periodico en el quiosco. Los demas letreros se redujeron tanto que terminaron borrosos.
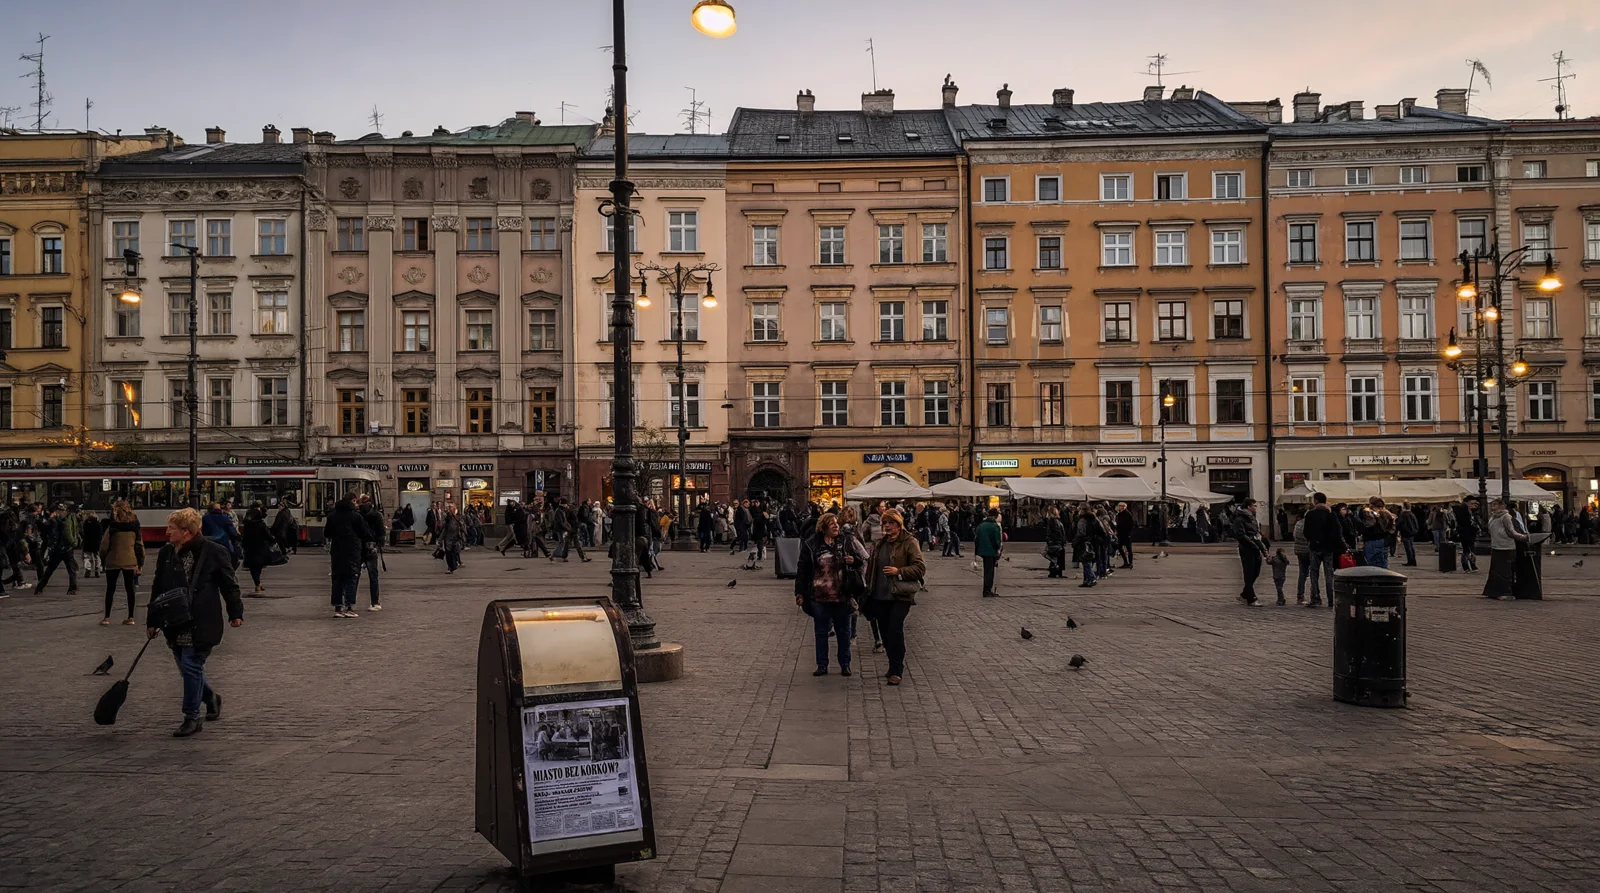
Prueba 4: cadena de 10 ediciones consecutivas
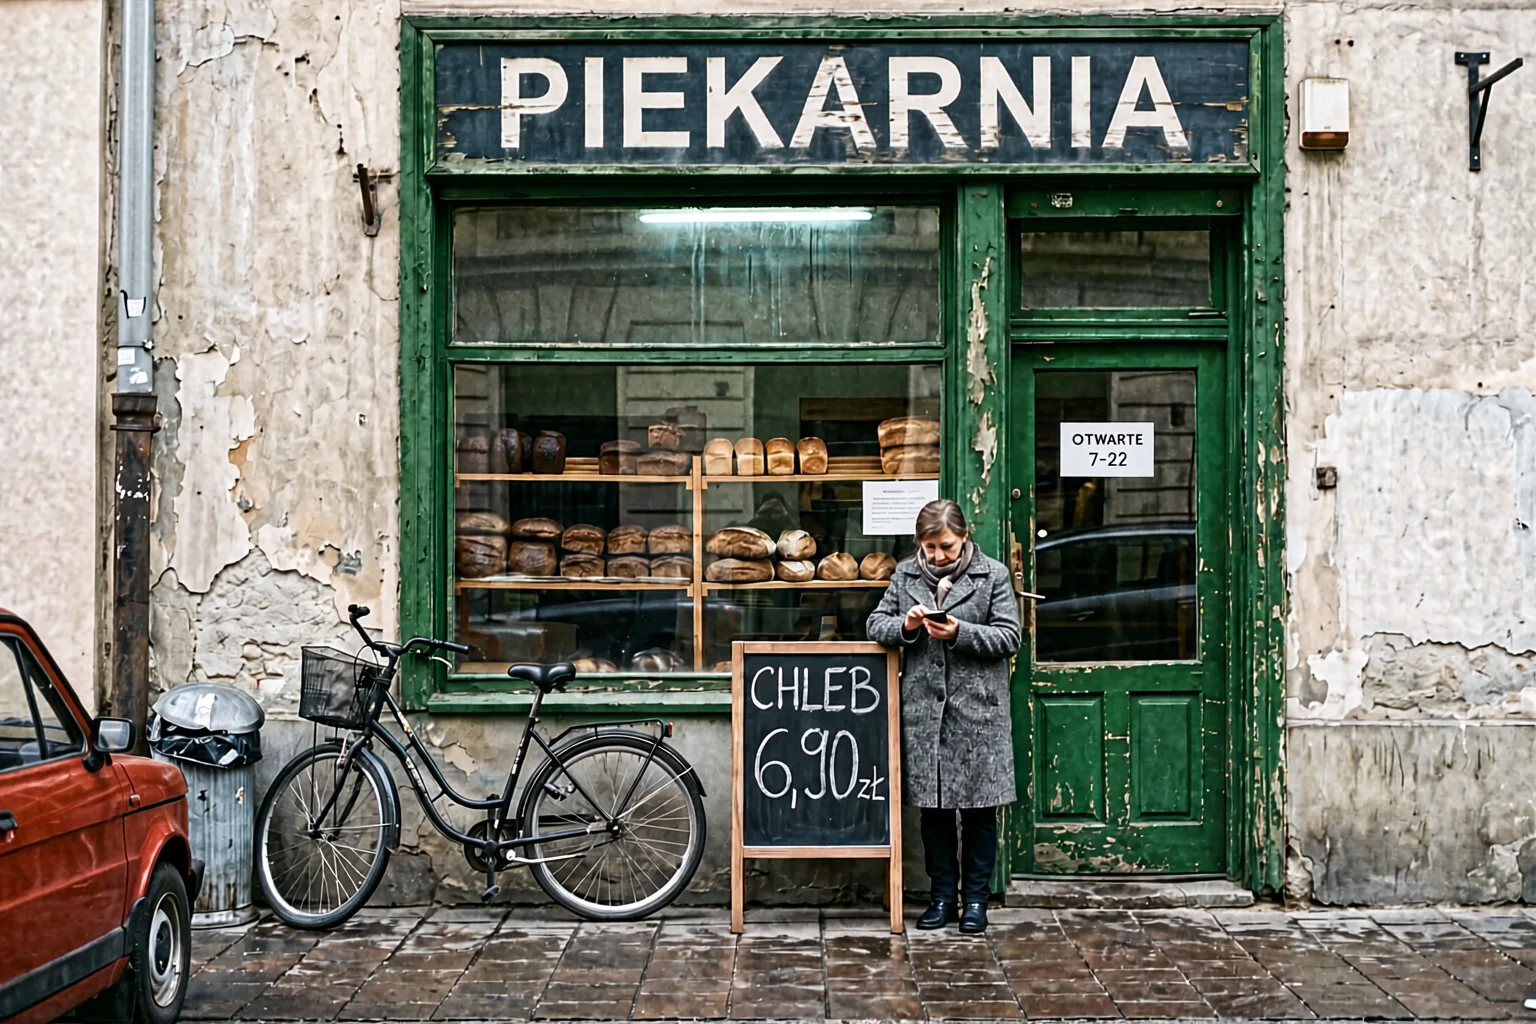
Partiendo de la foto de una panaderia, aplicamos 10 modificaciones sucesivas: cambiar el color de la puerta, colocar un adhesivo, sustituir una bicicleta por un patinete, retirar un coche aparcado, cambiar el rotulo, anadir plantas de lavanda, modificar una prenda de vestir, incorporar un gato, variar un precio y eliminar una papelera. Cada iteracion toma como entrada el archivo resultante de la anterior. Se midio la similitud estructural (SSIM, donde 1 representa ausencia total de alteracion) en las zonas que debian quedar intactas.
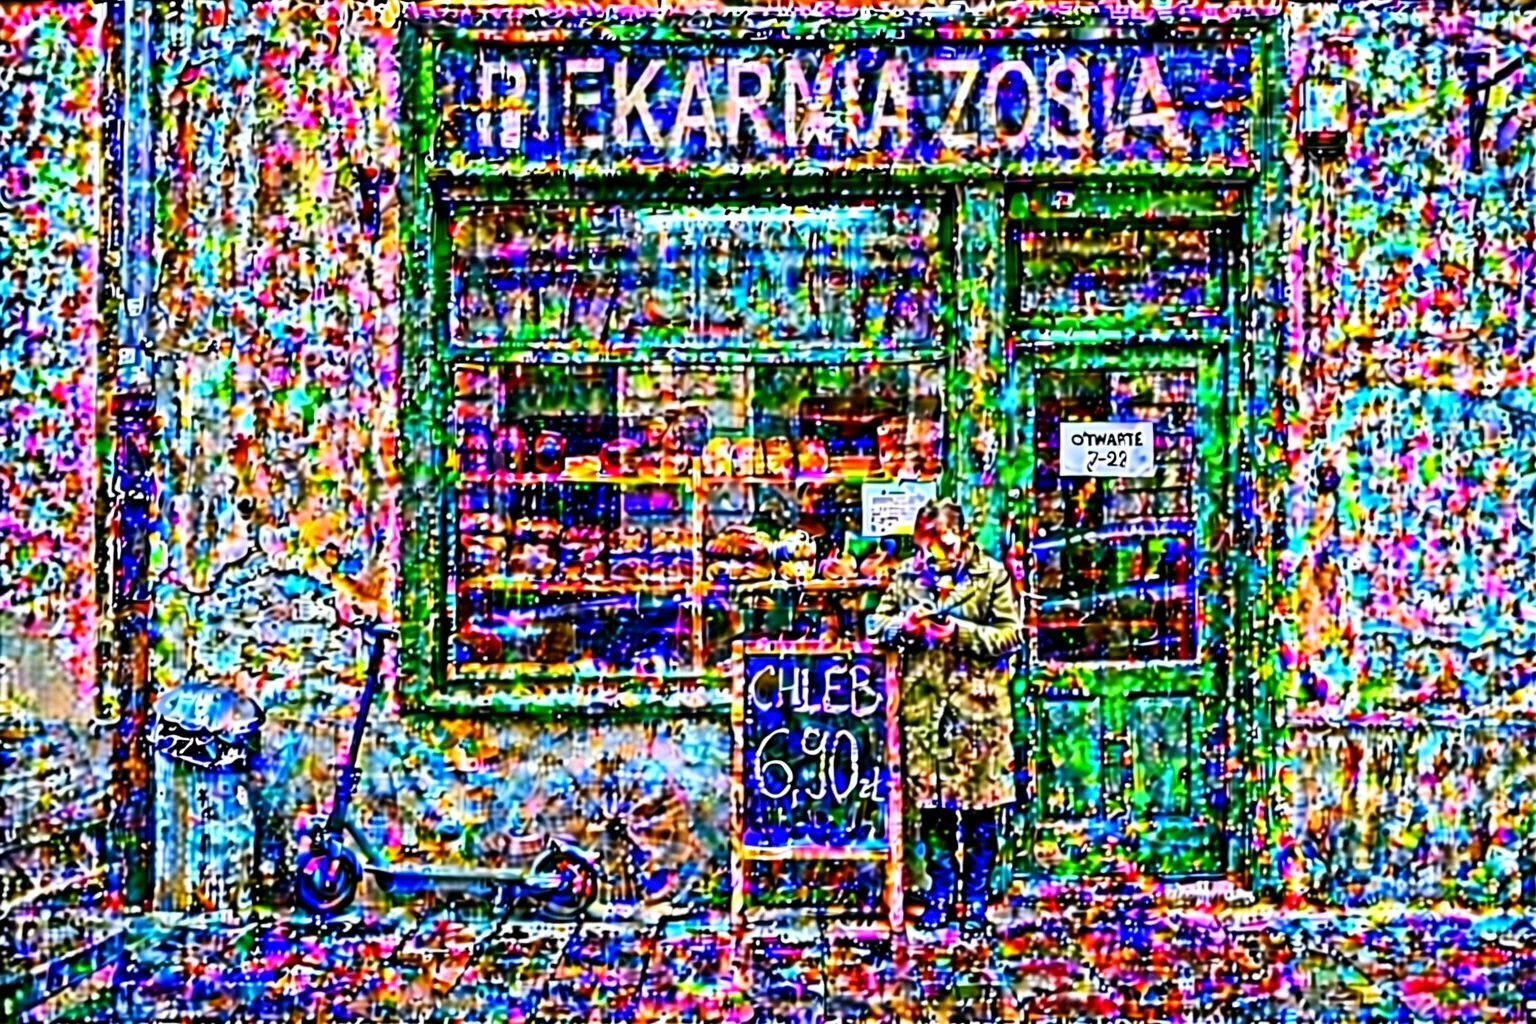
En cuanto a comprensión semántica pura, Qwen-Image-2.1 cumple con precisión: la puerta pasó a ser verde, la bicicleta se convirtió en patinete, el automóvil desapareció y el letrero cambió de texto. No obstante, cada paso adicional inyecta granulado y satura los tonos. A partir de la tercera modificación los artefactos son patentes; tras la sexta, el archivo pierde utilidad práctica. La primera intervención se resuelve con gran calidad, lo cual coincide con su posición número 18 en el ranking de edición de Artificial Analysis. Conviene recordar que dicha tabla solo mide una alteración aislada, no una cadena sucesiva.
Una puntualización relevante sobre la configuración: las pruebas se llevaron a cabo con la versión int8 en ComfyUI. En un primer intento fijé la resolución de la imagen base en 1024 frente a una salida de 2048, lo que aceleró el ruido (SSIM 0,08). Al igualar ambas resoluciones la estabilidad mejoró, aunque sin resolver el problema de fondo. Es probable que la precisión original bf16 o samplers específicos mitiguen este efecto; no obstante, la versión bf16 supera la memoria de 24 GB si se carga junto al codificador de texto.
Recomendacion practica: si vas a introducir varios cambios sobre una composicion, aplica todas las peticiones en una sola orden sobre el archivo original en lugar de encadenar retoques uno tras otro.
Conclusiones
- Para generar imagenes directas y de alta calidad sin texto: Qwen-Image-2.1 rinde de maravilla; tarda 6 segundos en formato 1K, prescinde de tarifas de API y cuenta con buena valoracion comunitaria.
- Para diseños con textos complejos o diacríticos exigentes: conviene recurrir a GPT Image 2.5 o Nano Banana Pro.
- Para controlar con exactitud la posicion de cada elemento: la alternativa ideal es FLUX 3 mediante cajas JSON.
- Para sesiones de edicion secuencial: la mejor consistencia la ofrecen Ideogram 4.5 o FLUX 3.
- Atencion a los terminos de uso: la licencia Qwen Research autoriza exclusivamente tareas de investigación y evaluación. El despliegue con fines comerciales demanda un acuerdo contractual con Alibaba; revisa los detalles en el artículo sobre su licencia.
Puedes consultar la comparativa global de opciones de código abierto en la clasificacion de modelos abiertos para imagen, y profundizar sobre la posicion de Qwen-Image-2.1 en Artificial Analysis en esta noticia complementaria.
Google · Tus fuentesBrilla más alto en tu Google - con un solo clicAñadir a fuentes preferidas →Preguntas frecuentes
¿Es Qwen-Image-2.1 mejor que Nano Banana Pro?
En las votaciones de Artificial Analysis no: Nano Banana Pro acumula 1101 puntos frente a los 1034 de Qwen-Image-2.1. En nuestras mediciones, Nano Banana Pro supero con claridad a Qwen en tipografia compleja (13 aciertos frente a 6) y en precision de composicion. Qwen saca ventaja en gasto operativo cero y ejecucion sin conexion.
¿Cuanto tarda en procesar una imagen en una RTX 4090?
Segun las pruebas cronometradas, toma unos 6 segundos a 1024 × 1024, 10 segundos a 1536 × 1024, 44 segundos a 2048 × 2048 y 49 segundos a 2752 × 1536. Una operacion de edicion en 1536 × 1024 requirio unos 20 segundos. El primer pase tras iniciar y cargar el modelo en memoria resulta notablemente mas lento.
¿Por que se degrada la imagen al encadenar ediciones?
Cada ciclo comprime y descomprime el lienzo al completo en el espacio latente, acumulando pequenos errores en cada paso. Motores como Ideogram 4.5 y FLUX 3 cuentan con mecanismos para transferir y preservar los pixeles originales que no debian modificarse. La implementacion de Qwen-Image-2.1 en ComfyUI carece de esa funcion de recuperacion por defecto.
¿Puedo utilizar Qwen-Image-2.1 en un entorno profesional o corporativo?
No sin pactar una licencia ad hoc con el desarrollador. La modalidad Qwen Research se limita al estudio academico y la evaluacion tecnica sin fines lucrativos.
- Artificial Analysis - clasificacion texto a imagen
- Artificial Analysis - clasificacion de edicion de imagen
- Hugging Face - Qwen-Image-2.1
- Pruebas propias realizadas entre el 1 y el 2 de octubre de 2026: scripts, imagenes y metricas (OCR, IoU, SSIM y resolucion efectiva)

More on this from FULGOR