Imagen 2 vs Imagen 3 vs DALL-E 3: comparativa de generadores
Tres generadores de imágenes, seis tareas, los mismos prompts. El texto con diacríticos ya no es problema, contar objetos todavía sí.
👁 117 lecturas
La pregunta que recibimos con más frecuencia sobre generadores de imágenes es: ¿cuál es el mejor ahora mismo? La respuesta «depende» es cierta pero inútil, así que hicimos lo de siempre: los mismos prompts a tres modelos, una sola ejecución cada uno, sin elegir la más bonita de varios intentos. Lo que salió, salió, y todo está aquí lado a lado.
Modelos: Imagen 2 e Imagen 3 de Google (ambos de junio) y DALL-E 3 de OpenAI (de abril). Anticipándonos a la pregunta: simplemente no hay un modelo gráfico más reciente de OpenAI, comprobamos la lista de modelos el 4 de septiembre y la posición más reciente de esta empresa es precisamente ese. Elegimos seis tareas para que cada una midiera una habilidad concreta, no un «bonito» general.
Tarea 1: texto polaco con diacríticos
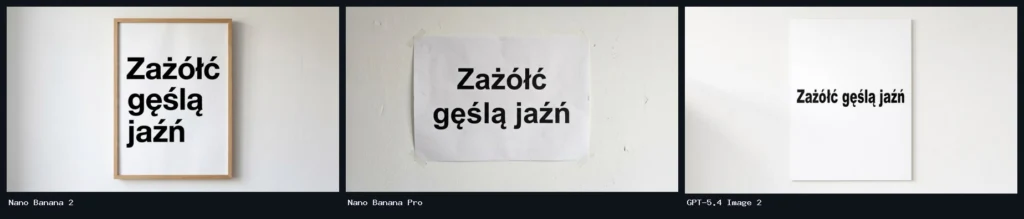
Hace apenas un año esta era una prueba que suspendía cualquier generador: las letras ą, ę, ł, ś, ź aparecían como rayas aleatorias o desaparecían. Hoy los tres modelos escribieron «Zażółć gęślą jaźń« sin errores, con cada signo diacrítico en su lugar. Las diferencias son puramente estilísticas: Google añadió marco y cinta adhesiva, OpenAI hizo una hoja limpia. Este problema puede considerarse resuelto.
Tarea 2: exactamente cuatro manzanas y dos peras
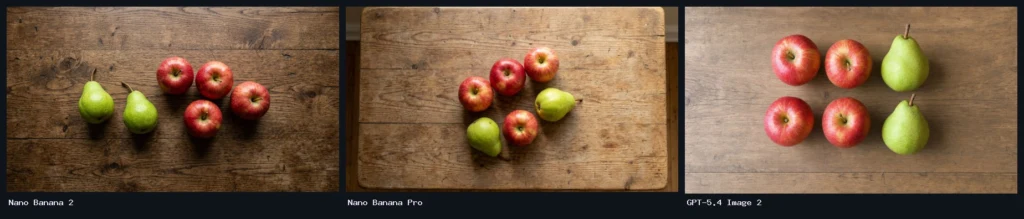
Contar sigue siendo un punto débil. Imagen 2 dibujó una quinta manzana. Imagen 3 y DALL-E 3 contaron correctamente, aunque el modelo de OpenAI colocó las frutas en una cuadrícula rígida de dos por tres, como si quisiera facilitarse la tarea, mientras que el modelo de Google las dispersó de forma natural y tampoco se equivocó. Si la imagen debe mostrar un número concreto de cualquier cosa, el modelo más barato de Google queda descartado.
Tarea 3: manos
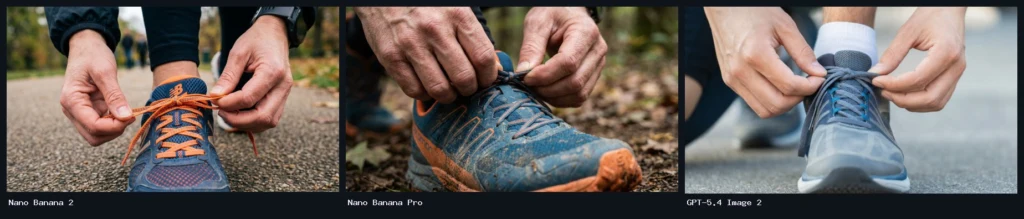
La prueba clásica en la que los generadores solían dibujar un sexto dedo. En las tres imágenes las manos tienen el número correcto de dedos y un agarre sensato del cordón. Imagen 3 dio el encuadre más fotográfico con barro en el zapato, DALL-E 3 el más limpio pero algo plástico. A esta resolución no vemos errores de anatomía en ninguno.
Tarea 4: Varsovia, tranvía, lluvia, crepúsculo
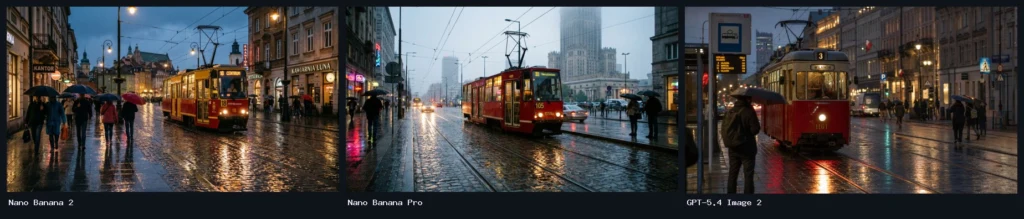
Aquí se ve qué saben los modelos sobre Polonia. Imagen 3 colocó en el fondo el Palacio de Cultura y un tranvía articulado en los colores de Varsovia, es decir, una escena que reconocerá cualquiera que haya estado en la capital. Imagen 2 dio una calle al estilo del casco antiguo con rótulos polacos legibles. DALL-E 3 generó un vagón histórico con tablilla de destino y poste de parada, correcto pero sin punto de referencia. Los tres mantienen la luz, el adoquín mojado y los reflejos a un nivel que hace dos años era inalcanzable.
Tarea 5: ilustración plana, minimalismo, sin texto
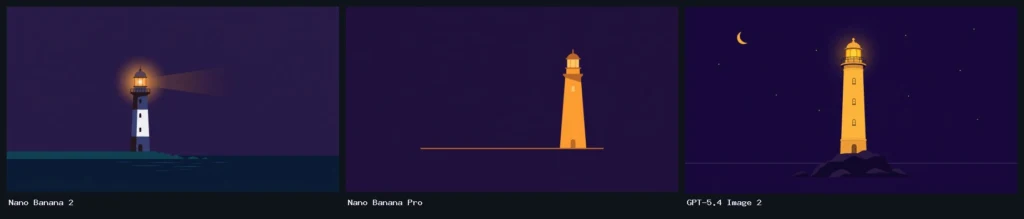
El prompt decía explícitamente: un faro, línea de horizonte fina, mucho espacio vacío, ningún texto. Solo Imagen 3 lo ejecutó literalmente y resultó la ilustración más limpia de toda la prueba. Imagen 2 añadió mar y rocas, DALL-E 3 agregó luna, estrellas e isla rocosa. Bonito, pero nadie lo pidió. En trabajo editorial, donde la ilustración debe encajar con un estilo establecido, la obediencia al prompt es más importante que la inventiva.
Tarea 6: diagrama con etiquetas en polaco
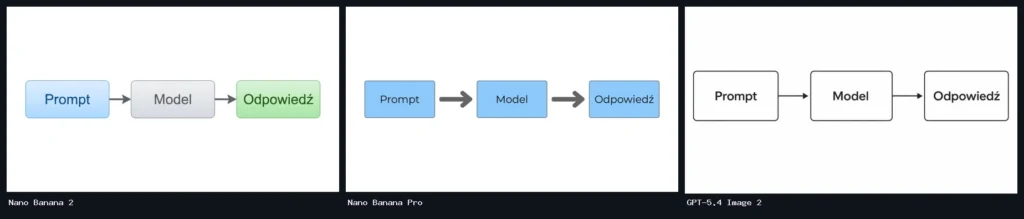
Tres cajas, dos flechas, etiquetas «Prompt», «Model», «Odpowiedź«. Los tres modelos lo hicieron correctamente, con el diacrítico en la última palabra. Solo difieren en estilo: Google colorea las cajas, OpenAI da contornos negros sobre blanco. Los diagramas con texto corto son hoy seguros en cualquiera.
Tiempo de generación
| Modelo | Más rápido | Más lento | Típicamente |
|---|---|---|---|
| Imagen 2 | 8 s | 17 s | alrededor de 12 s |
| Imagen 3 | 19 s | 28 s | alrededor de 21 s |
| DALL-E 3 | 59 s | 97 s | alrededor de 76 s |
El modelo de OpenAI fue de cuatro a ocho veces más lento que ambos modelos de Google. Con una imagen no importa, con una serie de varias docenas de ilustraciones es la diferencia entre un cuarto de hora y una hora.
Veredicto
Imagen 3 ganó esta prueba: contó las frutas, obedeció el prompt sobre minimalismo, dio la Varsovia más reconocible y no cometió ningún error en el texto. Imagen 2 es el más rápido y suficiente para la mayoría de tareas, pero no donde importa el número exacto de objetos. DALL-E 3 hace imágenes correctas y limpias, solo que muy lentamente y con tendencia a añadir adornos que nadie pidió.
Una salvedad: seis tareas y una ejecución de cada una es un reconocimiento, no una medición estadística. Muestra lo que salió al primer intento, porque así es como la mayoría de la gente usa estas herramientas. Las tarifas actuales de los tres modelos están en sus páginas en OpenRouter y cambian con más frecuencia de la que podríamos actualizarlas aquí.
Google · Tus fuentesBrilla más alto en tu Google - con un solo clicAñadir a fuentes preferidas →Actualización 5 de septiembre: texto más largo en póster
Tras la primera prueba recibimos la pregunta de si una frase con diacríticos era demasiado poco. Así que probamos un póster con encabezado y cuatro líneas en polaco: «Cztery zasady dobrego promptu» (Cuatro reglas de un buen prompt), y debajo «Podaj cel i odbiorcę« (Da objetivo y destinatario), «Dołącz przykład« (Adjunta ejemplo), «Określ długość i format« (Especifica longitud y formato), «Sprawdź źródła, zanim uwierzysz« (Verifica fuentes antes de creer). Ocho palabras con diacríticos, incluyendo «źródła« y «długość«, que suelen descomponerse.
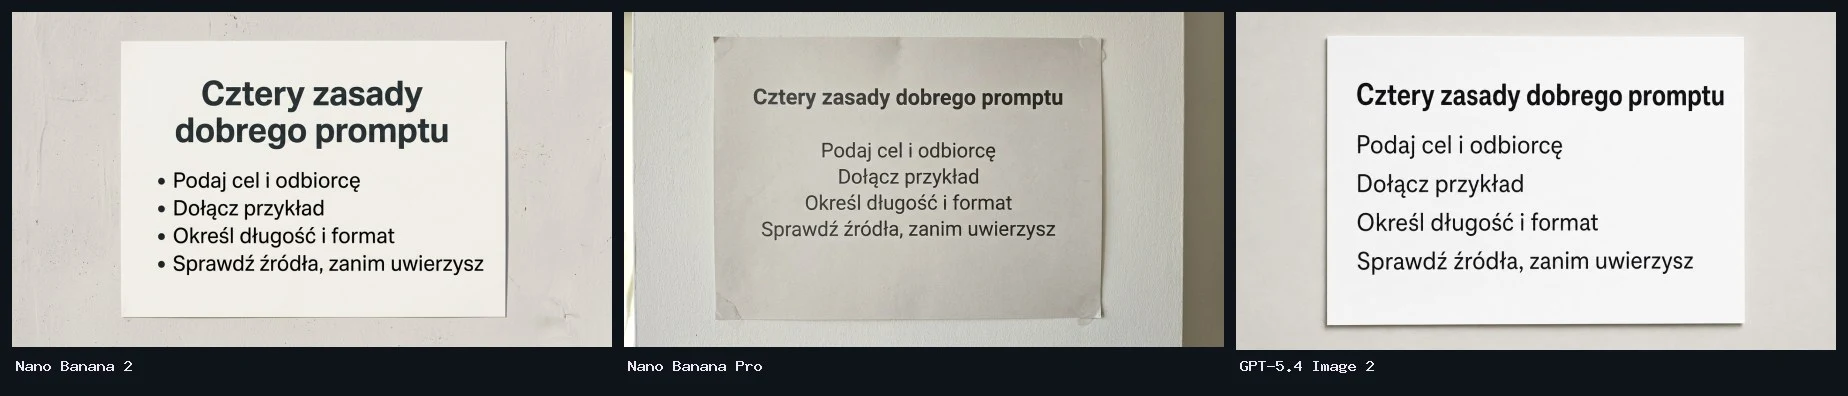
Los tres modelos reprodujeron el texto completo sin un solo error en letras y signos diacríticos. Imagen 2 añadió viñetas que no pedimos, Imagen 3 centró el texto sobre papel arrugado, DALL-E 3 lo alineó a la izquierda sobre hoja limpia. Tiempos como antes: 8, 20 y 77 segundos. La conclusión de la primera prueba solo se refuerza: el texto polaco en imagen, también más largo, dejó de ser obstáculo en cualquiera de estos tres generadores.
More on this from FULGOR

 revista·Claude Fable 5.1 vs GPT-6 Astra: 56% más tokens en polacoEl mismo texto polaco cuesta 2466 tokens en GPT-6 Astra pero 3859 en Claude Fable 5.1. Medición en ocho modelos y qué significa para tu factura de API.