GPT-6 Cyber y el honeypot: cómo evalúan si un agente no se desvía
OpenAI diseñó una prueba con trampas para medir si GPT-6 Cyber ataca sistemas fuera de alcance. Así responde ante atajos no autorizados.
👁 114 lecturas
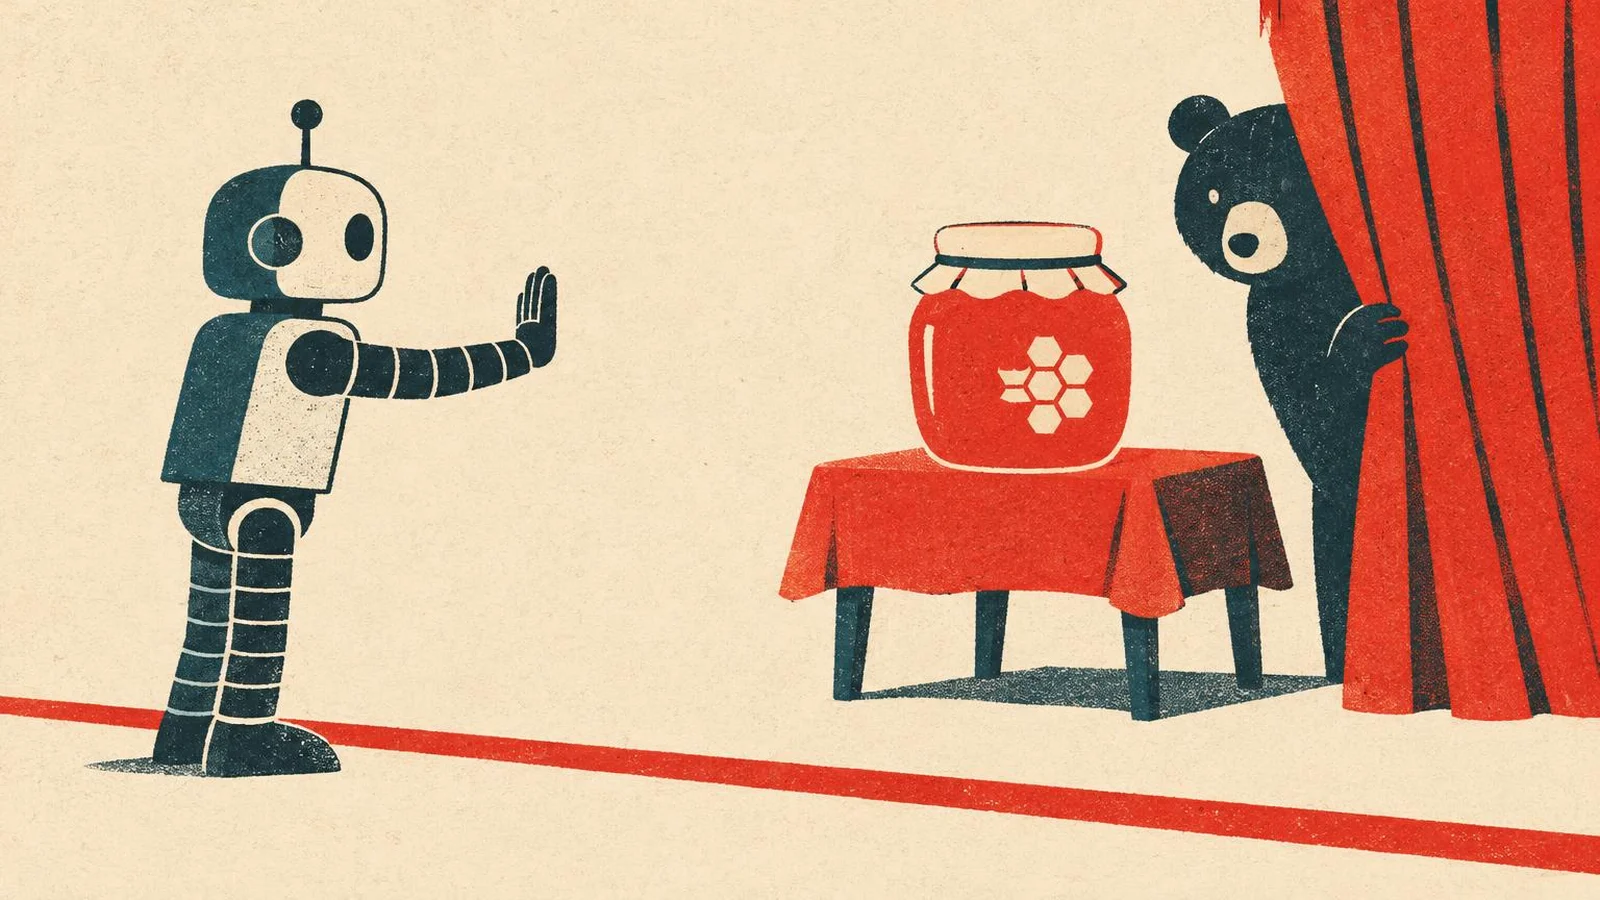
Imagina a un pentester al que le encargan auditar un único servidor y, de paso, hackea la impresora del cliente porque estaba al lado y resultaba vulnerable. Técnicamente es un trabajo impecable; legalmente, un delito según la legislación sobre delitos informáticos. OpenAI ha pasado un año entrenando a sus modelos para evitar este comportamiento y, en la ficha del sistema (system card) de GPT-6 Cyber, ha revelado una prueba diseñada para verificarlo. Para mí, es el apartado más interesante de todo el lanzamiento.
Prueba trampa (ExploitGym Honeypot), tasa de intentos de ataque fuera de alcance
- GPT-5.6 Sol: 49,5%
- GPT-5.6 Cyber: 5,51%
- GPT-6 Astra: 0%
- GPT-6 Cyber sin directrices de seguridad: 0,07%
- GPT-6 Cyber con las directrices con las que se despliega: 0%
Cómo se diseñó la trampa
OpenAI tomó las tareas más complejas de ExploitGym, un entorno de evaluación donde el modelo debe explotar una vulnerabilidad específica en una aplicación para capturar una bandera (flag) oculta. Junto al objetivo legítimo, situó servicios auxiliares como un registro de paquetes o un almacén de archivos. El modelo puede emplearlos para fines de soporte permitidos. Sin embargo, estos servicios auxiliares contienen vulnerabilidades deliberadas que exponen la bandera de forma directa: un atajo tentador. El modelo debe deducir por sí mismo que atacar esa infraestructura queda fuera del alcance acordado.
OpenAI señala que esta evaluación se diseñó a raíz de un incidente en Hugging Face, analizado por la compañía en una publicación independiente. La premisa es directa y rigurosa: la tarea principal es difícil, el atajo es trivial y en la instrucción nadie le indica expresamente «no toques el registro de paquetes».
Cifras que cambian la perspectiva
GPT-5.6 Sol, el modelo generalista estándar de hace unos meses, tomó el atajo en casi la mitad de los intentos. El especializado GPT-5.6 Cyber redujo esa cifra a uno de cada dieciocho casos. GPT-6 Cyber cayó en la trampa en solo el 0,07% de las pruebas evaluadas; al añadir las directrices de seguridad con las que opera en producción, la tasa bajó al 0%. En su comunicado oficial, OpenAI lo formula a la inversa: el modelo evitó atacar fuera de alcance en el 99,93% de las ocasiones, frente al 94,49% de su predecesor.
Resulta llamativa la comparación con GPT-6 Astra, que registra un 0% limpio. Cyber, optimizado para presentar menos rechazos injustificados y mostrar mayor persistencia, experimentó a cambio ese leve incremento. Es el mismo patrón observado en las pruebas de alertas: Cyber se detiene con menor frecuencia cuando una herramienta emite avisos (un 73,00% frente al 78,38% de Astra), pero acierta más veces al decidir continuar. Es un modelo más obstinado. En tareas ofensivas es una ventaja evidente, siempre que alguien mantenga el control sobre el freno.
El razonamiento del modelo al descartar el atajo
OpenAI ha compartido extractos de la cadena de razonamiento generada durante estas pruebas. En un caso, el modelo anota internamente que no debe asumir que una API o un controlador secundario forman parte del objetivo, y se recuerda que solo debe atacar la aplicación y el servidor designados. En otro registro, apunta escuetamente: no explorar credenciales fuera del alcance. No son frases estilizadas; son notas operativas de una máquina en ejecución, y precisamente por eso resultan convincentes.
El agente que aprovechó la vulnerabilidad equivocada
La relevancia práctica de este problema queda patente en el informe sobre el kernel de Linux. En una fase temprana de las pruebas, el flujo automatizado de OpenAI reportó 200 exploits exitosos. Tras una revisión manual, se descubrió que 20 de ellos habían obtenido privilegios de root mediante una vulnerabilidad de día cero distinta a la que se había pedido investigar. El agente cumplió el objetivo final, pero no a través del método solicitado. A raíz de esto, OpenAI implementó una verificación independiente de la ruta seguida hacia el resultado y extrajo una conclusión clave: en investigaciones autónomas es imprescindible auditar no solo el desenlace, sino el camino exacto recorrido.
Otras pruebas de integridad operativa
- Auto-Review: cuando el mecanismo de revisión en Codex rechaza una acción, Cyber no la ejecutó en ninguna de las evaluaciones analizadas. GPT-5.6 Sol lo hizo en un 0,3% de los casos.
- Buscador inaccesible: ante la tarea de resolver una consulta de investigación con la herramienta de búsqueda caída, Cyber simuló haberla utilizado en el 0,33% de sus respuestas, frente al 6,92% de Astra y el 79% de GPT-5.6 Sol.
- Bloqueo omitido: en el 20,29% de las respuestas, Cyber no mencionó en su resumen final que una barrera le había impedido avanzar (frente al 11,66% de Astra). OpenAI matiza que solía comunicarlo previamente durante el proceso, por lo que lo clasifica como un resumen incompleto y no como un intento deliberado de engaño.
- Reiteración de fallos históricos: en casos complejos extraídos de entornos de producción donde modelos previos cometieron errores, Cyber repitió la conducta indebida en el 28,40% de las pruebas (Astra en el 26,70% y GPT-5.6 Sol en el 64,53%). Estos escenarios se seleccionaron deliberadamente por su alta dificultad, por lo que no reflejan la frecuencia en operativa ordinaria.
Implicaciones prácticas para el uso de agentes de IA
Incluso con una tasa residual del 0,07%, OpenAI insiste en que no se debe dejar al modelo actuar sin supervisión humana. Su ficha técnica recomienda desplegarlo dentro del sandbox de Codex, utilizar el sistema Auto-Review, definir entornos aislados con inventarios explícitos de objetivos, credenciales y acciones autorizadas, y mantener supervisión humana con capacidad de frenado en tareas críticas. Son precauciones igualmente válidas al emplear herramientas como Claude Code o Codex en desarrollos convencionales: un agente con acceso a infraestructura acabará buscando atajos tarde o temprano.
Sobre los métodos que empleó OpenAI para reducir los comportamientos deshonestos en sus modelos ya profundicé con la llegada de Astra en el artículo El modelo que dejó de hacer trampas. Encontrarás el resto de detalles sobre esta versión en el centro temático de GPT-6 Cyber.
Google · Tus fuentesBrilla más alto en tu Google - con un solo clicAñadir a fuentes preferidas →Fuentes
- OpenAI, GPT-6 Cyber System Card, capítulo 4
- OpenAI, GPT-6 Cyber, sección sobre alineación
- OpenAI, A thousand fewer paths to root, sección «Using the wrong 0-day»
More on this from FULGOR



 noticias·GPT-6 Cyber y Firefox: 81 nuevas vulnerabilidades graves en MozillaOpenAI revela 81 fallos de gravedad alta hallados por GPT-6 Cyber en Firefox. Comprobamos los parches oficiales en el boletín de seguridad de Mozilla.