ACE-Step 1.5 en local: generador de canciones con voz en RTX 4090
Analizo a fondo ACE-Step 1.5, un generador de música y voz en local con licencia MIT. Lo comparo frente a YuE2, MiniMax Music 3 y DiffRhythm 2 en mi RTX 4090.
👁 118 lecturas
ACE-Step 1.5 es un generador de música IA local y de código abierto bajo licencia MIT capaz de crear canciones completas con instrumentación y voz directamente en tu propia tarjeta gráfica. El 17 de octubre de 2026 probé este modelo en mi RTX 4090 para medir su rendimiento, su fidelidad vocal y su consumo exacto de VRAM en proyectos reales. Si buscas una visión de conjunto sobre qué herramientas ejecutar en tu propio equipo, puedes consultar mi guía sobre modelos de IA local para texto, imagen y vídeo.
A fecha de 17 de octubre de 2026
- ACE-Step 1.5 (creado por ACE Studio y StepFun, con pesos disponibles desde enero de 2026 y versión XL 4B lanzada el 2 de abril de 2026) cuenta con licencia MIT completa, válida para uso comercial.
- Modelo de difusión de 2B parámetros en variantes turbo, base y SFT, acompañado de un planificador (basado en Qwen3) en 0,6B, 1,7B y 4B.
- Integrado de forma nativa en ComfyUI mediante la plantilla oficial en el menú Templates con pesos de Comfy-Org.
- Mi banco de pruebas: RTX 4090 (24 GB VRAM), ComfyUI 0.41, ACE-Step 1.5 turbo con planificador 1.7B, evaluado con Whisper large-v3.
Qué es ACE-Step 1.5 y cómo funciona
ACE-Step 1.5 convierte una descripción estilística en lenguaje natural y una letra estructurada en una pista musical estéreo con voces sincronizadas. Su arquitectura se divide en dos bloques principales: un modelo lingüístico ligero que actúa como planificador transcribiendo la estructura a códigos de sonido y un modelo de difusión de 2B parámetros que genera el audio final. Según sus desarrolladores, admite desde fragmentos breves hasta composiciones de 10 minutos, más de 50 idiomas para la lírica y ejecución en tarjetas con menos de 4 GB mediante descarga de capas (offloading). Además de generar pistas desde cero, permite crear versiones, realizar repintado de fragmentos de audio (repainting) y añadir instrumentación sobre una voz aislada previa.
La licencia MIT marca una diferencia crítica frente a otras alternativas. En el ecosistema de pesos abiertos para audio, YuE2 está restringido exclusivamente a un uso no comercial (CC BY-NC 4.0), mientras que MiniMax Music 3 impone restricciones comunitarias con condiciones especiales para empresas de gran facturación. Con ACE-Step 1.5, las pistas resultantes se pueden integrar en proyectos comerciales sin cánones de licencia.
Cómo instalar y configurar este generador de música IA local en ComfyUI
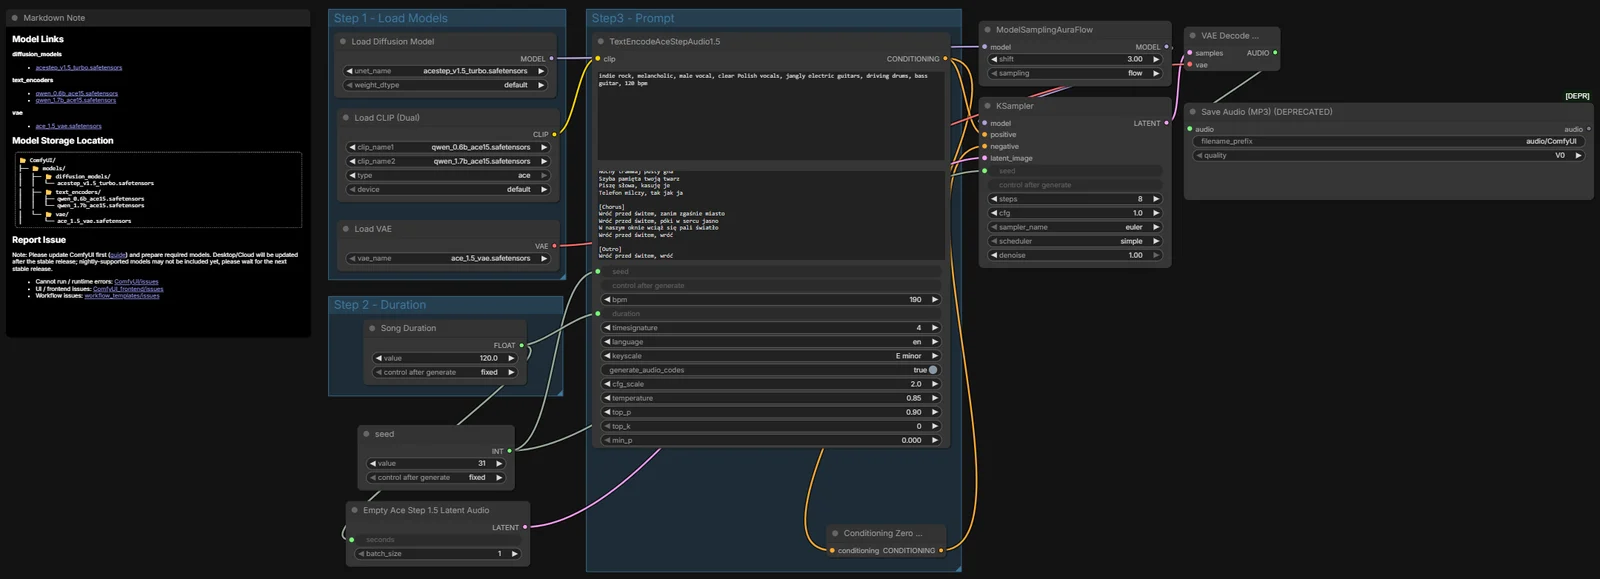
Para ejecutar ACE-Step 1.5 en Windows 11 utilizando ComfyUI de forma directa, sigue este procedimiento paso a paso:
- Actualiza ComfyUI a la versión 0.41 o superior.
- Accede al menú Templates, busca «ACE-Step 1.5» y selecciona la plantilla con archivos separados (split).
- Descarga los cuatro archivos necesarios desde el repositorio oficial de Hugging Face
Comfy-Org/ace_step_1.5_ComfyUI_filesy colócalos en sus respectivas carpetas:
models/diffusion_models/acestep_v1.5_turbo.safetensors (4,8 GB)
models/text_encoders/qwen_0.6b_ace15.safetensors (1,2 GB)
models/text_encoders/qwen_1.7b_ace15.safetensors (3,7 GB)
models/vae/ace_1.5_vae.safetensors (0,3 GB)- En el nodo TextEncodeAceStepAudio1.5, introduce las etiquetas de estilo musical (tags), la letra separada con bloques
[verse]y[chorus], el tempo, la tonalidad y el selector de idioma (ajusta el código adecuado, por ejemploeno el idioma deseado, ya que por defecto recurre al inglés). - Configura la duración en segundos tanto en el bloque de texto (duration) como en EmptyAceStep1.5LatentAudio (en la plantilla estándar ambos campos están sincronizados mediante el nodo «Song Duration»).
- Pulsa Run para iniciar la generación. El archivo renderizado se guardará en la carpeta
ComfyUI/output/audio.
Existe también una versión XL (4B) enfocada a mayor fidelidad sonora, pero su archivo de difusión en bf16 pesa 10 GB y su planificador 4B añade otros 8,4 GB. En una tarjeta de 24 GB es viable, pero en GPU de 12 GB requiere offloading intensivo.
Pruebas de rendimiento en RTX 4090: inglés y test multilingüe
Para comprobar la adherencia métrica de las voces, realicé mediciones directas transcribiendo las salidas con Whisper large-v3 para cuantificar de manera exacta la proporción de palabras cantadas respecto al texto original. La primera prueba consistió en un tema synthpop en inglés estilo años 80 con voz masculina. Posteriormente, para someter al sistema a un test multilingüe exigente, utilicé una letra en polaco de 83 palabras ambientada en Varsovia junto a un prompt idéntico: «Polish pop ballad, warm female vocals, piano and soft synth pads». El modelo se configuró en modo turbo (8 pasos) con el planificador de 1,7B parámetros y duración fijada en 120 segundos.
| Prueba | Palabras cantadas | Tiempo total | VRAM pico |
|---|---|---|---|
| Inglés, synthpop | 96,1% (73/76) | 8,0 s | 15,2 GB |
| Polaco, semilla 11 | 94,0% (78/83) | 35,2 s | 20,0 GB |
| Polaco, semilla 22 | 94,0% (78/83) | 91,4 s | 14,0 GB |
| Polaco, semilla 33 | 98,8% (82/83) | 34,1 s | 10,7 GB |
Durante la prueba en inglés con el modelo previamente cargado en VRAM, la generación de dos minutos completos de audio tardó únicamente 8 segundos en la RTX 4090, alcanzando un 96,1% de fidelidad de texto. En el test multilingüe, el modelo mantuvo una consistencia notable con un promedio del 95,6% de palabras reconocidas en tres pasadas consecutivas. El tiempo superior en la semilla 22 (91,4 s) se debió a la descarga y recarga de módulos de ComfyUI entre tareas, no a la velocidad pura de inferencia de la etapa de difusión.
Comparativa: ACE-Step 1.5 frente a YuE2, MiniMax Music 3 y DiffRhythm 2
Puse a competir a ACE-Step 1.5 contra otros tres motores locales el 17 de octubre de 2026 bajo las mismas condiciones de hardware y letras de referencia. La prueba en inglés evidenció que YuE2 y DiffRhythm 2 alcanzan una transcripción perfecta en textos anglosajones, pero sus requisitos de cómputo y restricciones de uso varían sustancialmente.
| Modelo | Inglés (Whisper) | Tiempo EN | Licencia |
|---|---|---|---|
| ACE-Step 1.5 turbo | 96,1% | 8 s | MIT (Comercial) |
| YuE2 (3B) | 100% | 32 s | CC BY-NC 4.0 (No comercial) |
| DiffRhythm 2 | 100% | ~60 s | Apache 2.0 (Comercial) |
| MiniMax Music 3 | 92,1% | 305 s | MiniMax Community (Restringida) |
En el test multilingüe con la letra en polaco (tres semillas evaluadas), las discrepancias entre modelos fueron mucho más pronunciadas:
- ACE-Step 1.5 turbo: 95,6% de media (94,0%, 94,0% y 98,8%). Es el único que permite declarar el idioma en los ajustes y respetó siempre la duración exacta de 120 segundos.
- YuE2 (bf16): 91,2% de media (98,8%, 90,4% y 84,3%). Logró la pasada individual más alta, pero mostró gran dispersión repitiendo versos de forma aleatoria.
- MiniMax Music 3: 89,2% de media. Acortó los temas arbitrariamente (entre 73 y 111 segundos pese a solicitar 150 s) y consumió entre 18,4 y 24,1 GB de VRAM.
- DiffRhythm 2: 4,8% en el test multilingüe. Al carecer de soporte fonético fuera del inglés y chino, generó balbuceos ininteligibles en otros idiomas.
Si tu flujo de trabajo no requiere voces cantadas sino pistas ambientales puras, suele ser más práctico acudir a Stable Audio 3 en local, que opera bajo la licencia Stability Community.
Tiempos de render y consumo de memoria VRAM
Los consumos máximos registrados en mi RTX 4090 reflejan el coste de memoria de cada solución durante ejecuciones reales:
El pico de 20,0 GB de VRAM en ACE-Step 1.5 se debe a la retención de modelos auxiliares en la memoria de ComfyUI; con la memoria purgada, el consumo basal osciló entre 10,7 y 14,0 GB. En contraste, MiniMax Music 3 saturó por completo el bus de la GPU con 24,1 GB, provocando ralentizaciones severas (hasta 305 segundos en generar una pista).
Qué modelo elegir según tus necesidades
- Producciones comerciales rápidas: ACE-Step 1.5 es la mejor opción actual. Su licencia MIT no impone restricciones, genera 2 minutos de audio en segundos mediante su paso turbo y respeta la estructura de tiempos fijada.
- Canciones en inglés de uso personal: YuE2 destaca por su modulación vocal en inglés (100% de inteligibilidad en mi prueba), pero su licencia CC BY-NC 4.0 prohíbe cualquier monetización.
- Proyectos multilingües: ACE-Step 1.5 ofrece soporte oficial para más de 50 idiomas con fidelidad fonética superior frente al resto de modelos locales probados.
- MiniMax Music 3: Solo recomendable si buscas específicamente su color tímbrico, asumiendo tiempos de espera muy superiores y una licencia comunitaria condicionada a facturación menor a 20 millones de USD anuales.
Preguntas frecuentes
¿Es posible usar comercialmente la música generada con ACE-Step 1.5?
Sí, la arquitectura y los pesos oficiales se distribuyen bajo licencia MIT, la cual permite la explotación comercial sin royalties. No obstante, debes tener en cuenta que las plataformas de streaming pueden aplicar normativas propias a las obras generadas por IA y la protección por derechos de autor puede diferir según la legislación de cada territorio.
¿Cuánta VRAM se necesita para ejecutar ACE-Step 1.5 en el PC?
En mi RTX 4090 con ComfyUI el consumo máximo osciló entre 10,7 y 20,0 GB según el estado de la memoria. Según las especificaciones de sus desarrolladores, es posible ejecutar el modelo 2B turbo en tarjetas de hasta 6 GB aplicando cuantización int8 y descarga de capas al procesador, mientras que entre 8 y 16 GB funciona cómodamente con el planificador 1.7B.
¿Qué diferencia hay entre ACE-Step 1.5 turbo, base y SFT?
La variante turbo está diseñada para ofrecer máxima velocidad mediante un muestreo de 8 pasos, permitiendo renderizar dos minutos de música en pocos segundos. Las versiones base y SFT operan a 50 pasos para maximizar la definición acústica a costa de un mayor tiempo de cómputo, estando la versión SFT ajustada específicamente para mayor calidad tímbrica.
¿Admite la generación de canciones en otros idiomas además del inglés?
Sí, sus desarrolladores documentan compatibilidad con más de 50 idiomas. En mi batería de pruebas multilingües con lírica compleja alcanzó un 95,6% de inteligibilidad promedio en Whisper large-v3, requiriendo únicamente configurar la etiqueta del idioma correspondiente en el nodo de texto de ComfyUI.
¿Puede ejecutarse este generador de música sin tarjeta gráfica dedicada?
El repositorio oficial cuenta con soporte para ejecutarse en CPU, además de compatibilidad con Apple Silicon (MPS), AMD (ROCm) e Intel (XPU). No obstante, la generación en procesador incrementa sustancialmente el tiempo de espera por pista en comparación con los 8 segundos medidos sobre una GPU acelerada por CUDA.
Fuentes
- Repositorio oficial de ACE-Step 1.5 en GitHub (licencia MIT).
- Ficha del modelo ACE-Step/Ace-Step1.5 en Hugging Face.
- Archivos empaquetados para ComfyUI en Comfy-Org.
- Repositorio de pesos YuE2-3B en Hugging Face (CC BY-NC 4.0).
- Ficha de MiniMaxAI/MiniMax-Music3 y licencia comunitaria.
- Repositorio de DiffRhythm 2 en GitHub.
- Mediciones propias en banco de pruebas RTX 4090, 17 de octubre de 2026, ComfyUI 0.41, evaluación con Whisper large-v3.
Comprobado el 17 de octubre de 2026.
More on this from FULGOR