Open WebUI y Ollama: instala un ChatGPT local sin Docker
Aprende a instalar Open WebUI junto a Ollama en Windows mediante uv, evitando Docker para disponer de una interfaz idéntica a ChatGPT que corre por completo en local.
👁 113 lecturas
Open WebUI es una interfaz web para el navegador que replica la experiencia visual de ChatGPT, pero conectándose directamente con modelos ejecutados en tu propio equipo para tener un entorno de IA local totalmente privado. Al combinar Open WebUI Ollama se obtiene un auténtico ChatGPT local capaz de operar como un ChatGPT sin conexión con historial, gestión de documentos y cuentas multiusuario. El 17 de octubre de 2026 actualicé el entorno a la versión 0.12.3 en Windows 11 sin Docker usando uv y medí su rendimiento frente a Gemma 4 12B y consultas sobre archivos PDF.
A fecha de 17 de octubre de 2026
- Versión más reciente: Open WebUI 0.12.3 del 16 de octubre de 2026. La serie 0.12 se publicó el 10 de octubre.
- Requiere Python 3.11 o 3.12; no funciona en Python 3.13. Se recomienda instalar mediante
uv, que descarga la versión adecuada automáticamente. - Licencia: Open WebUI License (base BSD-3 con cláusula de marca que prohíbe eliminar nombre y logotipo sin autorización, salvo que existan un máximo de 50 usuarios en 30 días o licencia corporativa). Su uso profesional o personal es gratuito.
- Espacio en disco: 1,8 GB (sin modelos). El servidor en reposo consume unos 800 MB de RAM.
Qué aporta Open WebUI frente a la consola
Open WebUI levanta un servidor web local en http://localhost:8080. No procesa la inferencia por sí mismo, sino que reenvía las peticiones a Ollama o a cualquier API compatible con OpenAI (como LM Studio o llama.cpp). Frente a la línea de comandos estándar de Ollama, añade:
- Historial organizado por carpetas, motor de búsqueda y exportación de conversaciones.
- Selector visual de modelos y modo comparativo simultáneo entre dos redes ante la misma pregunta.
- Sistema RAG integrado para subir archivos, crear bases de conocimiento y chatear con documentos.
- Gestión de usuarios locales con diferentes roles y permisos si compartes la máquina en red local.
- Interfaz con traducción automática según el idioma configurado en tu navegador web.
Instalación de Open WebUI con Ollama en Windows sin Docker
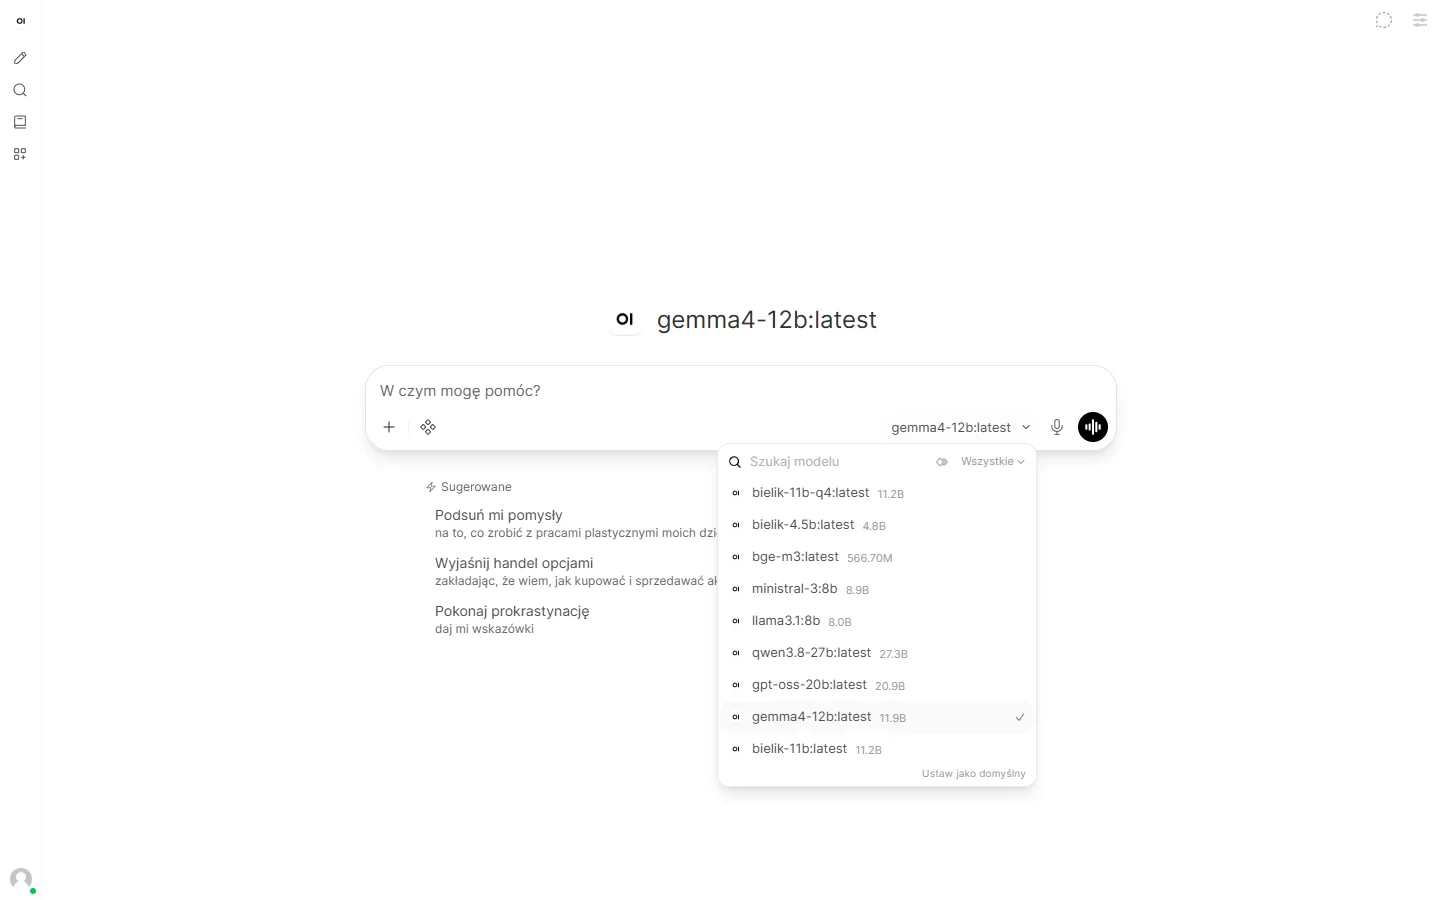
- Instala Ollama y descarga un modelo: Para las pruebas utilicé Gemma 4 12B (cuantización Q4_0 QAT de 7,0 GB). Si buscas configuraciones de mayor escala, puedes revisar el análisis de Gemma 4 31B en local.
- Instala uv: El gestor de paquetes de Astral se instala en PowerShell mediante
winget install astral-sh.uv. - Instala Open WebUI: Ejecuta la instalación aislada fijando la versión de Python recomendada:
uv tool install --python 3.11 open-webuiLa primera instalación me llevó 59 segundos el 3 de octubre, y la actualización de 0.11.4 a 0.12.3 tardó 1 minuto y 55 segundos mediante
uv tool upgrade open-webui. - Inicia el servidor monousuario: Para usarlo de forma individual sin contraseñas:
$env:WEBUI_AUTH = "False"
$env:DATA_DIR = "$HOME\open-webui-dane"
open-webui serve --host 127.0.0.1 --port 8080
La variable
WEBUI_AUTH=Falsedesactiva la pantalla de login,DATA_DIRdefine la carpeta donde se guardan las sesiones y--host 127.0.0.1restringe el acceso al equipo local. - Reconocimiento de comandos: Si PowerShell no encuentra el ejecutable, ejecuta una vez
uv tool update-shelly reinicia la terminal. - Tiempo de arranque: Con el directorio de datos vacío, el servidor tardó 81 segundos en completarse en su primer inicio; en arranques posteriores limpios estuvo listo en 31 segundos.
- Acceso: Abre
http://localhost:8080. Si Ollama está activo en segundo plano, sus modelos aparecerán inmediatamente en el menú desplegable.
Si prescindes de WEBUI_AUTH=False, el sistema solicitará crear una cuenta de administrador local. Para compartir la interfaz en una red interna de oficina, basta con cambiar el host a --host 0.0.0.0. Quienes prefieran contenedores disponen del comando oficial en la documentación: docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data -e WEBUI_SECRET_KEY=twoj-klucz --name open-webui --restart always ghcr.io/open-webui/open-webui:main.
Pruebas de rendimiento: Open WebUI frente a Ollama directo
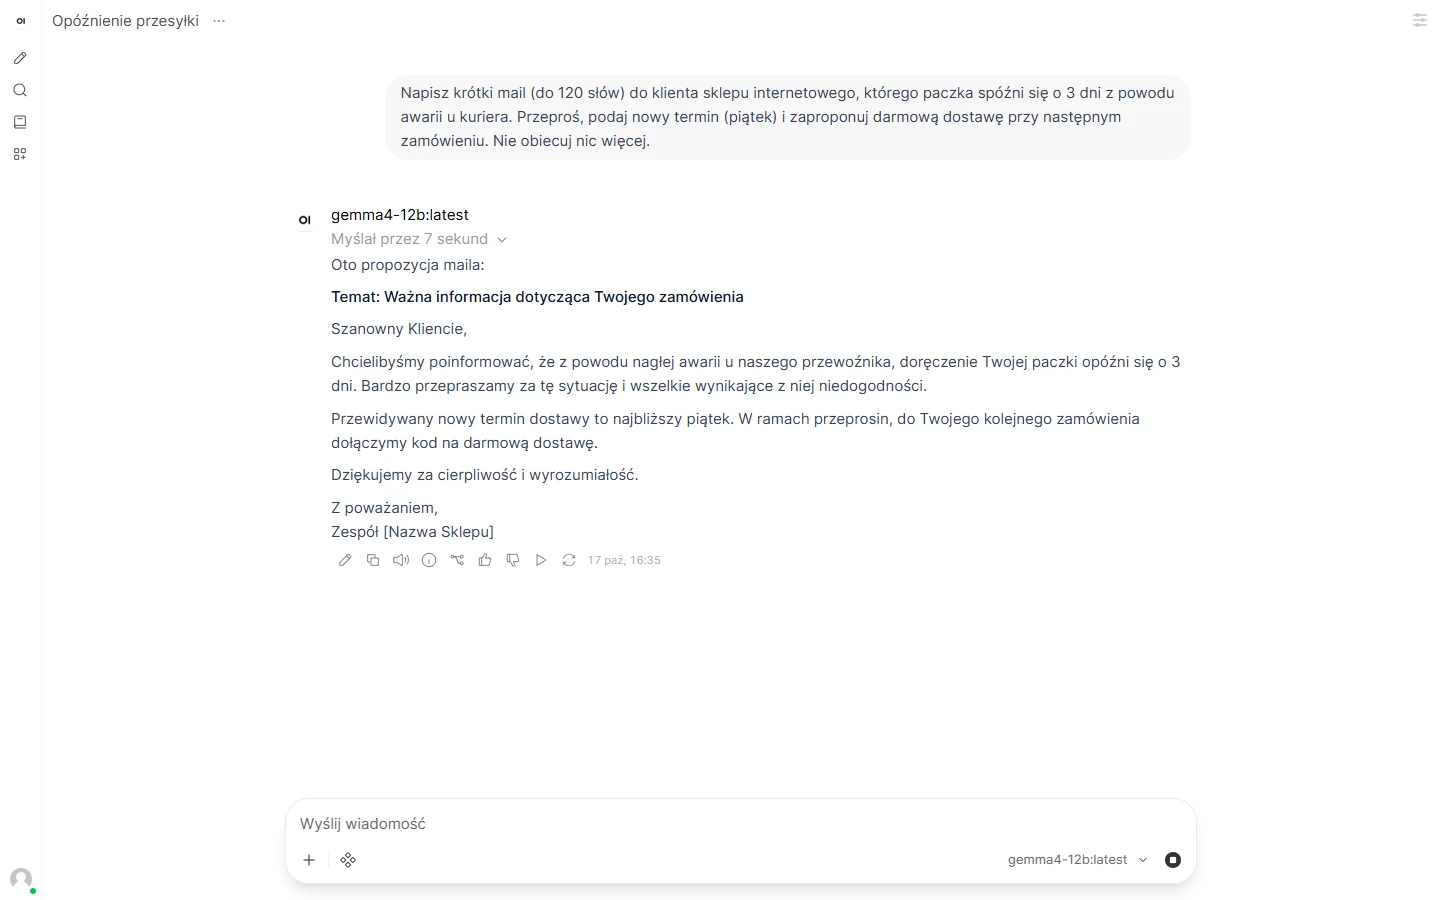
Realicé la prueba solicitando la redacción de un correo formal sobre un paquete retrasado que incluyera disculpas, entrega el viernes y envío gratuito en el siguiente pedido. Gemma 4 12B tardó 7 segundos de procesamiento previo antes de comenzar a generar el texto con los tres requisitos solicitados.
| Métrica (17.10.2026) | Open WebUI | Ollama directo |
|---|---|---|
| Primera respuesta (desde disco) | 36,8 s | - |
| Carga del modelo incluida | 19,9 s | - |
| Respuesta consecutiva | 17,4 s | 12,4 s |
| Velocidad de generación | 80-85 tok/s | 91,3 tok/s |
| Tokens del prompt inicial | 5694 | 95 |
| Pico de VRAM ocupada | 9,7 GB | - |
Equipo de prueba: tarjeta gráfica RTX 4090 de 24 GB, procesador i9-14900KF, 64 GB de RAM, Windows 11 y Ollama 0.40.5. Al almacenar los modelos en una unidad USB externa, la carga inicial tardó casi 20 segundos. Antes de iniciar, el sistema registraba 1,4 GB de VRAM ocupada, por lo que el modelo en ejecución consumió unos 8,4 GB netos.
El dato más revelador reside en los tokens de entrada. En la consola de Ollama el prompt requirió 95 tokens, mientras que Open WebUI elevó la cifra a 5694 tokens. Esto se debe a que la versión 0.12 inyecta definiciones de herramientas integradas (memoria, notas, búsqueda en conversaciones y archivos) en el contexto de cada interacción. En una GPU con 24 GB esto supone perder solo un 10% de velocidad; sin embargo, en tarjetas de 8 GB ese volumen de tokens de contexto puede provocar desbordamientos de memoria. Estas funciones pueden desactivarse en los ajustes del modelo. Puedes contrastar estos requerimientos de hardware en el análisis sobre el coste real entre modelos locales y APIs.
Prueba de RAG: análisis y chat con documentos PDF
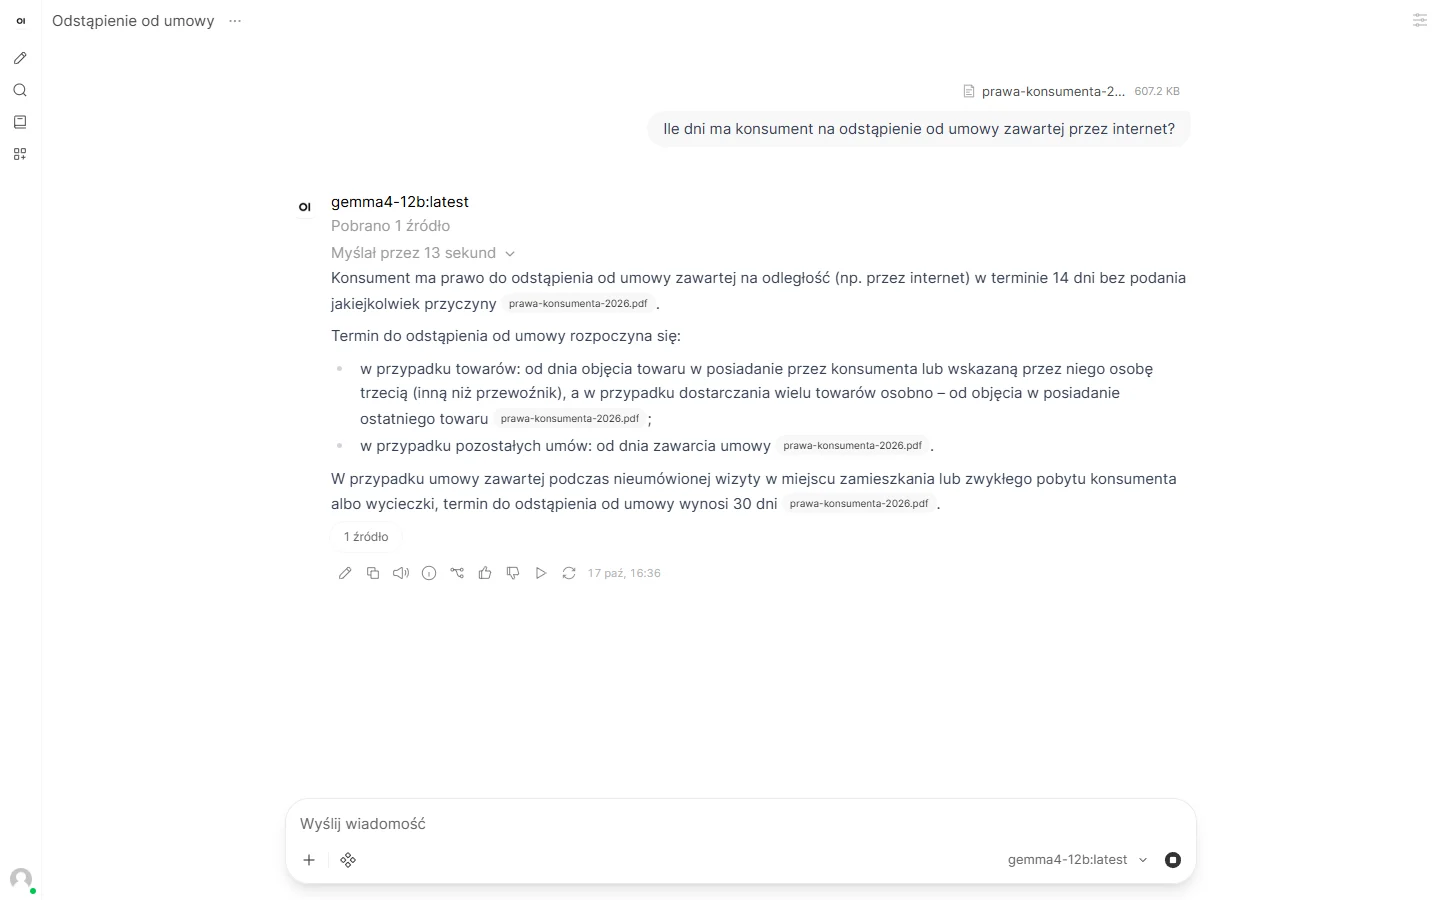
Para procesar documentos, Open WebUI fragmenta el archivo, genera embeddings vectoriales y recupera los fragmentos pertinentes en cada pregunta. Por defecto utiliza all-MiniLM-L6-v2 (orientado a inglés). Para mejorar la precisión con material multilingüe, configuré bge-m3 ejecutado desde la propia Ollama:
- Descarga en consola:
ollama pull bge-m3(1,2 GB). - Configuración: Menú de usuario en la esquina inferior izquierda, Ajustes, sección Administración, apartado Documentos. Selecciona Ollama como motor de embeddings e introduce
bge-m3:latest. Pulsa en guardar. - Reindexación: Los documentos subidos con anterioridad deben reindexarse para actualizar sus vectores.
Cargué un documento legal en formato PDF de 607 KB relativo a derechos del consumidor y le formulé 10 preguntas con respuesta explícita en el articulado. La indexación vectorial se completó en 6,6 segundos.
| Configuración evaluada | Aciertos | Tiempo respuesta |
|---|---|---|
| Open WebUI 0.12.3 + bge-m3 + Gemma 4 12B | 8 / 10 | 12-39 s |
| Script RAG dedicado (segmentación por artículos) | 9 / 10 | 10-25 s |
| Gemma 4 12B directa (sin documento adjunto) | 5 / 10 | 12-15 s |
En las dos respuestas fallidas, Open WebUI admitió honestamente no localizar el dato en el texto. La primera respuesta tardó 76 segundos al cargar simultáneamente en memoria Gemma 4 12B y el modelo bge-m3, elevando el consumo máximo de VRAM a 10,8 GB.
Script de inicio automático para Windows PowerShell
El siguiente script automatiza la comprobación de Ollama, instala uv, descarga Open WebUI y bge-m3 en caso de no encontrarlos, y lanza la interfaz en modo monousuario sin telemetría:
# open-webui-start.ps1 - instaluje (jesli trzeba) i uruchamia Open WebUI z Ollama na Windows 10/11.
# Stan na 17.10.2026 (Open WebUI 0.12.3, Ollama 0.40).
# Uzycie (PowerShell):  powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1
# Opcje: -Folder "D:\czaty"  -Port 8081  -BezPrzegladarki
# Zatrzymanie: Ctrl+C w tym oknie.
param(
    [string]$Folder = "$HOME\open-webui-dane",
    [int]$Port = 8080,
    [switch]$BezPrzegladarki
)
$ErrorActionPreference = 'Stop'

function Test-Url($u) {
    try { Invoke-RestMethod -Uri $u -TimeoutSec 3 | Out-Null; return $true } catch { return $false }
}

# 1. Ollama musi byc zainstalowana i uruchomiona
if (-not (Get-Command ollama -ErrorAction SilentlyContinue)) {
    Write-Host 'Brak Ollamy. Zainstaluj ja poleceniem:  winget install Ollama.Ollama' -ForegroundColor Red
    exit 1
}
if (-not (Test-Url 'http://127.0.0.1:11434/api/version')) {
    Write-Host 'Ollama nie odpowiada. Uruchom aplikacje Ollama i sprobuj ponownie.' -ForegroundColor Red
    exit 1
}

# 2. uv (menedzer Pythona od Astral) - sam pobierze Pythona 3.11
if (-not (Get-Command uv -ErrorAction SilentlyContinue)) {
    Write-Host 'Instaluje uv przez winget...'
    winget install --id astral-sh.uv -e
    $env:Path = [Environment]::GetEnvironmentVariable('Path', 'User') + ';' + [Environment]::GetEnvironmentVariable('Path', 'Machine')
}

# 3. Open WebUI jako osobne narzedzie (nie rusza Twojego Pythona)
$exe = Join-Path $HOME '.local\bin\open-webui.exe'
if (-not (Test-Path $exe)) {
    Write-Host 'Instaluje Open WebUI (ok. 1,8 GB, kilka minut)...'
    uv tool install --python 3.11 open-webui
}

# 4. Model do wyszukiwania w dokumentach, ktory zna polski
$modele = @((Invoke-RestMethod -Uri 'http://127.0.0.1:11434/api/tags').models | ForEach-Object { $_.name })
if ($modele -notcontains 'bge-m3:latest') {
    Write-Host 'Pobieram bge-m3 do dokumentow (1,2 GB)...'
    ollama pull bge-m3
}
if (@($modele | Where-Object { $_ -ne 'bge-m3:latest' }).Count -eq 0) {
    Write-Host 'Uwaga: w Ollamie nie ma jeszcze modelu do rozmowy.' -ForegroundColor Yellow
}

# 5. Ustawienia: jeden uzytkownik bez logowania, tylko ten komputer, bez telemetrii
New-Item -ItemType Directory -Force -Path $Folder | Out-Null
$env:DATA_DIR = $Folder
$env:WEBUI_AUTH = 'False'
$env:OLLAMA_BASE_URL = 'http://127.0.0.1:11434'
$env:ENABLE_OPENAI_API = 'False'
$env:RAG_EMBEDDING_ENGINE = 'ollama'
$env:RAG_EMBEDDING_MODEL = 'bge-m3:latest'
$env:ANONYMIZED_TELEMETRY = 'false'
$env:DO_NOT_TRACK = 'true'
$env:SCARF_NO_ANALYTICS = 'true'
$env:PYTHONIOENCODING = 'utf-8'

# 6. Start serwera i otwarcie przegladarki, gdy bedzie gotowy
Write-Host "Startuje Open WebUI na http://localhost:$Port (pierwszy start trwa 1-2 minuty)..."
$p = Start-Process -FilePath $exe -ArgumentList @('serve', '--host', '127.0.0.1', '--port', "$Port") -NoNewWindow -PassThru
$t = Get-Date
while (-not (Test-Url "http://127.0.0.1:
El arranque se realiza mediante powershell -ExecutionPolicy Bypass -File .\open-webui-start.ps1 y la detención pulsando Ctrl+C en la consola activa.
Comparativa: Open WebUI, LM Studio o Jan
| Característica | Open WebUI | LM Studio | Jan |
|---|---|---|---|
| Formato | Interfaz web | App de escritorio | App de escritorio |
| Backend | Ollama o APIs externas | Motor nativo | Nativo (llama.cpp) |
| Multiusuario en red | Sí | No | No |
| Instalación | Comando en consola | Instalador clásico | Instalador clásico |
| Licencia de uso | Open WebUI License | Gratuito (cerrado) | Apache 2.0 |
Open WebUI es la opción adecuada si buscas una experiencia idéntica a ChatGPT con RAG avanzado o si vas a compartir la GPU entre varios usuarios en tu red de trabajo. LM Studio encaja mejor si prefieres una aplicación gráfica tradicional sin terminal, y Jan es ideal si buscas software de código abierto con instalador directo.
Resolución de incidencias comunes
- Aviso Python 3.13 is not supported: Ejecuta
uv tool install --python 3.11 open-webuipara que el entorno use la versión 3.11 de manera encapsulada. - Desplegable de modelos vacío: Ollama no se está ejecutando o escucha en otro puerto. Verifica con
ollama listy revisa la variableOLLAMA_BASE_URL. - Error de puerto 8080 en uso: Cambia el parámetro de arranque a
--port 8081. - Generación más lenta que en terminal: Desactiva en el panel de administración las tareas automáticas posteriores (generación de títulos, etiquetas y sugerencias de seguimiento).
Preguntas frecuentes
¿Es Open WebUI completamente gratuito?
Sí, su uso tanto particular como en entornos comerciales es 100% gratuito. La única restricción reside en su cláusula de marca, que exige licencia de pago si deseas eliminar los logotipos oficiales en despliegues con más de 50 usuarios en un plazo de 30 días.
¿Puede funcionar como un ChatGPT sin conexión a internet?
Sí, una vez completada la instalación y descargados los modelos en Ollama, toda la inferencia se procesa de forma local sin enviar datos fuera de tu equipo. Configurando la variable de entorno OFFLINE_MODE=True se desactiva también la verificación de actualizaciones en la red.
¿Cómo se conecta Open WebUI con Ollama?
Por defecto la conexión es automática si ambos programas corren en la misma máquina bajo la dirección http://127.0.0.1:11434. Si el servidor de Ollama se encuentra en otra máquina de la red local, basta con indicar la IP correspondiente en la variable OLLAMA_BASE_URL.
¿Es obligatorio instalar Docker para usar Open WebUI?
No, Docker es únicamente una de las alternativas de despliegue. Mediante el gestor uv o el instalador pip estándar se ejecuta de forma nativa en Windows sin necesidad de crear contenedores.
¿Se pueden conectar modelos comerciales como Claude o ChatGPT?
Sí, la interfaz admite añadir claves de API y endpoints compatibles con OpenAI en su menú de configuración de conexiones. Al utilizarlos, las peticiones saldrán hacia los servidores externos correspondientes bajo sus tarifas habituales.
¿Cómo se actualiza Open WebUI a la última versión?
Basta con ejecutar en PowerShell el comando uv tool upgrade open-webui. Todos tus chats, documentos y configuraciones previas se conservan intactos en la carpeta de datos designada.
Fuentes consultadas
- Open WebUI GitHub Releases (versión 0.12.0 del 10.10.2026 y versión 0.12.3 del 16.10.2026)
- Términos de la Open WebUI License
- Documentación oficial de Open WebUI: Guía de inicio rápido
- Ficha técnica del paquete open-webui en PyPI
- Pruebas de rendimiento e instalación en entorno local: Windows 11, RTX 4090, Ollama 0.40.5, Open WebUI 0.12.3 (mediciones del 17 de octubre de 2026).
Comprobado el 17 de octubre de 2026.
More on this from FULGOR