Wan 3.0 a prueba: el modelo de vídeo con IA que crea clips con audio
Analizamos Wan 3.0 de Alibaba: vídeo de hasta 30 s con audio nativo, creación desde documentos PDF y número 1 en el ranking de Artificial Analysis.
👁 113 lecturas
Wan 3.0 de Alibaba encabeza el ranking de generación de vídeo de Artificial Analysis: 1335 puntos Elo en la categoría de texto a vídeo, por delante de Gemini Omni Flash y MiniMax H3. Genera hasta 30 segundos de vídeo en una sola pasada, con audio integrado, y es capaz de crear una pieza audiovisual a partir de un documento. Hemos invertido 7,10 dólares en ponerlo a prueba: cinco clips que incluyen diálogo sincronizado, texto complejo en pantalla, un plano secuencia de 30 segundos y un vídeo creado directamente desde un archivo PDF. A continuación repasamos qué funciona a la perfección y qué se queda corto.
Las cantidades en EUR son conversiones orientativas de los precios publicados en USD, calculadas con el tipo de referencia del BCE del 2026-10-12: 1 EUR = 1.1181 USD. No son precios locales confirmados ni importes finales con impuestos. El proveedor y el banco pueden aplicar otros tipos o cargos. ECB.
Veredicto en un párrafo
Wan 3.0 es capaz de hablar y escribir texto con una precisión sorprendente. Lo hemos puesto a prueba en polaco: el diálogo «Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.» («No me iré sin ti. ¿Me oyes? No me iré.») se reprodujo palabra por palabra, y el neón «ŻÓŁTA GĘŚ» («Oca amarilla») apareció con todos sus caracteres diacríticos intactos. El plano continuo de 30 segundos sin cortes mantuvo la coherencia del personaje y la secuencia de acciones de principio a fin. Sus puntos débiles: el texto en letra pequeña se deforma, el tiempo de generación oscila entre 3 y 14 minutos, el filtro de moderación bloqueó una escena cotidiana en un mercado y la función para generar vídeo desde la URL de una web falló en nuestros dos intentos. Sin embargo, generar vídeo a partir de un PDF funcionó de forma impecable.
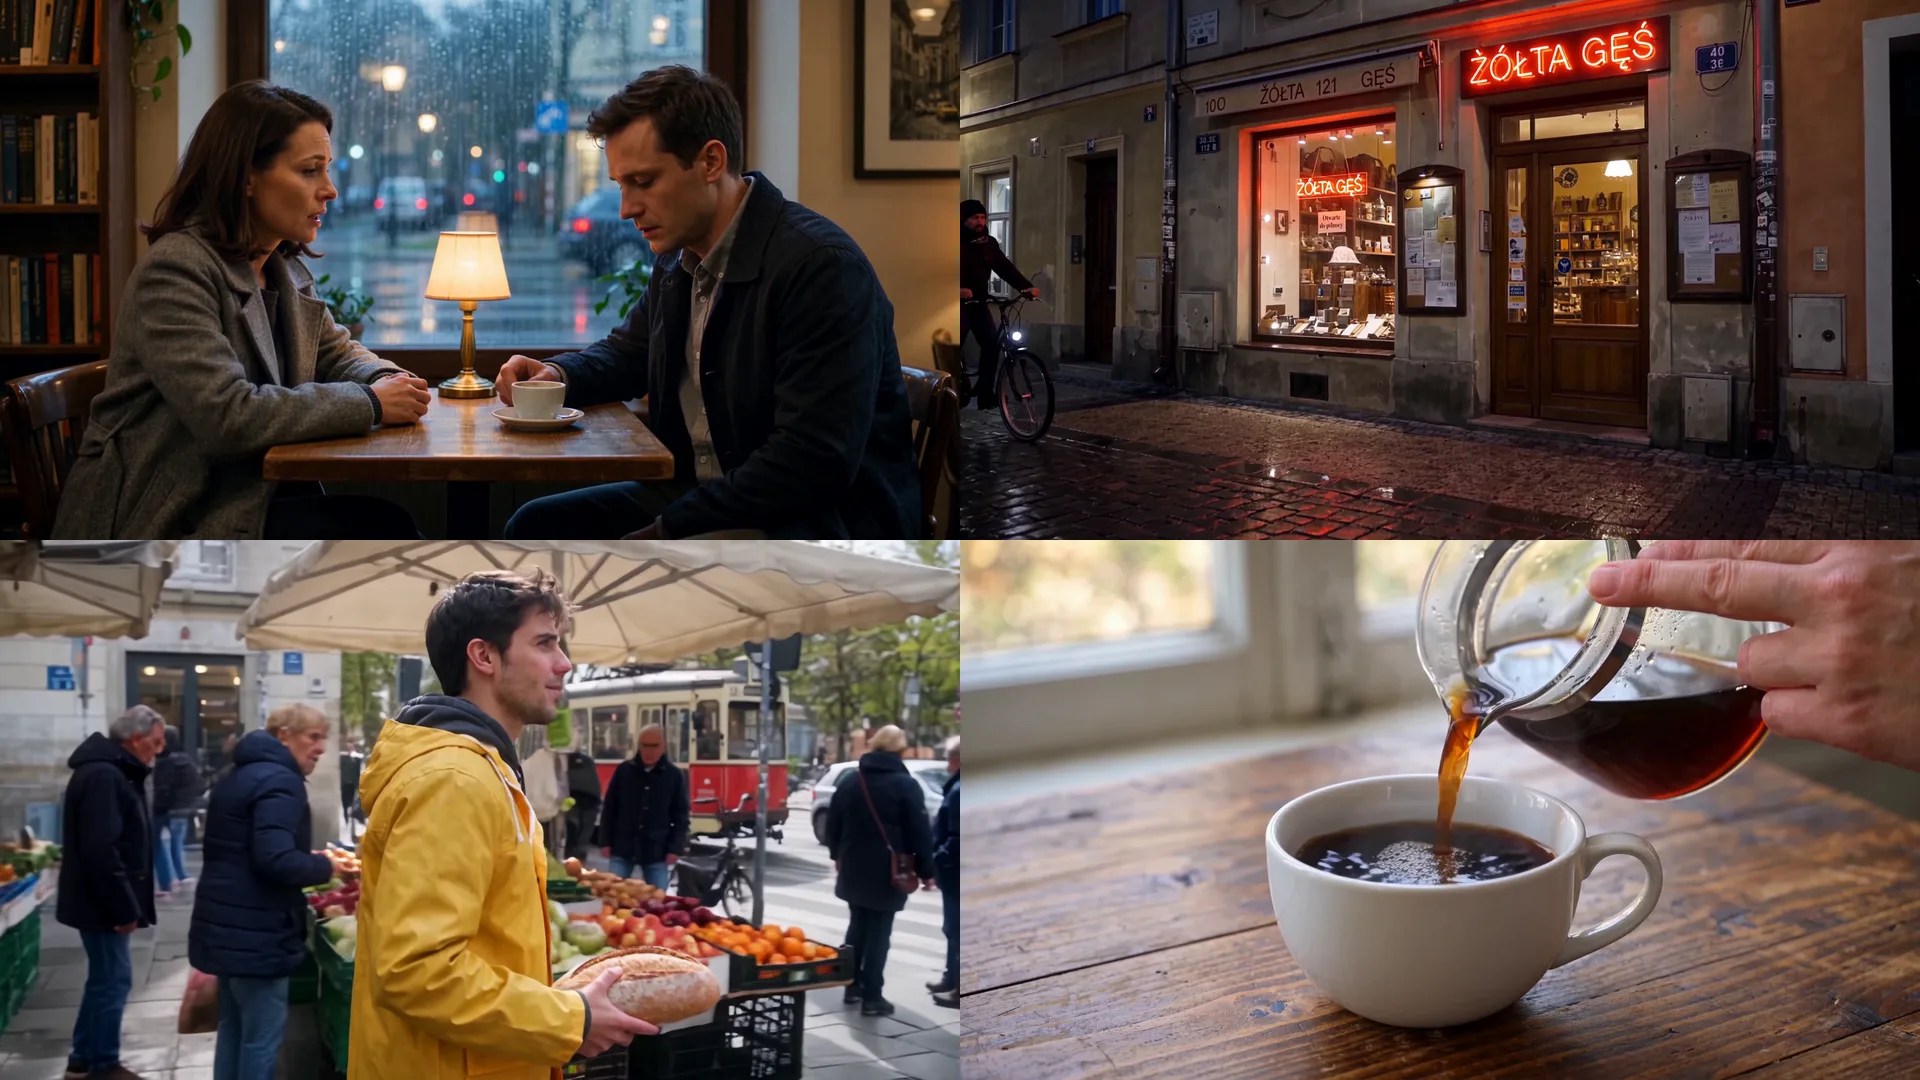
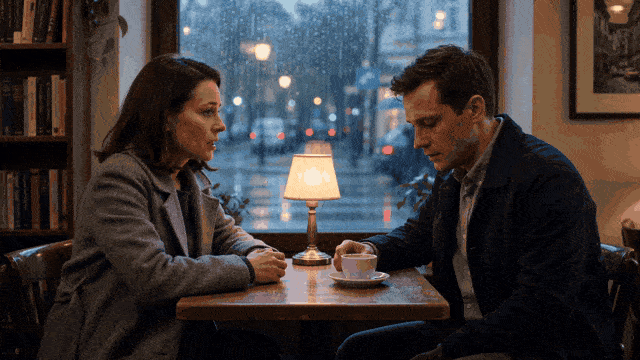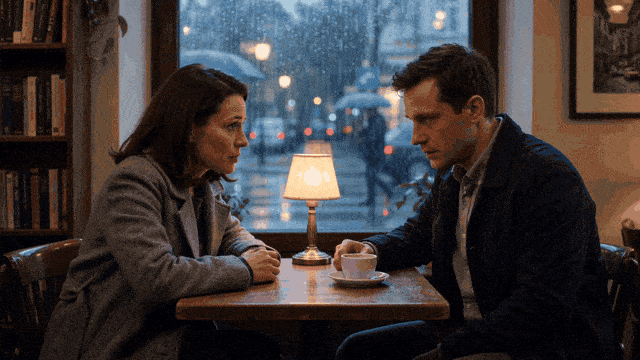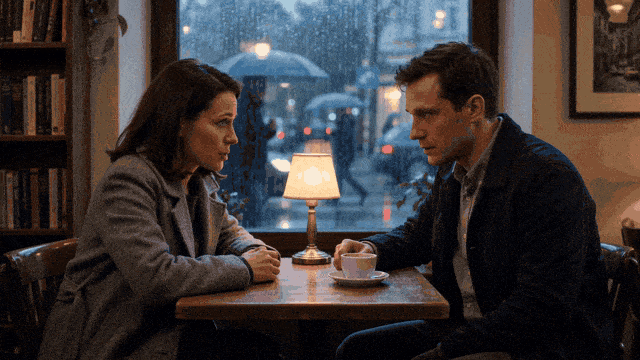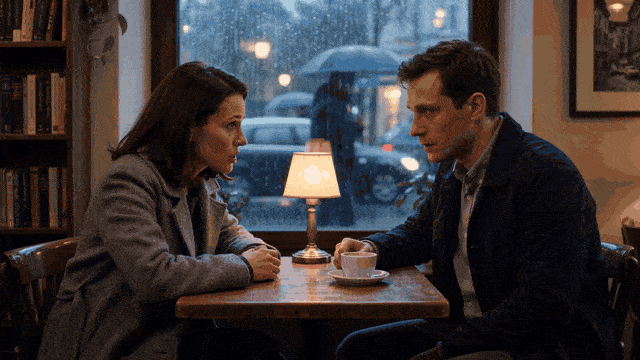
Cuatro fotogramas de nuestras pruebas con Wan 3.0: diálogo, neón en pantalla, toma continua de 30 segundos y vertido de café en 720p sin retoques.
Especificaciones técnicas y precios de Wan 3.0
| Parámetro | Wan 3.0 |
|---|---|
| Desarrollador | Alibaba (Alibaba Cloud) |
| Fecha de anuncio | 13 de agosto de 2026 |
| Duración máxima | 30 segundos en una sola pasada |
| Resolución | 480p, 720p, 1080p |
| Entrada admitida | Texto, imágenes, audio, vídeo y documentos: PDF, DOC, XLS, PPT, TXT, MD, Keynote, Pages, Numbers (1 archivo de hasta 100 MB y 50 páginas) |
| Audio | Generado de forma conjunta con la imagen |
| Precio en Alibaba Cloud Model Studio | 0,05 / 0,10 / 0,1789 EUR (0,20 USD) por segundo (480p / 720p / 1080p) |
| 30 segundos en 1080p | 5,37 EUR (6 USD) |
| Pesos abiertos | No - solo disponible mediante API |
| Clasificación en Artificial Analysis (texto a vídeo) | 1.er puesto, 1335 Elo |
Esta misma tarifa es la que ofrece fal.ai, plataforma a través de la cual hemos realizado nuestras pruebas. También disponen de la variante Wan 3.0 Prime, más rápida, a 0,1252 EUR (0,14 USD) por segundo en 720p.
Liderazgo ajustado en el ranking de vídeo con IA
| Puesto | Modelo | Desarrollador | Elo |
|---|---|---|---|
| 1 | Wan 3.0 | Alibaba | 1335 |
| 2 | Gemini Omni Flash | 1332 | |
| 3 | MiniMax H3 | MiniMax | 1302 |
| 4 | HappyHorse-1.0 | Alibaba (ATH) | 1286 |
Tres puntos de ventaja frente a Gemini Omni Flash representan prácticamente un empate técnico en un sistema de puntuación basado en elecciones a ciegas por parte de usuarios humanos. Un detalle llamativo: HappyHorse, en cuarta posición, también pertenece a Alibaba pero a otra división interna (ATH), lo que sitúa a dos equipos independientes del mismo grupo empresarial entre los cuatro primeros puestos.
Prueba 1: diálogo y sincronización de voz
El prompt describía una cafetería en una tarde lluviosa y dos líneas de diálogo en polaco: una mujer dice «Nie wyjadę bez ciebie. Słyszysz? Nie wyjadę.» («No me iré sin ti. ¿Me oyes? No me iré.») y el hombre responde «Wiem.» («Lo sé.»).
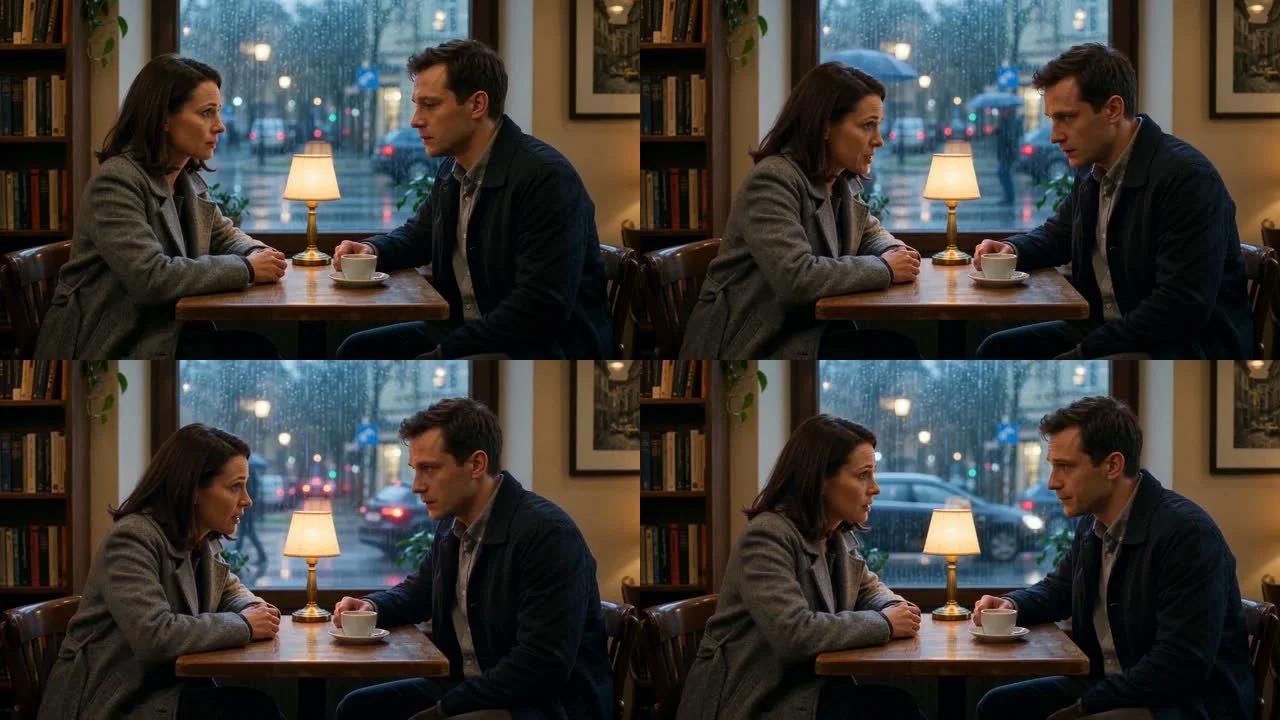
Cuatro fotogramas de un clip de 8 segundos. Los personajes, la mesa, la lámpara y la lluvia tras la ventana mantienen la coherencia en toda la toma.
Pasamos la pista de audio resultante por el sistema de transcripción Whisper. El resultado: las frases se pronunciaron con total nitidez, palabra por palabra, y el idioma se identificó con un 99% de certeza. Las líneas aparecen en el orden exacto solicitado: la primera entre el segundo 0 y el 4, y la respuesta en el segundo 5. Supone un salto cualitativo real frente a herramientas anteriores como Seedance, donde los diálogos en lenguas no dominantes ni siquiera se articulaban.
Coste del test: 0,80 USD. Tiempo de generación: 3 minutos y 38 segundos.
Prueba 2: renderizado de texto y cartelería
Planteamos una calle nocturna en un casco antiguo con un neón rojo que debía mostrar «ŻÓŁTA GĘŚ» («Oca amarilla») y un cartel en el escaparate con el texto «Otwarte do północy» («Abierto hasta medianoche»), combinando múltiples caracteres especiales y tildes complejas.
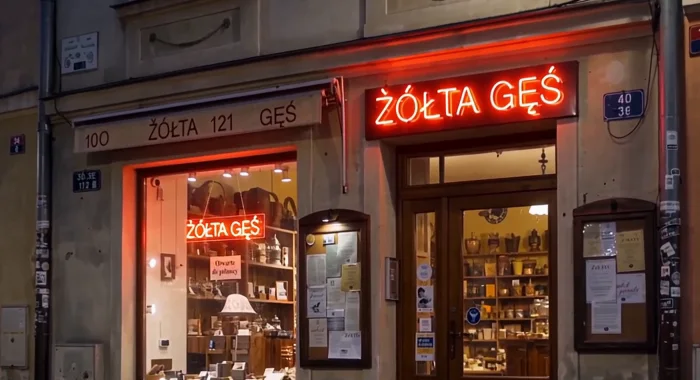
Neón ŻÓŁTA GĘŚ con los caracteres correctos por duplicado, ya que el modelo añadió un segundo letrero en el escaparate.
El neón principal quedó impecable, con cada signo en su sitio, e incluso duplicado, ya que el modelo añadió un segundo letrero dentro del escaparate por iniciativa propia. También incorporó un rótulo que decía «100 ŻÓŁTA 121 GĘŚ», con ortografía correcta pero añadiendo números no solicitados.
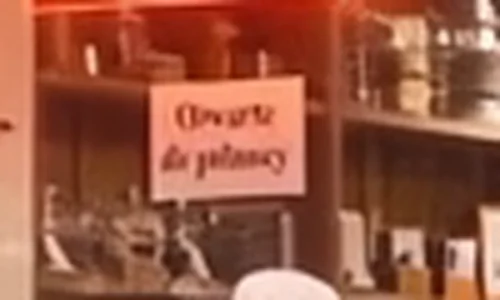
Ampliación del cartel en la ventana. La primera palabra es legible, el resto del texto aparece distorsionado.
El cartel en papel marca el límite actual: la primera palabra («Otwarte») se lee con claridad, pero el resto («do północy») aparece deformado. Al trabajar en 720p y con letras de apenas unos píxeles de altura, el modelo no retiene la estructura tipográfica. La propia Alibaba reconoce en su comunicado que la fidelidad del texto integrado en escena sigue en fase de mejora. La conclusión práctica: carteles grandes y titulares funcionan; la letra pequeña, todavía no.
Prueba 3: coherencia física y movimiento de manos
Plano estático de detalle: unas manos sirven café desde una jarra de cristal, el chorro disminuye hasta cortarse por completo, una mano levanta la taza y la otra añade un terrón de azúcar.
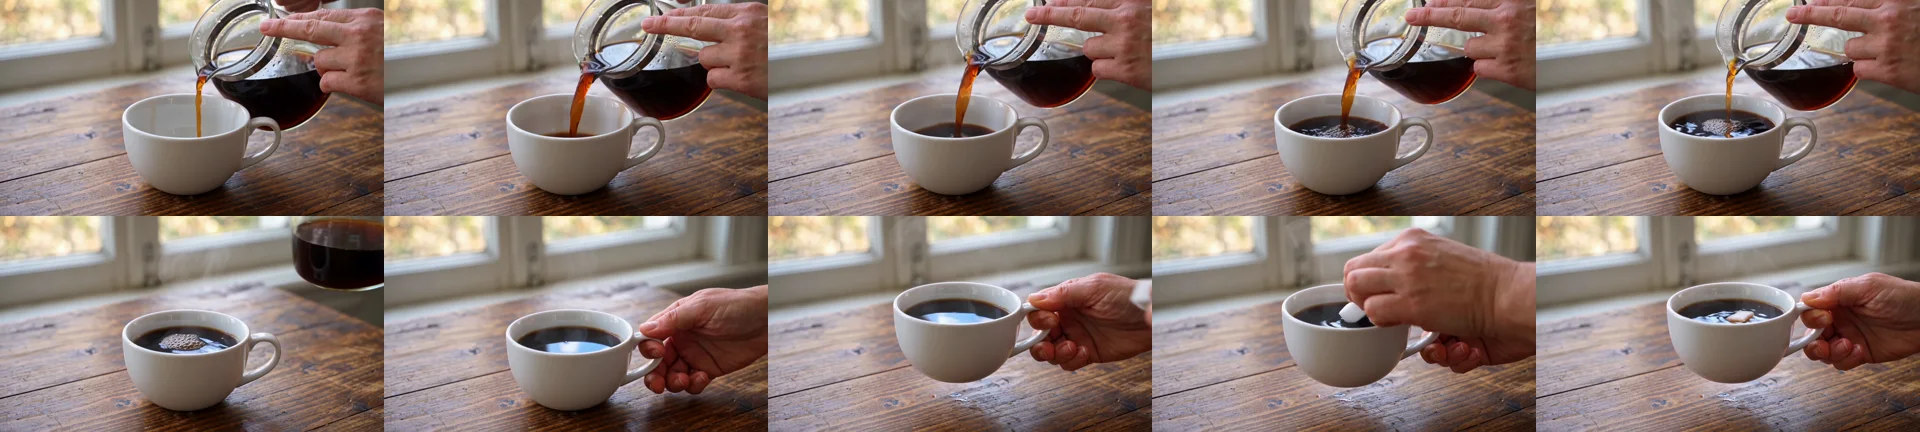
Diez fotogramas tomados cada segundo. El flujo de café se detiene hacia el segundo 6, la mano eleva la taza y el terrón cae en el segundo 9.
El comportamiento del líquido, el vapor, el corte del chorro y el movimiento articular de las manos resultan muy naturales, y la cronología coincide con las instrucciones. Al revisar los fotogramas segundo a segundo, la anatomía de los dedos se mantiene sin fallos evidentes. Coste: 0,8944 EUR (1,00 USD); tiempo: 4 minutos.
Prueba 4: plano secuencia de 30 segundos sin cortes
El reto más exigente: un plano continuo cámara en mano de 30 segundos. Un joven con chaqueta amarilla cruza un mercado al aire libre, pasa junto a puestos de fruta y pescado, compra una barra de pan, paga, asiente con la cabeza y sale a la calle cuando cruza un tranvía.
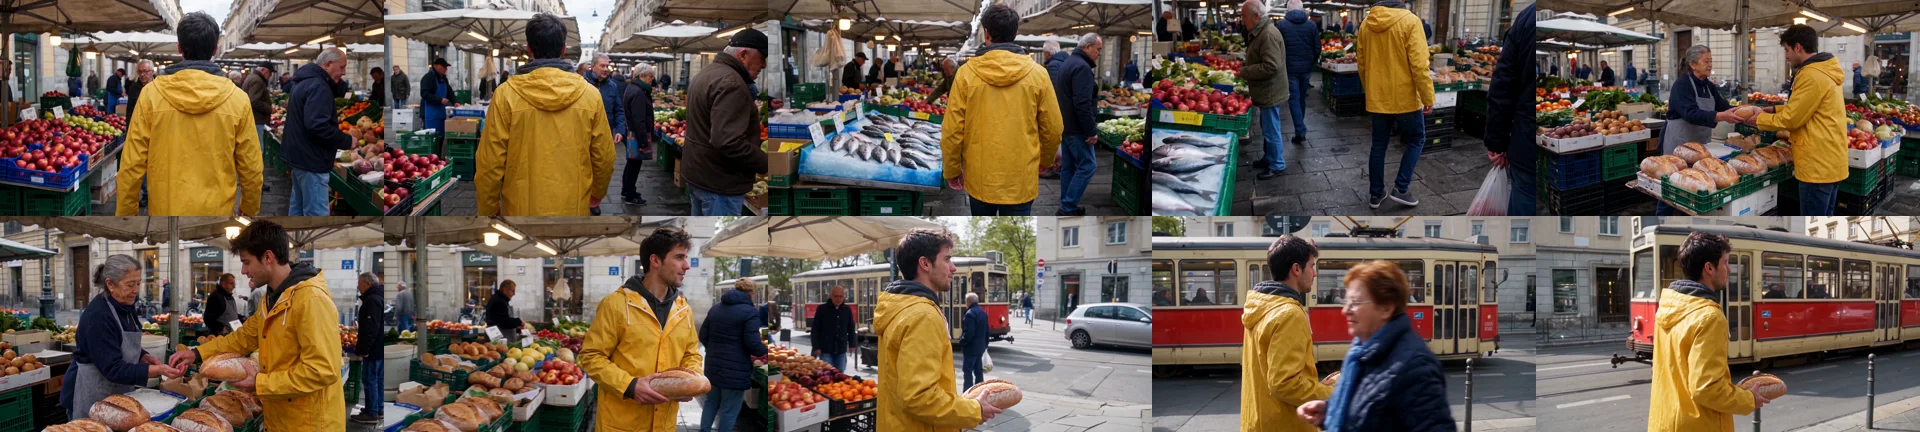
Diez fotogramas tomados cada 3 segundos en una única toma continua de 30 segundos con puestos de fruta, panadería y tranvía.
Todos los acontecimientos siguen el orden solicitado y el sujeto mantiene una coherencia total durante los 30 segundos: mismos rasgos faciales, misma prenda y el pan sujeto en la mano. El detector de cortes de plano en ffmpeg solo marcó una alerta entre el segundo 20 y el 22; tras revisar esas imágenes cada cuarto de segundo, comprobamos que se trataba de un paneo rápido y fluido detrás del protagonista, no de un corte de edición. La única desviación respecto al prompt fue atmosférica: la calle se mostró nublada en lugar de soleada.
No obstante, esta prueba tuvo un contratiempo técnico: en el primer intento, el filtro de moderación de fal.ai bloqueó la generación alegando que el contenido infringía las políticas del sistema. La escena no contenía nada más allá de puestos de comida, pan y un tranvía. Un segundo intento con idéntico texto se completó sin problemas. El sistema de moderación resulta, por tanto, no determinista y propenso a falsos positivos, algo frustrante cuando la notificación llega tras un cuarto de hora de espera. La versión válida tardó 13 minutos y 35 segundos en generarse y costó 3 USD.
Prueba 5: generación de vídeo a partir de un documento
Esta es una de las capacidades más destacadas por Alibaba en el lanzamiento: proporcionas un archivo o un enlace web y el modelo elabora una pieza audiovisual basada en ese contenido. Hemos probado ambas vías.
| Intento | Resultado |
|---|---|
| URL de un artículo web | Error: fallo al leer la página tras aproximadamente 20 minutos de espera |
| URL de un artículo de Wikipedia | Error devuelto por el proveedor de la API |
| Enlace a un PDF de Wikipedia sin extensión .pdf en la URL | Rechazado de inmediato (la dirección debe finalizar obligatoriamente con la extensión del archivo) |
| Mismo archivo PDF subido directamente al almacenamiento de fal.ai | Completado con éxito: vídeo de 15 s, 10,5 minutos de generación, 1,34 EUR (1,50 USD) |
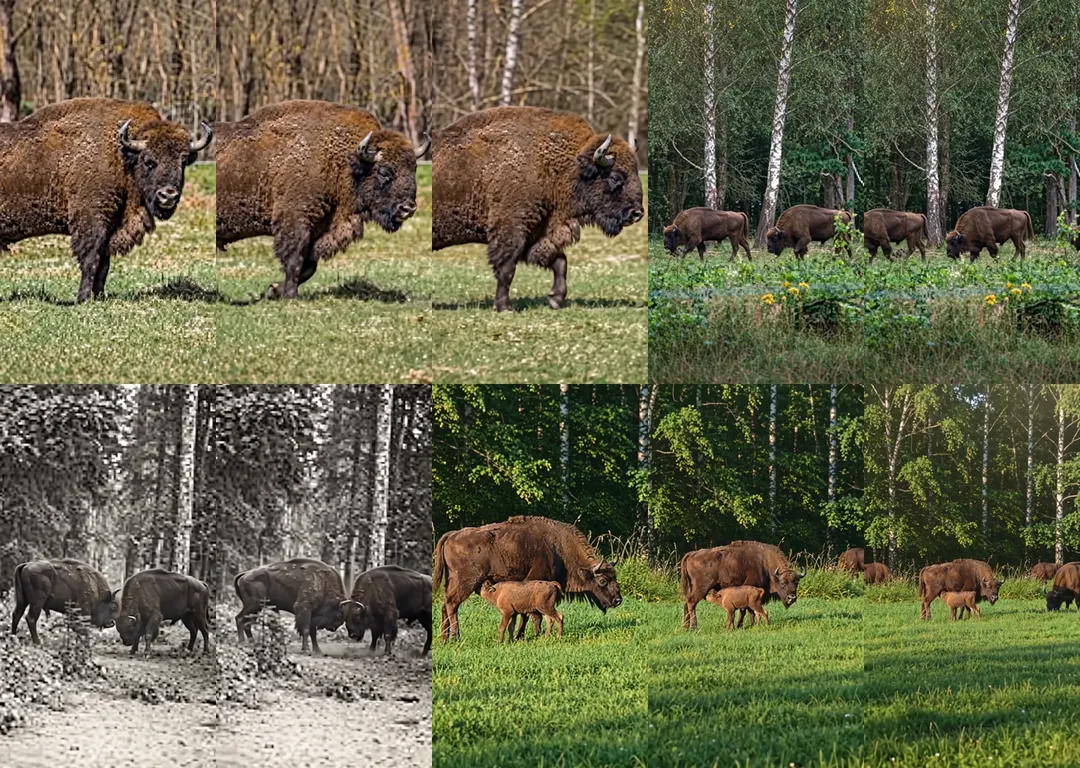
Fotogramas de un vídeo de 15 segundos creado a partir del PDF de Wikipedia sobre el bisonte europeo, con cuatro tomas temáticas.
El resultado con el PDF resultó ser el más sorprendente de la comparativa. El modelo estructuró de forma autónoma un montaje de cuatro tomas (el análisis de ffmpeg detectó tres transiciones en los segundos 2,8, 8,2 y 10,2): un primer plano del animal, una manada en un bosque de abedules, un plano en blanco y negro con estética documental de archivo y una hembra con su cría. Además, integró una voz en off en inglés: «Meet the European bison, Europe’s largest land mammal. Once nearly extinct, they now roam these primeval forests.», resumiendo datos reales del documento. La narración se generó en inglés porque el prompt se envió en dicho idioma, a pesar de que el PDF fuente estaba en polaco. Nuestra conclusión es que, si se desea la locución en otro idioma específico, conviene solicitarlo explícitamente en la instrucción.
Balance: la conversión de documento a vídeo funciona muy bien cuando se carga el archivo directamente, pero la lectura remota de páginas web falló en todos nuestros intentos a través de fal.ai.
Costes reales de las pruebas
| Clip generado | Duración | Coste | Tiempo de renderizado |
|---|---|---|---|
| Diálogo hablado | 8 s | 0,7155 EUR (0,80 USD) | 3 min 38 s |
| Física y vertido de café | 10 s | 0,8944 EUR (1,00 USD) | 4 min 4 s |
| Rótulo de neón | 8 s | 0,7155 EUR (0,80 USD) | 3 min 17 s |
| Toma continua de 30 segundos | 30 s | 2,68 EUR (3,00 USD) | 13 min 35 s |
| Vídeo desde documento PDF | 15 s | 1,34 EUR (1,50 USD) | 10 min 27 s |
| Total acumulado | 71 s | 6,35 EUR (7,10 USD) |
Los importes corresponden a la tarifa de 0,0894 EUR (0,10 USD) por segundo generado en resolución 720p. El tiempo de procesamiento medio se situó en unos 25 segundos de cómputo por cada segundo de vídeo resultante. Para flujos de trabajo en tiempo real resulta lento, pero para preproducción publicitaria y creación de contenido para redes sociales entra dentro de lo razonable.
¿Para quién merece la pena Wan 3.0?
- Para creadores que necesitan voz sincronizada y texto en pantalla: la capacidad de generar diálogos articulados y letreros legibles sin recurrir a postproducción externa es un salto notable frente a otros modelos.
- Para equipos que convierten informes en contenido audiovisual: resumir una presentación o un PDF técnico en un vídeo explicativo corto ahorra horas de edición.
- No apto para flujos con prisas: los tiempos de espera rondan entre 3 y 14 minutos por clip, con riesgo ocasional de bloqueos injustificados en el filtro.
- Poco fiable para tipografía diminuta: cartelas pequeñas, listas de precios o etiquetas de productos siguen sufriendo artefactos visuales.
Para profundizar en los costes de la generación de vídeo: cuánto cuesta un segundo de vídeo con IA. Si te interesan otros lanzamientos del ecosistema chino: análisis y pruebas de cinco modelos de lenguaje.
Más sobre IA local: modelos de texto, imagen y vídeo ejecutados en tu propio equipo · banco de pruebas de 7 modelos locales
Comparativas relacionadas: gama Wan AI: versiones, precios y pruebas en vídeo · Wan 3.0 frente a Wan 2.2 con los mismos prompts
Preguntas frecuentes sobre Wan 3.0
¿Wan 3.0 puede hablar en otros idiomas?
Sí. En nuestras pruebas generó frases completas con dicción clara en idiomas distintos al inglés, logrando una tasa de reconocimiento del 99% mediante Whisper.
¿Cuánto cuesta usar Wan 3.0?
Los precios oficiales en Model Studio son de 0,0447 EUR (0,05 USD) por segundo en 480p, 0,0894 EUR (0,10 USD) en 720p y 0,1789 EUR (0,20 USD) en 1080p. Una secuencia completa de 30 segundos en 1080p cuesta 6 USD.
¿Wan 3.0 es de código abierto?
No. A diferencia de algunas versiones previas de la familia Wan, Wan 3.0 no ofrece pesos descargables abiertos; su acceso es exclusivamente a través de API, como Alibaba Cloud Model Studio o fal.ai.
¿Cuál es la duración máxima de vídeo que puede generar?
Alcanza hasta 30 segundos en un solo pase. Nuestro clip de 30 segundos fue una toma continua sin cortes y requirió 13 minutos y medio de renderizado.
¿Es capaz de crear un vídeo a partir de un PDF?
Sí. En nuestro análisis generó una pieza de 15 segundos con locución y varios cambios de plano a partir de un PDF. El archivo debe cargarse directamente o proporcionarse mediante un enlace que termine con la extensión correspondiente; introducir URLs de páginas web genéricas provocó errores en nuestras pruebas.
Fuentes y metodología
Fecha de anuncio oficial, duraciones, resoluciones, tipos de documentos admitidos, límites por archivo y precios base extraídos del blog oficial de Alibaba Cloud. Tarifas de Wan 3.0 Prime y parámetros de llamada procedentes de la documentación de fal.ai. Puntuaciones del ranking de texto a vídeo procedentes de Artificial Analysis. Todos los datos fueron consultados el 24 de septiembre de 2026. Todos los clips mostrados han sido generados por nuestro equipo el 24 de septiembre de 2026 mediante la API de fal.ai a 720p con audio activado, tomando el primer resultado válido de cada test. Las transcripciones de audio se procesaron con el modelo small de Whisper. Las imágenes integradas corresponden a fotogramas directos extraídos de los archivos de vídeo sin retoque digital; las transiciones y cortes se verificaron manualmente fotograma a fotograma y con el filtro scdet de ffmpeg.
More on this from FULGOR


 benchmarks·OpenAI lanza GPT-6.1 Sol con rendimiento casi igual al GPT-6 Astra pero a una quinta parte del precio