Artificial Analysis evalúa modelos de decisión: Jev 1.13 lidera
Artificial Analysis lanza el Decision Index v1.0: Jev 1.13 encabeza la tabla con 58 puntos. Consulta la comparativa de costes, latencia y rendimiento.
👁 119 lecturas
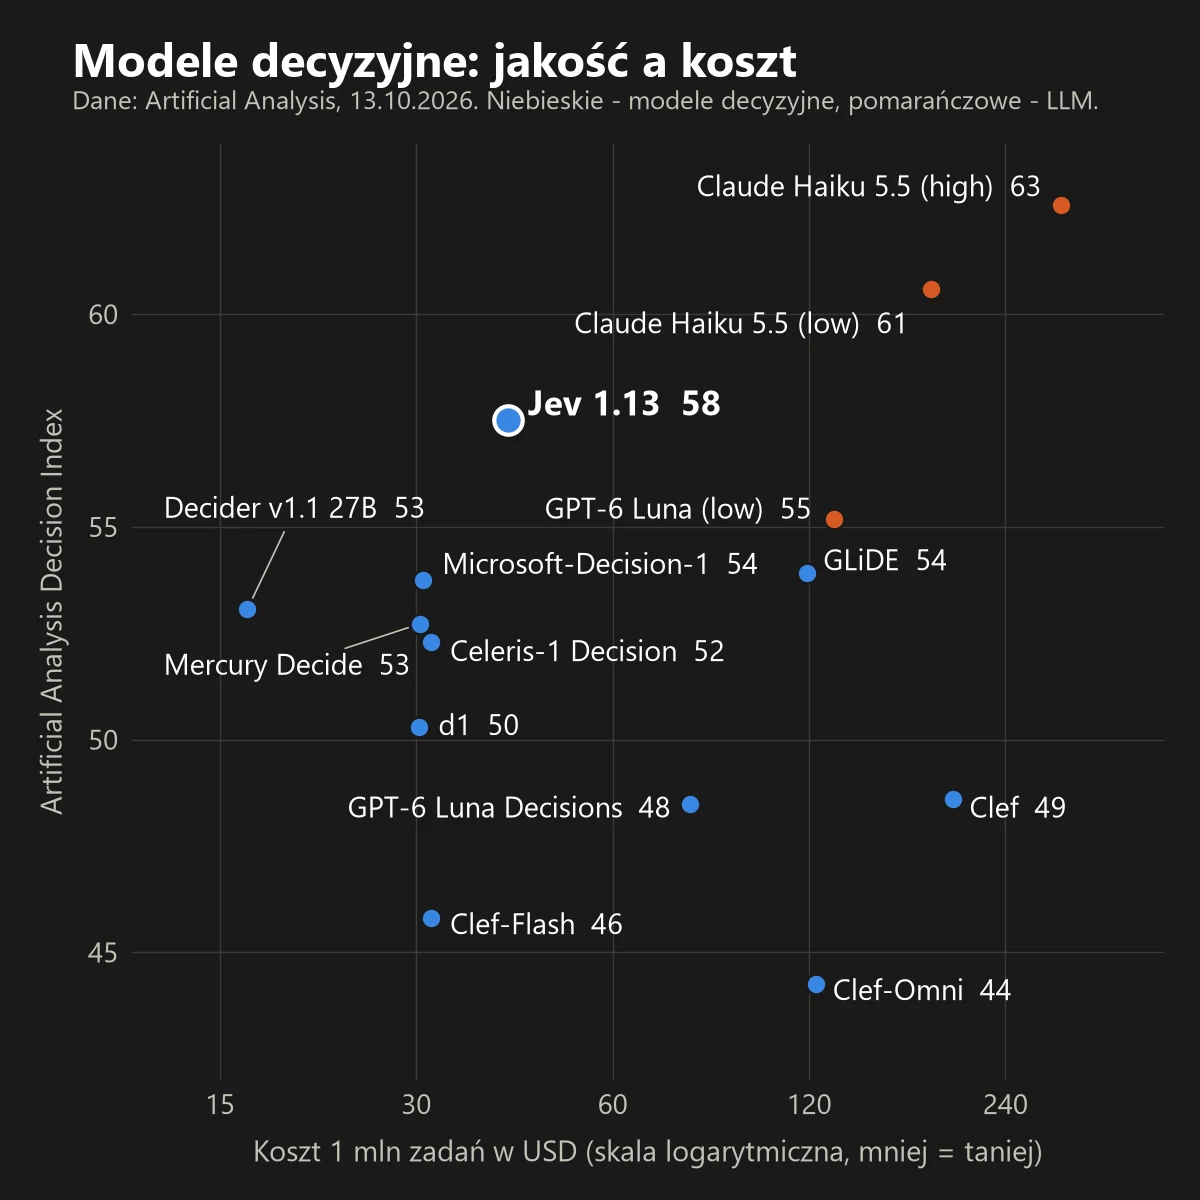
El 13 de octubre de 2026, Artificial Analysis publicó el Decision Index v1.0, la primera clasificación independiente de modelos de decisión: modelos de IA que no redactan texto, sino que seleccionan respuestas de una lista cerrada e indican la probabilidad de cada opción. A la cabeza se sitúa Jev 1.13 de TypeSafe con 58 puntos, superando a GLiDE (Fastino) y a Microsoft-Decision-1 (ambos con 54). El más económico es Decider v1.1 27B de Perplexity: unos 15,20 EUR (17 USD) por millón de tareas. Un LLM convencional como Claude Haiku 5.5 logra una puntuación mayor (61), pero según las mediciones de AA resulta 11 veces más lento y 4,4 veces más caro que el líder.
Cifras clave (Artificial Analysis, 13/10/2026)
- 11 modelos de decisión en el ranking (9 de ellos analizados en el informe inicial).
- Líder: Jev 1.13 (TypeSafe) - 58 puntos, unos 37,56 EUR (42 USD) por millón de tareas, 0,13 s por tarea.
- Coste por millón de tareas: desde aprox. 15,20 EUR (17 USD con Decider v1.1 27B) hasta 177,98 EUR (199 USD con Cloudflare Clef).
- Latencia por tarea: de 0,06 s (Celeris-1 Decision) a 0,5 s (Mercury Decide).
- Claude Haiku 5.5 (low): 61 puntos, aprox. 164,56 EUR (184 USD) por millón de tareas, 1,4 s por tarea.
*Conversiones a EUR estimadas según el tipo de cambio de referencia del BCE del 12/10/2026 (1 EUR = 1,1181 USD): fuente del BCE.
Declaración de transparencia: conozco el modelo Jev por un proyecto previo; en septiembre desarrollé un cliente de API sencillo enfocado a mis propias herramientas editoriales. TypeSafe no ha encargado ni remunerado este artículo, y la posición de Jev se analiza exclusivamente a partir de las mediciones independientes de Artificial Analysis.
Qué es un modelo de decisión
Un modelo de decisión recibe dos elementos: un estado (por ejemplo, el texto de una incidencia de soporte) y un listado de preguntas con opciones de respuesta cerradas. En lugar de generar una frase, devuelve una probabilidad para cada opción autorizada. Artificial Analysis lo ejemplifica con una reclamación del tipo «los pagos llevan 3 días sin funcionar y mañana tengo que pagar el alquiler», evaluando tres preguntas simultáneas (traducción del caso de prueba):
- A qué departamento dirigirlo: pagos, soporte técnico o gestión de cuenta (selección de lista).
- ¿Es urgente?: sí o no.
- Nivel de frustración del cliente: calmado, frustrado, enfadado (escala).
El modelo de decisión responde a las tres cuestiones en una única llamada y entrega la distribución de probabilidades. Un LLM estándar necesita generar un JSON completo que luego el software debe procesar, sin ofrecer además un indicador riguroso de su nivel de certeza real. He analizado este funcionamiento en detalle en la guía sobre modelos de decisión de IA, donde probamos casos reales en polaco.
Clasificación: Artificial Analysis Decision Index v1.0
| Modelo (proveedor) | Índice | Coste 1M tareas | Tiempo por tarea |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 58 | ~37,56 EUR (42 USD) | 0,13 s |
| GLiDE (Fastino Labs) | 54 | ~106,43 EUR (119 USD) | 0,22 s |
| Microsoft-Decision-1 (Microsoft) | 54 | ~27,73 EUR (31 USD) | 0,21 s |
| Decider v1.1 27B (Perplexity) | 53 | ~15,20 EUR (17 USD) | 0,17 s |
| Mercury Decide (Inception) | 53 | ~26,83 EUR (30 USD) | 0,50 s |
| Celeris-1 Decision (Celeris) | 52 | ~28,62 EUR (32 USD) | 0,06 s |
| d1 (Liquid AI) | 50 | ~26,83 EUR (30 USD) | 0,30 s |
| Clef (Cloudflare) | 49 | ~177,98 EUR (199 USD) | 0,31 s |
| GPT-6 Luna Decisions (OpenAI) | 48 | ~70,66 EUR (79 USD) | 0,17 s |
| Clef-Flash (Cloudflare) | 46 | ~28,62 EUR (32 USD) | 0,30 s |
| Clef-Omni (Cloudflare) | 44 | ~110,01 EUR (123 USD) | 0,17 s |
Como referencia, los modelos de lenguaje evaluados en las mismas pruebas obtuvieron: Claude Haiku 5.5 (low) 61 puntos con aprox. 164,56 EUR (184 USD) y 1,4 s; GPT-6 Luna (low) 55 puntos con aprox. 117,16 EUR (131 USD) y 1,5 s. El tiempo corresponde a la mediana por tarea, mientras que el coste representa el gasto medio por tarea según las tarifas de tokens vigentes multiplicado por un millón (estimaciones en EUR convertidas desde USD con referencia del BCE del 12/10/2026). Los modelos de decisión solo facturan por los tokens de entrada; los LLM cobran tanto la entrada como la salida.
Cómo se calcula el índice
El Decision Index es la media ponderada de cuatro pruebas al 25% cada una:
- AA-Omniscience-Decision (conocimiento y alucinaciones): 500 preguntas no públicas con cinco opciones (cuatro respuestas y la opción «no lo sé»). La mitad del peso premia el acierto y la otra mitad el porcentaje de ocasiones en que el modelo reconoce que no sabe responder en vez de inventar.
- HLE-MultiChoice (razonamiento): 513 preguntas de opción múltiple basadas en texto de Humanity’s Last Exam, uno de los conjuntos de pruebas más exigentes para la IA actual.
- When2Call (uso de herramientas): test diseñado por NVIDIA donde el modelo analiza una conversación junto a una lista de funciones para decidir si responde directamente, ejecuta una herramienta, solicita más datos o declara que no puede completarlo.
- WildGuardTest (clasificación y seguridad): batería de Ai2 que evalúa si una petición de usuario es perjudicial, si la respuesta de un asistente supone un rechazo y si dicha respuesta entraña algún riesgo.
Qué revelan los resultados
- Jev se impone en razonamiento: logra 21 puntos en HLE-MultiChoice, mientras ningún otro modelo de decisión supera los 15. En conocimiento general obtiene un 35% de precisión (el mejor en este apartado es d1 de Liquid AI con un 41%).
- Microsoft-Decision-1 es el mejor reconociendo dudas: responde «no lo sé» en el 40% de los casos inciertos (Jev 35%, Mercury Decide 32%, el resto por debajo del 17%). d1, pese a su alta precisión factual, casi nunca admite desconocer un dato (puntuación de 2).
- Superan a los LLM en llamadas a herramientas: en When2Call, Celeris-1 Decision y GLiDE alcanzan 84 puntos, frente a los 73 de Claude Haiku 5.5 (low) y los 77 de GPT-6 Luna (low).
- Rendimiento superior en moderación y clasificación: en WildGuardTest, GLiDE obtiene 95, Jev y Decider 94, Claude Haiku 5.5 (low) 93 y GPT-6 Luna (low) 89.
- Exceso de confianza generalizado: AA comparó las probabilidades declaradas con el acierto real; en conocimiento y razonamiento, el acierto queda por debajo de la confianza indicada. En clasificación y herramientas, la calibración se considera «razonablemente buena».
Por qué son más económicos que un LLM convencional
Un modelo de decisión prescinde de generar tokens de texto secuenciales. Procesa el texto de entrada una sola vez, calcula la distribución estadística de todas las opciones solicitadas de golpe y finaliza el proceso. Esto aporta tres ventajas claras:
- Solo pagas por la entrada: no hay consumo de tokens de salida ni de tokens de razonamiento intermedio.
- Múltiples respuestas en una llamada: evita redactar campos de un JSON palabra por palabra.
- Latencias en centésimas de segundo: entre 0,06 y 0,5 s por tarea, frente a los 1,4-1,5 s de los modelos de lenguaje pequeños en modo económico.
La diferencia económica escala notablemente con el volumen. En tareas exclusivas de clasificación (WildGuardTest), AA calculó un coste por millón de unos 10,82 EUR (12,1 USD) para Decider y unos 20,39 EUR (22,8 USD) para Jev, frente a unos 81,84 EUR (91,5 USD) en el caso de Claude Haiku 5.5 (low).
Cuándo conviene implementar un modelo de decisión
Resultan idóneos cuando las respuestas proceden de un conjunto finito y existe un volumen elevado de operaciones:
- Clasificación y enrutamiento de tickets de soporte, correos o documentación.
- Moderación de comentarios e identificación de instrucciones maliciosas.
- Selección de herramientas en agentes autónomos («ejecutar herramienta» frente a «pedir aclaración»).
- Filtros de control de calidad: aprobar, solicitar corrección o escalar a un humano.
No son adecuados si se precisa conocimiento enciclopédico detallado o redacción libre. En preguntas factuales abiertas, Claude Haiku 5.5 (low) alcanza un 52% de acierto y GPT-6 Luna (low) un 66%, mientras que los modelos de decisión oscilan entre el 28% y el 41%. Tampoco redactan la respuesta dirigida al cliente final, tarea que sigue correspondiendo a los LLM habituales.
Próximos pasos
Artificial Analysis actualiza esta clasificación de forma continua y mantiene abierta la recepción de nuevos modelos. Puedes consultar el análisis detallado de las pruebas, precios de API y nuestra comparativa experimental (probada con incidencias redactadas en polaco en su evaluación original) en el centro de recursos sobre modelos de decisión de IA. Anteriormente analizamos también Jev de TypeSafe, Cloudflare Clef y Strands Decider 2B de AWS.
Google · Tus fuentesBrilla más alto en tu Google - con un solo clicAñadir a fuentes preferidas →Fuentes
- Artificial Analysis: Artificial Analysis Decision Index v1.0 (13/10/2026)
- Artificial Analysis: Decision Index - clasificación en tiempo real (datos extraídos la tarde del 13/10/2026)
- Artificial Analysis: metodología del Decision Index
- Artificial Analysis en X (publicación del 13/10/2026)
More on this from FULGOR