Modelos de decisión de IA: Decision Index
Qué son los modelos de decisión de IA como Clef y Strands Decider: análisis de funcionamiento, requisitos, costes en euros y comparativa de rendimiento.
👁 130 lecturas
Un modelo de decisión es un sistema de IA que no redacta texto, sino que elige una respuesta de una lista cerrada que tú defines y te indica su nivel de certeza matemática. En lugar de generar una frase como «esta incidencia parece sobre cobros», recibes pagos: 0,97, de modo que tu código determina de forma limpia qué acción tomar. El 1 de octubre de 2026, Cloudflare lanzó sus modelos abiertos Clef y Clef-flash, y AWS presentó ese mismo día Strands Decider 2B. Los puse a prueba en local con una RTX 4090 evaluando 30 incidencias reales de clientes (redactadas originalmente en polaco).
Artificial Analysis Decision Index: el primer ranking independiente de modelos de decisión (13 de octubre de 2026)
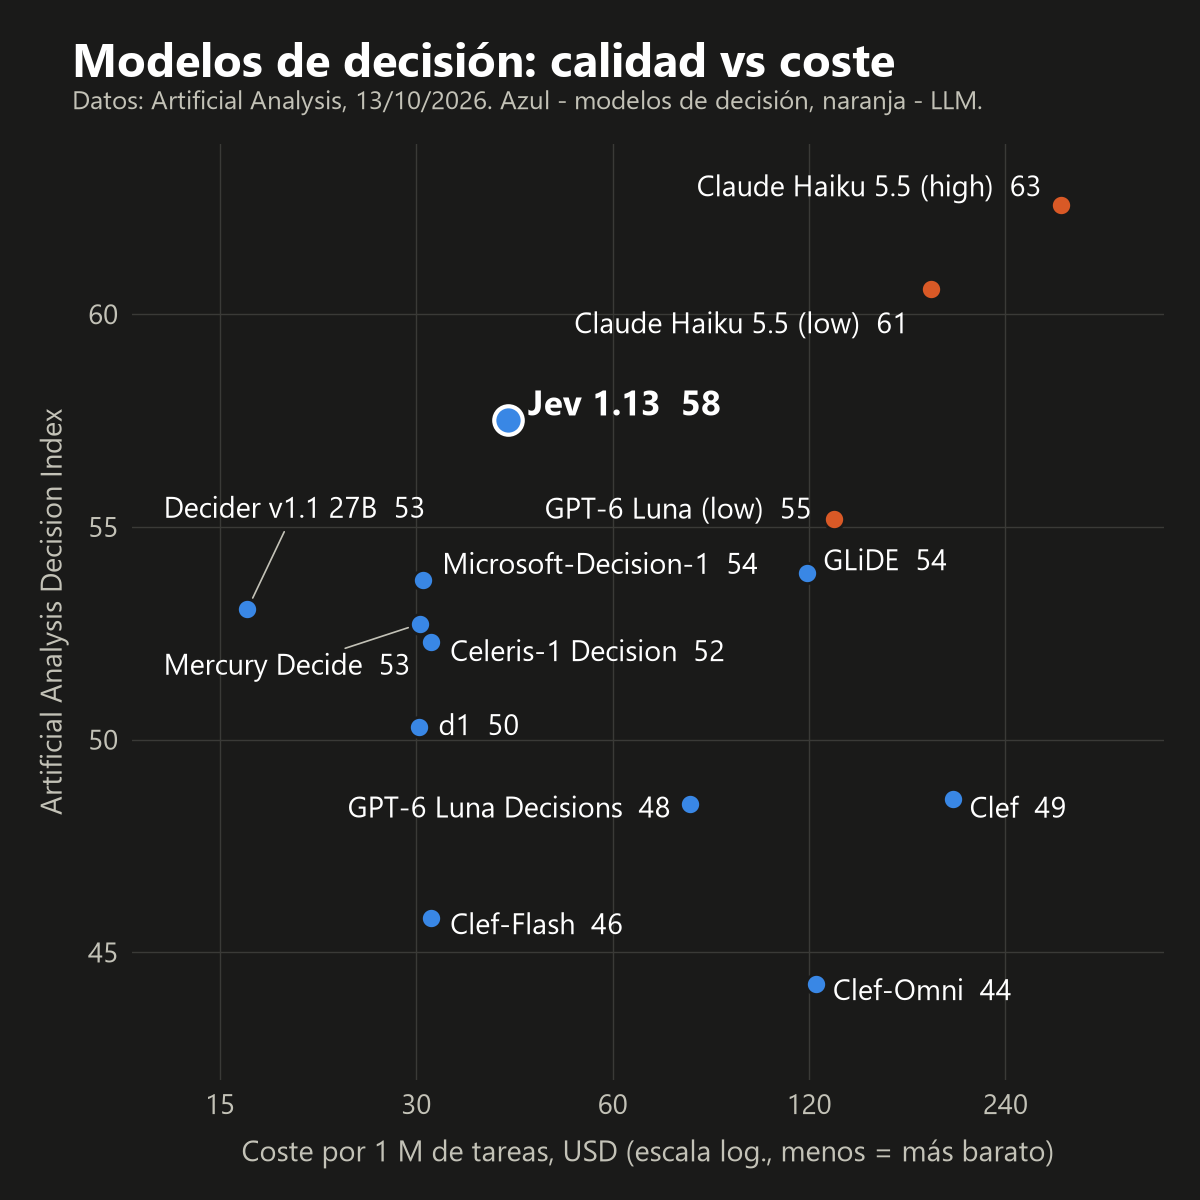
Un modelo de decisión no redacta texto. Recibe una pregunta estructurada - elegir una opción, sí o no, una puntuación - y devuelve una probabilidad para cada opción permitida en una sola llamada. El 13 de octubre de 2026, Artificial Analysis (AA) publicó el Decision Index v1.0, que compara 11 modelos de este tipo entre sí y con LLM convencionales respondiendo a las mismas tareas mediante salidas estructuradas. Todas las cifras siguientes proceden de la tabla de clasificación de AA a fecha de 13 de octubre de 2026; la tabla en vivo puede variar.
Ranking de los 11 modelos de decisión
| Model (company) | Index | Cost per 1M tasks | Median time |
|---|---|---|---|
| Jev 1.13 (TypeSafe) | 57,5 | $41,5 | 127 ms |
| GLiDE (Fastino Labs) | 53,9 | $119,0 | 217 ms |
| Microsoft-Decision-1 (Microsoft) | 53,8 | $30,7 | 207 ms |
| Decider v1.1 27B (Perplexity) | 53,1 | $16,5 | 170 ms |
| Mercury Decide (Inception) | 52,7 | $30,4 | 500 ms |
| Celeris-1 Decision (Celeris) | 52,3 | $31,6 | 63 ms |
| d1 (Liquid AI) | 50,3 | $30,3 | 299 ms |
| Clef (Cloudflare) | 48,6 | $199,4 | 309 ms |
| GPT-6 Luna Decisions (OpenAI) | 48,5 | $78,9 | 168 ms |
| Clef-Flash (Cloudflare) | 45,8 | $31,6 | 298 ms |
| Clef-Omni (Cloudflare) | 44,3 | $123,1 | 172 ms |
A modo de comparación, los LLM en las mismas tareas: Claude Haiku 5.5 (razonamiento bajo) 60,6 a $184 por millón de tareas y 1.434 ms, GPT-6 Luna (bajo) 55,2 a $131 y 1.500 ms, Claude Opus 5.5 (máx.) 79,0 a $51.295 y 3.571 ms.
Qué miden las cuatro pruebas
Cada prueba pondera un 25% en el índice:
- AA-Omniscience-Decision - 500 preguntas de conocimiento privado con 5 opciones (4 respuestas más «No lo sé»); mitad precisión, mitad tasa de no alucinación, es decir, con qué frecuencia un modelo que no sabe la respuesta elige «No lo sé».
- HLE-MultiChoice - 513 preguntas de opción múltiple solo de texto procedentes de Humanity’s Last Exam (razonamiento complejo).
- When2Call (NVIDIA) - responder directamente, invocar una herramienta, pedir más información o indicar que no puede ayudar.
- WildGuardTest (Ai2) - si la solicitud es perjudicial, si es una negativa, si la respuesta es perjudicial (F1 promedio).
Para los modelos de decisión, AA toma la opción con la probabilidad más alta (para sí/no: sí cuando p es 0,5 o superior). Los LLM reciben un prompt de sistema fijo y responden en JSON. Los modelos de decisión se facturan solo por la entrada; los LLM, por la entrada y la salida.
Puntos fuertes y débiles por prueba
- El conocimiento es el punto débil de todos los modelos de decisión: 28-41% de precisión frente al 52% de Claude Haiku 5.5 (bajo) y el 66% de GPT-6 Luna (bajo). Jev 1.13 obtiene un 34,6%, Microsoft-Decision-1 un 28,2%, el mejor es d1 con un 41,0% - pero d1 casi nunca responde «No lo sé» (1,7).
- Decir «No lo sé»: Microsoft-Decision-1 39,8, Jev 1.13 35,2, Mercury Decide 32,0; ningún otro modelo de decisión supera el 17, Celeris-1 marca 0.
- Razonamiento (HLE-MultiChoice): Jev 1.13 20,9, cualquier otro modelo de decisión 15,4 o menos.
- Invocación de herramientas (When2Call): GLiDE y Celeris-1 83,7 - por encima de Claude Haiku 5.5 bajo (72,6) y GPT-6 Luna bajo (77,0).
- Clasificación de seguridad (WildGuardTest): GLiDE 95,1, el mejor resultado de toda la tabla incluyendo los LLM; Decider 93,8, Jev 93,6, Claude Haiku 5.5 bajo 92,6. El más flojo: GPT-6 Luna Decisions 82,8.
- Según AA todos los modelos de decisión muestran un exceso de confianza, principalmente en conocimiento y razonamiento; la calibración en When2Call y WildGuardTest es relativamente buena.
Coste frente a calidad
- En la frontera de Pareto coste-calidad AA sitúa tres modelos: Decider v1.1 27B ($16,5 por millón de tareas), Microsoft-Decision-1 ($30,7) y Jev 1.13 ($41,5).
- Claude Haiku 5.5 (bajo) obtiene 3 puntos más que Jev 1.13, pero según AA es 11 veces más lento y 4,4 veces más caro.
- Solo clasificación (WildGuardTest, por millón de tareas): Decider $12,1, Microsoft-Decision-1 $12,5, Mercury Decide $12,6, Celeris-1 $16,0, Jev $22,8, GLiDE $84,3 - frente a $91,5 para Claude Haiku 5.5 (bajo) y $3.774 para Claude Opus 5.5 (bajo).
Precios (USD por millón de tokens de entrada, salida gratuita, verificados el 13 de octubre de 2026)
| Model | Producer | OpenRouter |
|---|---|---|
| Jev 1.13 | 0,042 | 0,042 |
| GLiDE | 0,15 (all internal passes billed) | - |
| Microsoft-Decision-1 | 0,042 (Microsoft Foundry) | 0,042 |
| Decider v1.1 27B | 0,02 | 0,02 |
| Mercury Decide | 0,04 (promo 0,02) | 0,02 |
| Celeris-1 Decision | 0,04 | - |
| d1 | 0,04 | 0,04 |
| Clef | 0,24 (Workers AI) | from 0,042 |
| Clef-Flash | 0,038 | from 0,021 |
| Clef-Omni | 0,15 | 0,15 |
| GPT-6 Luna Decisions | 0,10 (+10% for EU/EEA processing) | 0,10 |
Cuándo tiene sentido un modelo de decisión en lugar de un LLM
- La respuesta pertenece a un conjunto cerrado de opciones: enrutar incidencias a un departamento, etiquetas de sí/no, moderación, decidir si se invoca una herramienta. Eso es lo que miden tres de las cuatro pruebas de AA, y donde los modelos de decisión se acercan o superan a los LLM pequeños.
- El volumen y la latencia son determinantes: los modelos de decisión responden en aproximadamente 60-500 ms (mediana de AA) y cuestan decenas de dólares por millón de tareas; los LLM tardan 1,4-3,6 s en las mismas tareas y su coste parte de unos $130 por millón de tareas.
- Se necesita una probabilidad, no solo una etiqueta - por ejemplo, para remitir los casos de baja confianza a una persona o a un modelo más potente.
- Un LLM sigue siendo mejor opción para preguntas de conocimiento (los modelos de decisión alcanzan un 28-41% en la prueba de conocimiento de AA) y para cualquier tarea que requiera generación de texto.
Nuestra prueba con 50 incidencias de soporte en un idioma distinto al inglés
El 13 de octubre de 2026 ejecutamos 9 modelos de decisión a través de OpenRouter y dos LLM (Claude Haiku 5.5 y GPT-6 Luna, razonamiento bajo) sobre 50 incidencias de soporte de comercio electrónico redactadas en polaco (departamento entre 7 opciones más una etiqueta de urgencia) y 10 conversaciones al estilo de When2Call. La pauta de respuestas se definió antes de la prueba. Muestra pequeña: interprete los resultados a título orientativo.
- Departamento en 47 incidencias sin ambigüedad: modelos de decisión 41-44 aciertos, ambos LLM 45. Jev 1.13 obtuvo el resultado más bajo (41); Microsoft-Decision-1, Decider, Mercury Decide y Clef 44.
- Urgencia: Decider y GPT-6 Luna Decisions 48 de 50; Microsoft-Decision-1 42 de 50 (8 falsas alarmas con un umbral de 0,5).
- Decisión de herramientas: 7 modelos de decisión y ambos LLM 10 de 10, Mercury Decide 9, Clef-Flash y Clef-Omni 6.
- Latencia mediana medida desde Europa vía OpenRouter: modelos de decisión 310-619 ms, Claude Haiku 5.5 1.689 ms, GPT-6 Luna 1.371 ms.
- Coste medido por millón de tareas de este tipo: Mercury Decide $4,4 (precio promocional), Decider $7,8, Microsoft-Decision-1 $11,5, Jev 1.13 $26,8 (utilizó unos 640 tokens de entrada por tarea con este texto frente a unos 275 de Microsoft-Decision-1), Claude Haiku 5.5 $96,7.
- La confianza funciona como filtro: con una confianza de 0,9 o superior Jev acertó en 37 de 39 incidencias, Decider en 39 de 41. Una cascada - Microsoft-Decision-1 primero, Claude Haiku 5.5 solo por debajo de 0,8 de confianza - obtuvo 45 de 47, lo mismo que Haiku en solitario, a unos $18 en lugar de unos $101 por millón de clasificaciones.
Cómo acceder a ellos
OpenRouter ofrece 9 de los 11 modelos evaluados a través de un endpoint independiente, POST https://openrouter.ai/api/alpha/decisions (campos state y questions) - los modelos de decisión no funcionan a través de /chat/completions. GLiDE y Celeris-1 Decision están disponibles únicamente mediante las API de sus proveedores. Decider v1.1 27B (Apache-2.0, unos 49 GiB de memoria de GPU), d1-3B (LFM Open License, gratuito por debajo de 10 millones de USD de ingresos anuales) y los modelos Cloudflare Clef (Apache-2.0) disponen de pesos abiertos.
Artículos sobre modelos de decisión
- Decision Index de Artificial Analysis: ranking de modelos
- Modelos de decisión frente a LLM: diferencias técnicas
- Precios de modelos de decisión: costes de tokens y tareas
- Qué modelo de decisión elegir según el caso de uso
Fuentes
- Artificial Analysis - Decision Index announcement
- Artificial Analysis - Decision Index leaderboard
- Artificial Analysis - Decision Index methodology
- OpenRouter - Decisions API
- TypeSafe - Jev models
- Fastino - GLiDE
- Microsoft - Microsoft-Decision-1 in Foundry
- Perplexity - Decisions API
- Inception - Mercury Decide
- Celeris - Celeris-1 Decision
- Liquid AI - d1
- Cloudflare - Clef
- OpenAI - Decisions guide
Situación a 7 de octubre de 2026
- Cloudflare Clef (27B, basado en Qwen3.8-27B) y Clef-flash (9B, sobre Qwen3.5-9B): licencia Apache-2.0, pesos disponibles en Hugging Face y alojamiento en Workers AI por unos 0,21 € (0,24 USD) y 0,08 € (0,09 USD) por millón de tokens de entrada (conversión orientativa según el tipo de referencia del BCE a 12/10/2026: 1 EUR = 1,1181 USD; fuente: BCE).
- Strands Decider 2B de AWS: Apache-2.0, pesos, datos de entrenamiento y scripts totalmente públicos; funciona incluso en CPU.
- Kev 1.0 (Jared Palmer): familia de modelos abiertos de 0,8B a 27B, optimizados solo para inglés.
- Aplomb 1 de EmpirioLabs (lanzado el 29 de septiembre): 5,3B, admite texto, JSON, imagen, vídeo y audio con ventana de 1 millón de tokens, pesos bajo licencia propietaria y API a unos 0,018 € (0,02 USD) por millón de tokens de entrada. Más detalles en el artículo sobre Aplomb 1.
- Todos ellos utilizan la misma especificación de API popularizada por Jev de TypeSafe (System One), que inauguró esta categoría el 15 de septiembre.
- En mi comparativa: Clef-flash y Strands Decider acertaron el departamento en 30 de 30 consultas redactadas en polaco, con una mediana de 112 y 135 ms por decisión.
Qué es un modelo de decisión
Un modelo de lenguaje convencional (LLM) genera texto palabra por palabra. Aunque le exijas responder con una sola palabra o en JSON, sigue escribiendo secuencialmente, solo que acorta la salida. Un modelo de decisión opera bajo una lógica completamente diferente:
- Recibe un estado: el texto de la incidencia, un JSON con parámetros del pedido o, en el caso de Clef, también imágenes.
- Recibe preguntas vinculadas a listas cerradas de opciones: por ejemplo, «¿qué departamento?» entre
pagos,envios,devoluciones… - Procesa el estado en una sola pasada y calcula de golpe la probabilidad de cada opción permitida. No hay generación autorregresiva de texto, no requiere parsers y es matemáticamente imposible que devuelva un valor ajeno a la lista.
Los modelos de este ecosistema se apoyan en tres tipos de consultas estandarizadas por Jev de TypeSafe:
| Tipo | Qué preguntas | Qué recibes |
|---|---|---|
choice |
Selecciona una opción de una lista | Opción elegida, certeza y distribución de probabilidades |
noul |
¿Sí o no? | Probabilidad de «sí» acotada entre 0 y 1 |
score |
Evalúa en una escala (p. ej. sin impacto, leve, grave, crítico) | Nivel esperado, certeza y distribución |
La diferencia práctica crucial reside en que el valor obtenido es una probabilidad calculada por la red, no una afirmación redactada como «estoy seguro al 90%» que un LLM puede alucinar con ligereza. Gracias a ello, puedes definir umbrales automáticos limpios: si supera 0,8 se ejecuta el flujo directo; si queda por debajo, se desvía a revisión humana.
Cuándo conviene utilizarlos y cuándo no
Casos de uso ideales:
- Enrutamiento de tickets de soporte: asignación de departamento, urgencia del caso, detección de idioma o riesgo de baja de clientes.
- Moderación de contenidos: verificación de infracciones, detección de spam o idoneidad de imágenes (Clef procesa entradas visuales).
- Clasificación documental: tipología de facturas, categorización de gastos o detección de cláusulas específicas en contratos.
- Selección de herramientas en agentes: en lugar de exigir a un gran modelo que razone qué función invocar, consultas la elección a un modelo de decisión (más detalles sobre esta arquitectura en la guía de function calling).
- Control de flujo (gates) en arquitecturas de agentes: comprobación de si la respuesta de un agente cumple los criterios de calidad, decisión de escalado a personas o elección del modelo downstream idóneo.
Casos para los que no sirven:
- Redacción, resúmenes, traducción, chat interactivo o código: un modelo de decisión no produce frases.
- Preguntas abiertas («¿qué insinúa el usuario?»): si no proporcionas un abanico explícito de opciones, no puede operar.
- Razonamiento complejo en múltiples etapas: los propios creadores de Strands Decider indican abiertamente que su rendimiento decae ante problemas analíticos complejos en comparación con modelos de razonamiento dedicados.
En entornos de producción, el modelo de decisión trabaja junto al LLM: toma cientos de pequeñas determinaciones a velocidad extrema y delega en el LLM únicamente la generación textual final. Explico en detalle la integración de estos componentes en la guía sobre agentes de IA desde cero.
Catálogo de modelos de decisión en octubre de 2026
| Modelo | Autor | Tamaño y base | Licencia | Disponibilidad |
|---|---|---|---|---|
| Jev | TypeSafe | No especificado | Pesos cerrados | API de TypeSafe (System One) |
| Clef | Cloudflare | 27B, Qwen3.8-27B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (55 GB) |
| Clef-flash | Cloudflare | 9B, Qwen3.5-9B + joint schema head | Apache-2.0 | Workers AI, Hugging Face (19 GB) |
| Strands Decider 2B | AWS (Strands Labs) | 2B, Qwen3.5-2B-Base + LoRA + pointer head | Apache-2.0 | Hugging Face, GitHub, pip install strands-decider |
| Kev 1.0 | Jared Palmer | 0,8B, 4B, 9B, 27B (Qwen3.5/Qwen3.8) | Apache-2.0 | Hugging Face, GitHub |
| Aplomb 1 | EmpirioLabs | 5,3B, Qwen3.5-4B | EmpirioLabs Model License 1.0 (gratuita para uso interno si los ingresos son inferiores a 1 millón de USD) | Hugging Face (requiere aprobación), API de EmpirioLabs |
| Decisions API | OpenAI | Modelo Luna | Cerrado | Vista previa limitada, sin tarifas públicas |
Clef, Clef-flash, Strands Decider y Kev implementan la API de System One, adoptando el esquema de peticiones de Jev (POST /v1/systemone con los campos state y questions). El mismo cliente HTTP sirve para cualquiera de ellos simplemente cambiando el endpoint y el identificador del modelo. Aplomb 1 cuenta con su propio endpoint POST /v1/decisions y compatibilidad con formatos de chat de OpenAI, Anthropic y Gemini. Analicé el enfoque de OpenAI en el artículo sobre Agents API.
Cloudflare Clef y Clef-flash
Clef toma un modelo base Qwen congelado, procesa la entrada en una única pasada (fase de prefill, sin bucle de decodificación) y traslada los estados ocultos a un módulo denominado joint schema head. Este cabezal calcula simultáneamente todas las opciones de todas las preguntas formuladas, permitiendo que las decisiones se correlacionen entre sí. Cloudflare destaca que es el primer modelo del segmento dotado de codificador visual y ventana de 64.000 tokens. Los detalles técnicos del lanzamiento están recogidos en Cloudflare Clef: modelo abierto de decisión, y la plataforma global en el artículo sobre Cloudflare.
Amazon Strands Decider 2B
Es la alternativa más ligera entre las opciones de código abierto. AWS conservó el tronco troncal de Qwen3.5-2B-Base, descartó la capa de lenguaje tradicional y añadió un cabezal de punteros de algo más de un millón de parámetros, complementado con un adaptador LoRA de rango 16. En Hugging Face está disponible el punto de control strands-decider-2B-hobson-v19 junto a los scripts y datos de entrenamiento. Según los autores, la latencia mediana ronda los 115 ms en una RTX 3090 y 153 ms en un MacBook con M3, logrando 167 de 231 tareas (72,3%) en el benchmark público JevBench.
Kev 1.0
Diseñado por Jared Palmer (creador de proyectos como Formik o Turborepo), Kev ofrece cuatro variantes entre 0,8B y 27B con LoRA y cabezal de puntero sobre Qwen3.5/Qwen3.8 bajo licencia Apache-2.0. Al respetar el estándar System One, el SDK de TypeSafe se conecta a una instancia local de Kev sin alterar el código. Su entrenamiento y validación se han realizado estrictamente en inglés; la versión 9B requiere unos 22 GB de memoria gráfica según su ficha técnica. Omití Kev en mis mediciones prácticas por las razones expuestas más adelante.
EmpirioLabs Aplomb 1
Aplomb 1 (presentado el 29 de septiembre de 2026 y actualizado los días 5 y 6 de octubre) destaca por su capacidad multimodal nativa: ingiere texto, JSON, hasta 16 imágenes, 8 clips de audio y 4 fragmentos de vídeo por petición con un millón de tokens de contexto. Con 5.300 millones de parámetros sobre Qwen3.5-4B, precisa en torno a 12 GB de VRAM en precisión bf16. Incorpora además el tipo de consulta tool, que resuelve la selección de función y la distribución de argumentos en un paso unificado.
- Métricas declaradas por el desarrollador: 44,86 puntos en Decision Index 0.2.1 (evaluación ejecutada por EmpirioLabs el 5/10), y en visión: POPE 89,0, MMStar 68,6 y AI2D 87,0.
- Capacidades de audio: único modelo del grupo que procesa pistas de sonido de forma nativa (91,9% en clasificación de eventos vocales).
- Términos de licencia: no se rige por Apache-2.0. Su uso es gratuito con fines académicos, personales o internos en empresas con facturación anual inferior a 1 millón de USD; plataformas SaaS o compañías de mayor escala precisan licencia comercial.
- Coste de API: unos 0,018 € (0,02 USD) por millón de tokens de entrada; los tokens de salida no conllevan recargo (conversión de referencia BCE: 1 EUR = 1,1181 USD).
Aplomb 1 no formó parte de mi banco de pruebas porque la descarga de pesos exigía aprobación de licencia y el API requería registro previo. Desglosé sus especificaciones completas en el análisis sobre Aplomb 1 de EmpirioLabs.
Precios estimados y requisitos de hardware
| Modelo | Infraestructura | Precio aproximado | Ejecución local |
|---|---|---|---|
| Clef | Workers AI @cf/cloudflare/clef |
~0,21 € (0,24 USD) / millón de tokens de entrada | 55 GB en bf16; en 24 GB de VRAM requiere cuantización (no hay versión oficial) |
| Clef-flash | Workers AI @cf/cloudflare/clef-flash |
~0,08 € (0,09 USD) / millón de tokens de entrada | 19 GB de pesos; 18,3 GB de VRAM consumidos en mis pruebas |
| Strands Decider 2B | Autohospedado | 0 € / 0 USD (coste energético y máquina) | Descarga de 4,4 GB; 3,8 GB de VRAM en uso; apto para CPU y Apple Silicon |
| Kev-9B | Autohospedado | 0 € / 0 USD | Aproximadamente 22 GB de VRAM según el autor |
| Aplomb 1 | API EmpirioLabs | ~0,018 € (0,02 USD) / millón de tokens de entrada (salida sin coste) | Unos 12 GB en bf16 según especificaciones del creador |
| Jev | API TypeSafe | ~0,038 € (0,042 USD) / millón de tokens de entrada (salida sin coste) | No ejecutable en local |
Workers AI concede una cuota sin coste de 10.000 «neuronas» diarias tanto en su plan Free como Paid. Clef computa 21.818 neuronas por millón de tokens de entrada y Clef-flash 8.182. Esto equivale a unos 458.000 tokens diarios gratuitos en Clef y en torno a 1,2 millones en Clef-flash. Una consulta estándar con dos preguntas suele rondar entre 150 y 250 tokens, lo que permite resolver miles de decisiones al día sin coste de servicio. Conviene recordar que las conversiones a euros se calculan según el tipo de referencia del Banco Central Europeo de 1 EUR = 1,1181 USD a 12/10/2026 (BCE) y constituyen importes estimativos netos.
Prueba práctica: 30 incidencias de soporte en una RTX 4090
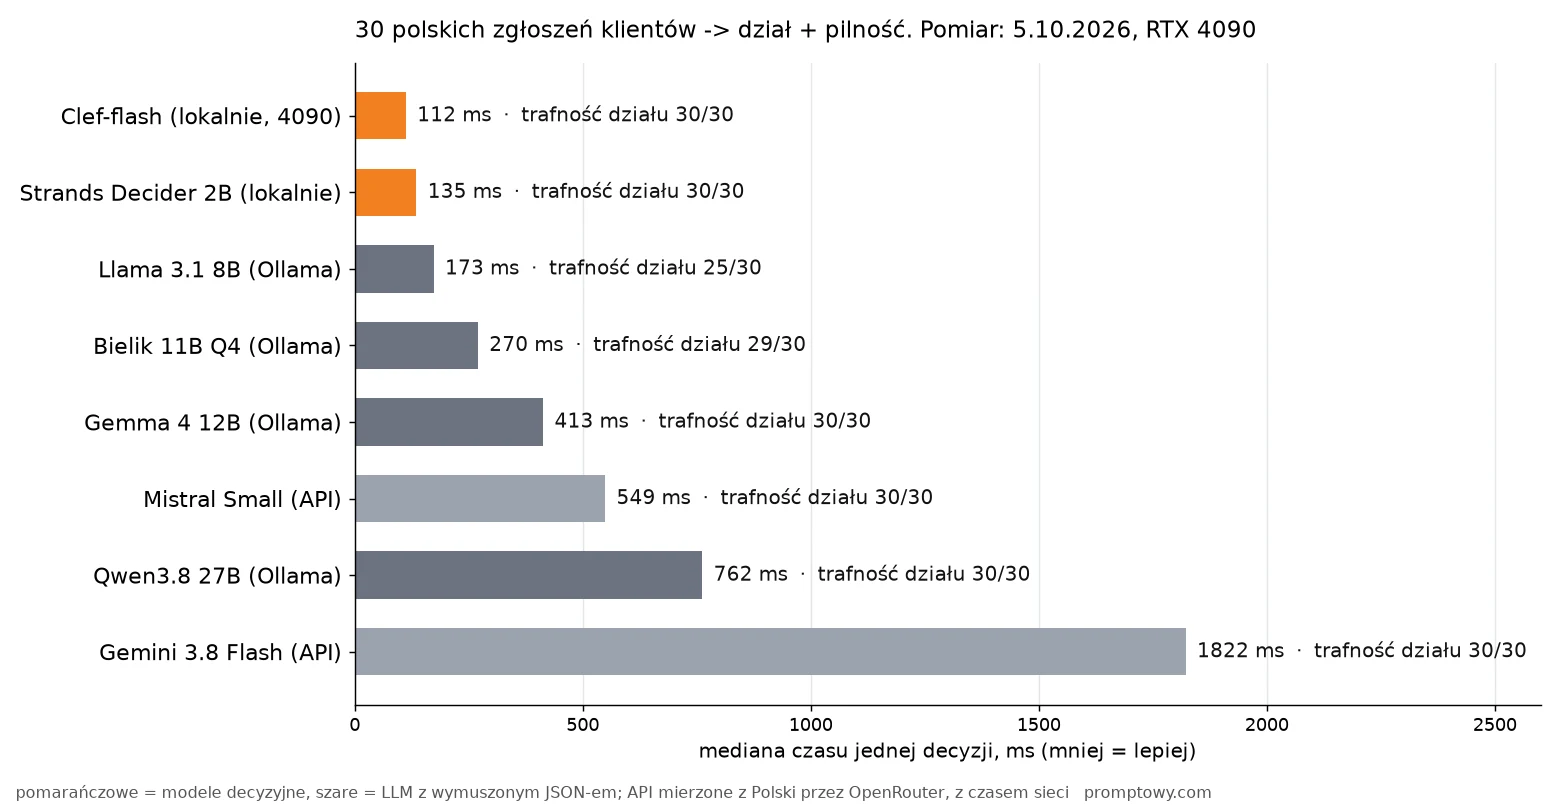
Para comprobar la respuesta real, preparé 30 casos típicos de atención al cliente de comercio electrónico y software SaaS clasificados en seis áreas: pagos, envíos, devoluciones, gestión de cuenta, incidencias técnicas y ventas (5 casos por área). Con el fin de evaluar la robustez multilingüe, las entradas originales se redactaron íntegramente en polaco, incluyendo deliberadamente omisión de diacríticos locales, erratas tipográficas y solicitudes ambiguas (por ejemplo: «sigo sin recibir el reembolso de mi dinero», donde confluyen devoluciones y cobros). Todos los modelos evaluaron la asignación de departamento (entre 6 opciones) y si la urgencia exigía resolver el caso en el día. Los modelos de decisión se invocaron vía API nativa, mientras que los LLM se ejecutaron a través de Ollama u OpenRouter fijando esquema JSON estricto y temperatura 0.
| Modelo | Departamento (test en polaco) | Urgencia (test en polaco) | Mediana de tiempo | Memoria / Peso |
|---|---|---|---|---|
| Clef-flash (local) | 30/30 | 26/30 (28/30 con umbral 0,95) | 112 ms | 18,3 GB VRAM |
| Strands Decider 2B (local) | 30/30 | 24/30 (26/30 con umbral 0,4) | 135 ms | 3,8 GB VRAM |
| Llama 3.1 8B (Ollama) | 25/30 | 23/30 | 173 ms | Archivo de 4,9 GB |
| Bielik 11B Q4 (Ollama) | 29/30 | 21/30 | 270 ms | Archivo de 6,7 GB |
| Gemma 4 12B (Ollama) | 30/30 | 26/30 | 413 ms | Archivo de 7,0 GB |
| Qwen3.8 27B (Ollama) | 30/30 | 27/30 | 762 ms | Archivo de 16 GB |
| Mistral Small 2603 (API) | 30/30 | 19/30 | 549 ms | - |
| Gemini 3.8 Flash (API) | 30/30 | 26/30 | 1822 ms | - |
Conclusiones destacadas del experimento:
- La clasificación temática básica no discrimina suficiente. 6 de los 8 modelos lograron un pleno de 30/30. En una muestra de 30 casos, un único fallo es atribuible a varianza estadística. Solo Llama 3.1 8B mostró debilidad evidente (25/30), confundiendo peticiones de factura con ventas y una avería en un aparato con una caída de servicio.
- La ventaja en velocidad es aplastante. En el mismo hardware gráfico, Clef-flash respondió 3,7 veces más rápido que Gemma 4 12B y casi 7 veces más veloz que Qwen3.8 27B (cuya arquitectura base es casi idéntica a la de Clef grande). Esta marca se logró sin recurrir a kernels hiperoptimizados como flash-linear-attention o causal-conv1d, ejecutando la capa de atención lineal sobre las rutinas estándar de la librería transformers.
- El umbral de corte debe calibrarse con datos propios. Strands Decider mostró una tendencia a comprimir a la baja las probabilidades de urgencia en textos no ingleses: ningún caso superó el valor 0,5, por lo que con el umbral estándar no marcó ninguno como urgente. Sin embargo, la ordenación relativa era coherente: situando el corte en 0,4, el acierto subió a 26/30. Clef-flash mostró el patrón inverso: con 0,5 produjo 4 falsos positivos, mientras que elevando el umbral a 0,95 los errores cayeron a 2.
- Rendimiento multilingüe consistente pese al entrenamiento anglocéntrico. Al contrastar las mismas consultas traducidas al inglés, las métricas no mejoraron sustancialmente: Clef-flash obtuvo 29/30 y Strands 29/30 (ambos dudaron ante cambios de tarifa a mitad de ciclo).
- La urgencia encierra un componente subjetivo. Establecí manualmente como urgentes 6 incidencias críticas (errores HTTP 502, sospechas de acceso no autorizado, cargos duplicados…). Prácticamente todos los modelos consideraron urgente un pago bancario instantáneo no reflejado en el panel de control del usuario, una interpretación totalmente razonable desde la óptica de soporte.
El coste computacional directo de la prueba fue nulo en local y de apenas unos 0,036 € (0,04 USD) a través de OpenRouter para cursar 180 llamadas combinadas a Mistral y Gemini. Gemini 3.8 Flash no permite suprimir por completo el razonamiento interno, por lo que operó en su nivel mínimo registrando latencias de 1,8 segundos.
Por qué no incluí Clef de 27B ni Kev en el test local
- Clef 27B ocupa 55 GB en precisión bf16, lo que sobrepasa los 24 GB de memoria de una GPU de consumo doméstico salvo que se cuantice, proceso para el que Cloudflare no ha publicado pesos oficiales. Al incorporar una arquitectura personalizada (
joint_schema_model.py), no es compatible de forma directa con Ollama ni llama.cpp mediante ficheros GGUF sin desarrollos a medida. - Kev-9B exige descargar por separado el modelo base Qwen3.5-9B-Base (añadiendo otros 19 GB de descarga), y establecí un techo operativo de 40 GB para esta tanda. Además, el proyecto está enfocado y documentado de forma exclusiva para el idioma inglés.
- Cloudflare Workers AI requiere vincular una cuenta activa con la plataforma, paso que omití para centrarme en validaciones locales independientes.
Modelo de decisión frente a LLM con salida estructurada
Esta misma operativa puede resolverse recurriendo a un LLM convencional forzando la respuesta mediante esquemas JSON tipados (un enfoque desglosado en el artículo sobre salida estructurada en JSON). Estas son sus diferencias:
| Parámetro | Modelo de decisión | LLM con structured output |
|---|---|---|
| Respuestas no permitidas | Imposible por diseño matemático | Se previene con esquemas rígidos, pero el serializador puede quebrar (véase el análisis cuando un modelo devuelve JSON inválido) |
| Calibración de certeza | Distribución probabilística para cada opción | Inexistente o basada en cifras autogeneradas sin respaldo probabilístico estricto |
| Múltiples consultas simultáneas | Sin penalización apreciable de latencia | Cada parámetro incrementa la longitud de generación y el tiempo |
| Justificación explicativa | No genera explicaciones | Capaz de argumentar los motivos de su elección |
| Razonamiento complejo | Capacidad reducida | Muy superior, en especial en modelos orientados a razonamiento |
| Coste en plataformas cloud | Tarificación exclusiva por tokens de entrada | Cómputo por entrada, salida y tokens intermedios de razonamiento |
Mi criterio de implementación: si el problema se acota a respuestas de lista cerrada y manejas un volumen elevado (centenares o miles de operaciones al día), la opción idónea es un modelo de decisión. Si requieres texto explicativo o la tarea exige encadenar deducciones lógicas complejas, opta por un LLM. La combinación más eficiente delega en el modelo de decisión los casos con certidumbre alta y deriva a un LLM o a un operador humano aquellos que caen por debajo del umbral de confianza.
Puesta en marcha básica en 10 minutos
- Asegúrate de contar con Python 3.10+ y PyTorch configurado con soporte CUDA (funciona también en CPU, aunque con mayor latencia).
- Ejecuta
pip install strands-deciderpara instalar el paquete oficial (descarga de unos 4,4 GB). - Realiza una primera inferencia desde la consola (el siguiente ejemplo es una traducción al español del comando evaluado originalmente con texto en polaco):
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v19 --state "Me habéis cobrado dos veces la misma suscripción este mes" --choice "¿Qué departamento?=pagos,envios,devoluciones,cuenta,averia,ventas" --noul "¿El asunto es urgente?" - Para integrarlo en tus aplicaciones, levanta el servidor local (
strands-decider serve ... --port 8000) y envía peticiones bajo el esquema System One. El servicio queda escuchando en 127.0.0.1 sin autenticación integrada, por lo que en producción debes protegerlo tras tu propia pasarela. - Si dispones de una tarjeta gráfica de 24 GB de VRAM, puedes dar el salto a Clef-flash descargando el repositorio con
snapshot_download("Cloudflare/clef-flash")y empleando la funciónsystemone()incluida en su implementación, manteniendo idéntico el formato de tus consultas.
En caso de no disponer de hardware gráfico local suficiente, las alternativas directas son Workers AI o el API de TypeSafe. A través de Ollama es posible ejecutar LLM tradicionales en local, pero los modelos de decisión emplean cabezales de red específicos que demandan su propio entorno Python con transformers.
Para quién es adecuada esta arquitectura
- Casos recomendados: plataformas de comercio electrónico y servicios de soporte que buscan automatizar la asignación de tickets; desarrolladores de flujos con agentes que requieren resolver multitud de bifurcaciones lógicas rápidas; sistemas de moderación visual y textual; o cualquier infraestructura que actualmente gaste recursos de un gran LLM solo para obtener un «sí» o un «no».
- Casos desaconsejados: proyectos que necesitan redactar prosa, dialogar o generar código; servicios con apenas un puñado de consultas al día (donde la comodidad de un LLM multipropósito compensa su sobrecoste); o equipos que no disponen de unos cuantos casos de prueba etiquetados para calibrar sus umbrales de decisión.
Preguntas frecuentes
¿Qué es exactamente un modelo de decisión en IA?
Es una arquitectura que renuncia a la generación secuencial de texto para especializarse en seleccionar respuestas dentro de un conjunto cerrado, proporcionando la probabilidad exacta calculada para cada alternativa. Suele articularse en tres modalidades de consulta: selección múltiple (choice), confirmación binaria sí/no (noul) y valoración numérica ordinal (score).
¿Qué caracteriza a Cloudflare Clef?
Es la serie de modelos abiertos de decisión presentada por Cloudflare el 1 de octubre de 2026, compuesta por Clef (27B, cimentado en Qwen3.8-27B) y Clef-flash (9B, sobre Qwen3.5-9B). Publicados bajo licencia Apache-2.0 con pesos en Hugging Face y ejecución en Workers AI, admiten texto, JSON, imagen y vídeo con un contexto de hasta 64.000 tokens.
¿Es posible utilizar Clef sin coste?
Los pesos son de libre descarga (Apache-2.0, válidos para uso comercial). En la nube de Workers AI, su coste aproximado es de 0,21 € (0,24 USD) para Clef y 0,08 € (0,09 USD) para Clef-flash por millón de tokens de entrada (tasas estimadas según cambio oficial del BCE a 12/10/2026 de 1 EUR = 1,1181 USD). La plataforma ofrece además una asignación sin coste diario de 10.000 neuronas, lo que cubre cerca de 458.000 tokens en Clef o 1,2 millones en Clef-flash cada día.
¿Responden con precisión en idiomas distintos al inglés?
En nuestras pruebas empíricas con textos en polaco, tanto Clef-flash como Strands Decider 2B resolvieron con acierto el departamento en 30 de 30 ocasiones. Donde sí se aprecian desviaciones es en la calibración probabilística, lo que obliga a ajustar los umbrales numéricos de corte sobre datos reales de tu propio dominio antes de automatizar acciones. Kev, en cambio, solo está preparado para inglés.
¿Qué máquina se necesita para ejecutar Clef en local?
Clef-flash demandó 18,3 GB de memoria de vídeo en mis pruebas, por lo que puede desplegarse en tarjetas como la RTX 3090, 4090 o 5090. El modelo Clef completo (55 GB en bf16) requiere hardware profesional tipo H100 o técnicas de cuantización no oficiales. Por su parte, Strands Decider 2B opera por debajo de los 4 GB de VRAM y se ejecuta con soltura en CPU o equipos Mac. Puedes profundizar en estos requerimientos en la guía sobre cuánta VRAM hace falta para ejecutar IA en local.
¿En qué se distingue un modelo de decisión del function calling?
El function calling tradicional es el proceso mediante el cual un LLM infiere la necesidad de ejecutar una función y redacta sus argumentos. Un modelo de decisión puede asumir de forma más rápida y barata la fase de selección de la herramienta adecuada, pero no redactará los argumentos de texto libre. En arquitecturas de agentes complejas suelen combinarse: el modelo de decisión elige y el LLM parametriza los detalles.
¿Qué propone Aplomb 1 de EmpirioLabs?
Es un modelo de decisión presentado el 29 de septiembre de 2026 con 5.300 millones de parámetros, ventana de contexto de un millón de tokens y soporte omnicanal (texto, JSON, imagen, vídeo y clips de voz). Sus pesos se encuentran en Hugging Face bajo una licencia propietaria de uso interno gratuito para empresas de facturación contenida, y su API oficial se ofrece a unos 0,018 € (0,02 USD) por millón de tokens de entrada.
¿Se puede integrar Strands Decider en proyectos comerciales?
Sí, la arquitectura, el código y sus datos de entrenamiento cuentan con licencia permisiva Apache-2.0, compartida por su base Qwen3.5-2B-Base. Ten en cuenta que el script de servidor integrado no incluye autenticación, por lo que debes aislarlo tras un proxy inverso o pasarela de seguridad antes de exponerlo.
¿Qué papel juegan Jev y el protocolo System One?
Jev es el modelo pionero lanzado por TypeSafe el 15 de septiembre de 2026 a través de API, definiendo la estructura técnica System One (envío estructurado de estado y preguntas tipificadas). Propuestas como Clef, Kev y Strands Decider han adoptado este esquema para garantizar total interoperabilidad de clientes de software. Tienes más detalles en el artículo sobre TypeSafe y el modelo Jev.
Google · Tus fuentesBrilla más alto en tu Google - con un solo clicAñadir a fuentes preferidas →Fuentes de referencia
- Cloudflare: Introducing Clef (1 de octubre de 2026)
- Cloudflare/clef y Cloudflare/clef-flash en Hugging Face
- Tarifas oficiales de Cloudflare Workers AI
- Strands Agents: Introducing Strands Decider 2B (1 de octubre de 2026) y su ficha técnica de modelo
- Repositorio de Kev en GitHub y jaredpalmer/kev-9b
- empiriolabsai/aplomb-1 y la documentación de Aplomb 1 (consultada el 7 de octubre de 2026)
- Banco de pruebas propio: 5 de octubre de 2026, RTX 4090, Windows 11, PyTorch 2.11, transformers 5.18, Ollama.
Pruebas de rendimiento realizadas el 5 de octubre de 2026; revisión de datos sobre Aplomb 1 actualizada el 7 de octubre de 2026.
More on this from FULGOR