Qwen-Image-2.1: ranking completo de 29 modelos de imagen con datos
El fabricante publicó una comparativa en forma de gráfico. Hemos extraído los números y los hemos cruzado con el tamaño de los modelos.
👁 117 lecturas
El fabricante de Qwen-Image-2.1 publicó en su lanzamiento un gráfico comparando 29 modelos de imagen, tanto abiertos como cerrados. Nadie lo presentó en forma de tabla, así que extrajimos las cifras del gráfico y las cruzamos con el tamaño de los modelos. El resultado es más interesante que la simple posición en el ranking.
Veredicto en un párrafo
Qwen-Image-2.1 ocupa el séptimo lugar con una puntuación de 60,28 puntos en el ranking Qwen-Image-Bench. Por delante solo tiene modelos cerrados cuyos fabricantes no revelan el tamaño. Lo más interesante es lo que ocurre por detrás: supera a Nano Banana 2.0, GPT Image 1.5, Seedream 5 Pro y Nano Banana Pro, además de FLUX 2 Max, que es cuatro veces más grande, y Hunyuan Image 3.0, once veces mayor. Es un modelo de 7 mil millones de parámetros que supera a uno de ochenta por más de nueve puntos.
Ranking completo Qwen-Image-Bench
Cifras extraídas del gráfico publicado por el fabricante. La columna de tamaño está vacía donde el fabricante del modelo no lo revela; en el gráfico se indicaba con un candado.
| # | Modelo | Puntuación | Tamaño |
|---|---|---|---|
| 1 | GPT Image 2.5 Sunburst | 67,01 | no revelado |
| 2 | GPT Image 2 | 64,69 | no revelado |
| 3 | Grok Imagine 2.0 | 63,47 | no revelado |
| 4 | Qwen Image 3 Pro | 62,36 | no revelado |
| 5 | Muse Image | 62,34 | no revelado |
| 6 | MAI Image 2.5 Pro | 61,02 | no revelado |
| 7 | Qwen-Image-2.1 | 60,28 | 7B |
| 8 | Nano Banana 2.0 | 59,82 | no revelado |
| 9 | GPT Image 1.5 | 59,65 | no revelado |
| 10 | Seedream 5 Pro | 59,53 | no revelado |
| 11 | Nano Banana Pro | 59,45 | no revelado |
| 12 | Grok Imagine Quality | 58,47 | no revelado |
| 13 | Qwen Image 2.0 Pro | 57,84 | no revelado |
| 14 | Seedream 5.0 | 57,22 | no revelado |
| 15 | Seedream 4.5 | 56,78 | no revelado |
| 16 | Seedream 4.0 | 56,21 | no revelado |
| 17 | FLUX 2 Max | 55,33 | 32B |
| 18 | FLUX 2 Pro | 54,57 | 32B |
| 19 | GPT Image 1 | 54,07 | no revelado |
| 20 | Qwen Image 2512 | 52,06 | 20B |
| 21 | Imagen 4.0 Ultra | 51,99 | no revelado |
| 22 | Boogu | 51,40 | 10B |
| 23 | Hunyuan Image 3.0 | 50,81 | 80B |
| 24 | Imagen 4.0 | 50,29 | no revelado |
| 25 | Qwen Image | 49,23 | 20B |
| 26 | Kling Image 2.1 | 48,26 | no revelado |
| 27 | GLM Image | 48,19 | 16B |
| 28 | LongCat | 46,34 | 6B |
| 29 | HiDream O1 | 46,17 | aprox. 8B |
Advertencia que hay que dejar clara: este es un benchmark publicado por el fabricante de uno de los modelos evaluados. Trátalo como material del fabricante, porque lo es. Eso no significa que las cifras sean inventadas, significa que el conjunto de tareas y el sistema de puntuación lo eligió la parte interesada en el resultado.
Tres cosas que solo se ven al cruzar con el tamaño
1. Salto dentro de la propia familia
| Versión | Tamaño | Puntuación |
|---|---|---|
| Qwen Image | 20B | 49,23 |
| Qwen Image 2512 | 20B | 52,06 |
| Qwen-Image-2.1 | 7B | 60,28 |
Un modelo casi tres veces más pequeño obtiene 8,22 puntos más que su predecesor directo. No es una simple actualización, sino una arquitectura diferente: capas de flujo único, atención de granularidad mixta y reutilización de caché.
2. El tamaño dejó de ser el pase a la élite
Hunyuan Image 3.0 tiene 80 mil millones de parámetros y una puntuación de 50,81. Qwen-Image-2.1 tiene 7 mil millones y 60,28. La diferencia es once veces el tamaño a favor del perdedor.
Consecuencia práctica para quien cuenta hardware: el modelo que da mejor resultado cabe en una tarjeta de consumo, mientras que el más grande requiere un centro de datos. Esto es una opinión: para la mayoría de aplicaciones, esto cierra la discusión sobre cuál elegir.
3. Los modelos cerrados siguen liderando, pero la ventaja se redujo
Al líder le faltan 6,73 puntos, al tercer puesto 3,19. Un modelo abierto que puedes ejecutar en casa está hoy a cinco puntos de la élite, no a veinte. Por detrás quedaron, sin embargo, modelos por los que pagas por cada imagen.
Qué recibió el modelo en esta versión
El fabricante enumera cuatro cambios:
- Arquitectura compacta - 32 capas DiT, atención de granularidad mixta, reutilización de caché de claves y valores con múltiples imágenes de entrada.
- Transparencia nativa - posibilidad de especificar en el prompt que la imagen debe tener canal alfa, y recorte de objetos de fotos como capas. Lo comprobamos con mediciones.
- Edición - hasta diez imágenes de referencia, indicación del área de edición con círculo, pintura o máscara, preservación de identidad de personas y apariencia de productos.
- Texturas y tipografía - mejor iluminación en retratos y disposición de textos considerando la fuente y la composición.
Además, panoramas desde una sola foto, infografías y storyboards con hojas de personajes.
Cómo lo probamos nosotros
Instalamos el modelo localmente en una RTX 4090 y ejecutamos seis pruebas. Dos conclusiones que no están en los materiales del fabricante:
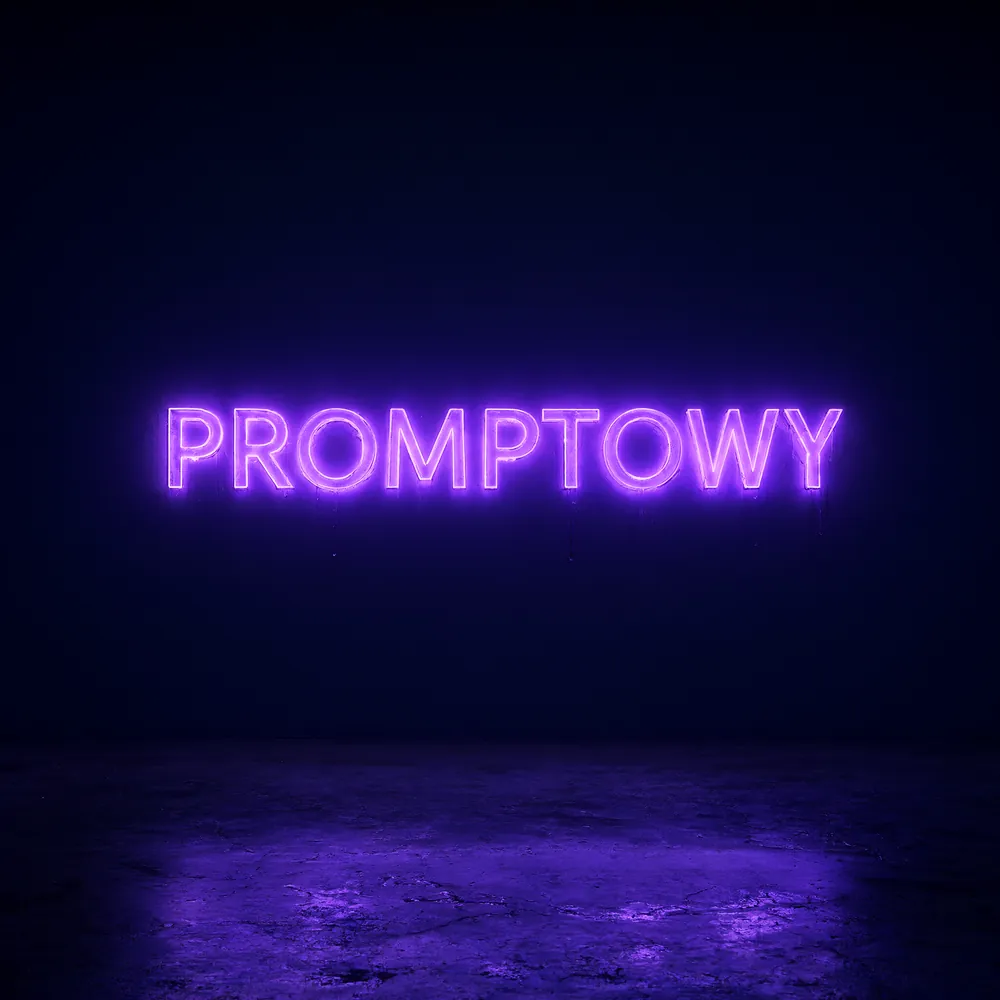
Neón con el texto [MARCA] generado localmente en resolución 2048×2048 - el texto salió perfecto a la primera.
- Los textos realmente coinciden. Un neón con el texto [MARCA] en 2048×2048 salió perfecto a la primera.
- Los prompts sobre la edad de los personajes a veces se ignoran. Una petición de retrato de mujer de treinta y tantos dio una persona claramente mayor - técnicamente excelente, pero no conforme al prompt.
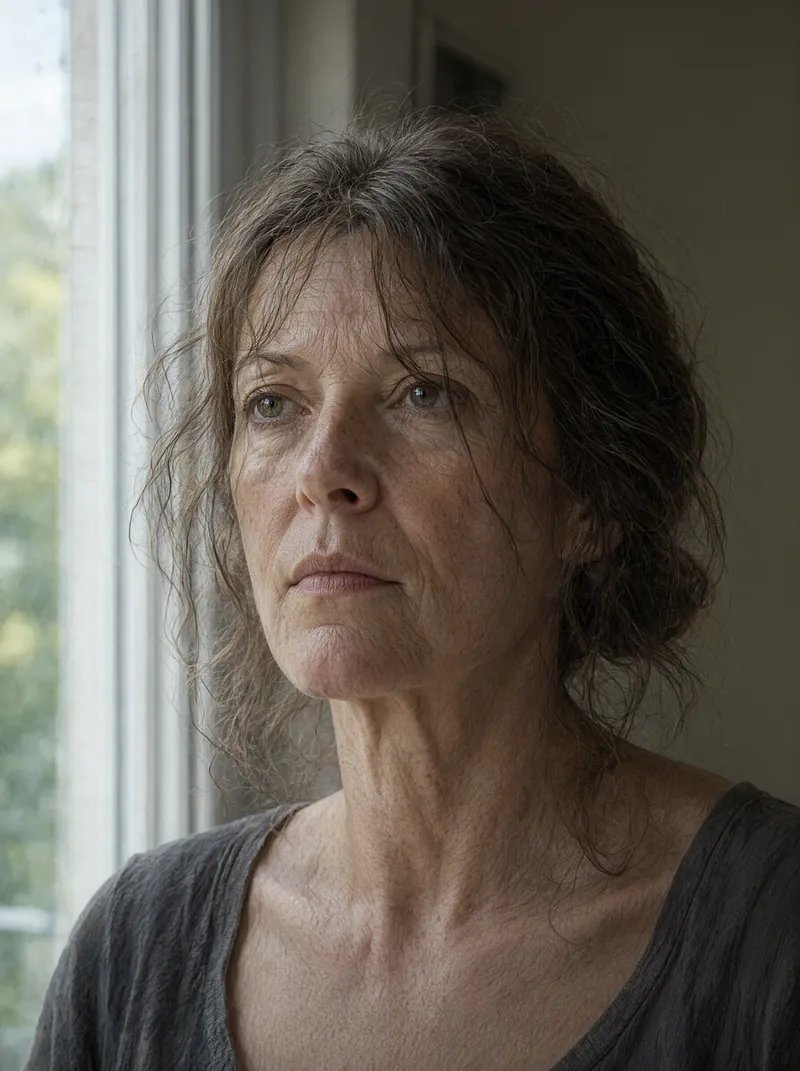
Retrato de un prompt sobre mujer de treinta y tantos. Textura de piel e iluminación impecables, edad del personaje claramente superior a la solicitada.
Tiempos, configuración y script listo están en las instrucciones de instalación, y todo lo reunimos en la guía del modelo.
Cómo se ven los resultados en la práctica
El ranking es un solo número. A continuación tres fotogramas de tres categorías diferentes, para que veas qué hay detrás de esa cifra.
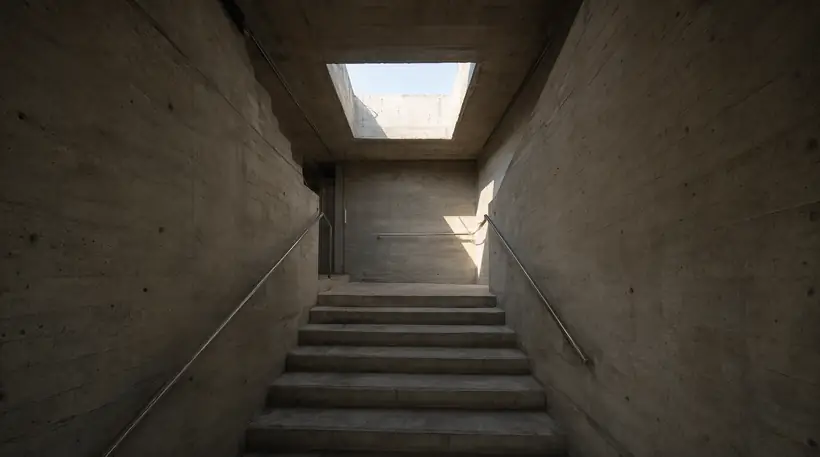
Arquitectura - categoría en la que el modelo destaca más.
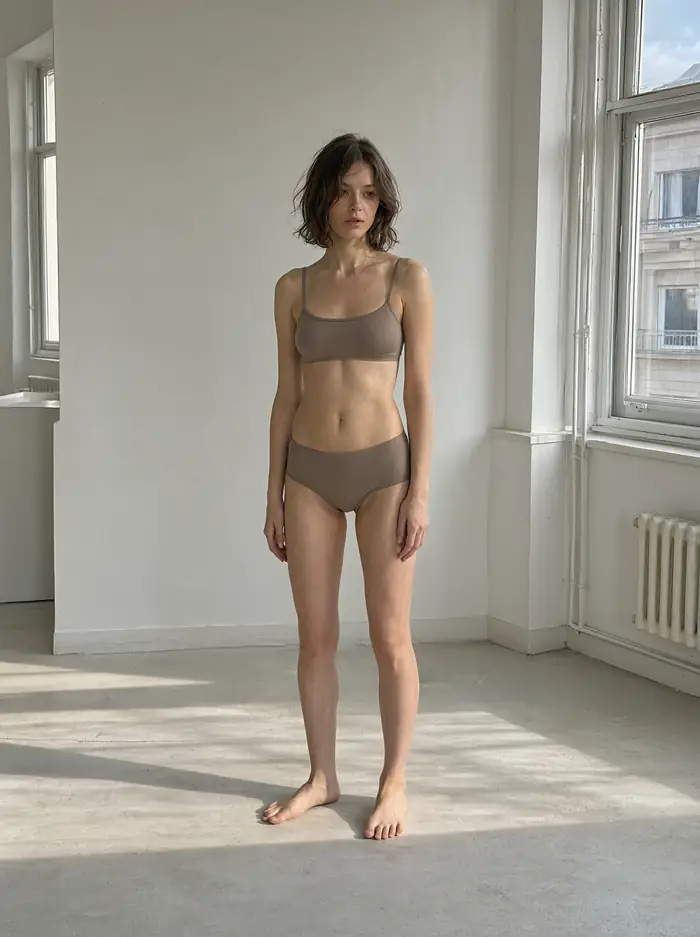
Luz natural - el modelo renuncia al aspecto de campaña en favor del reportaje.
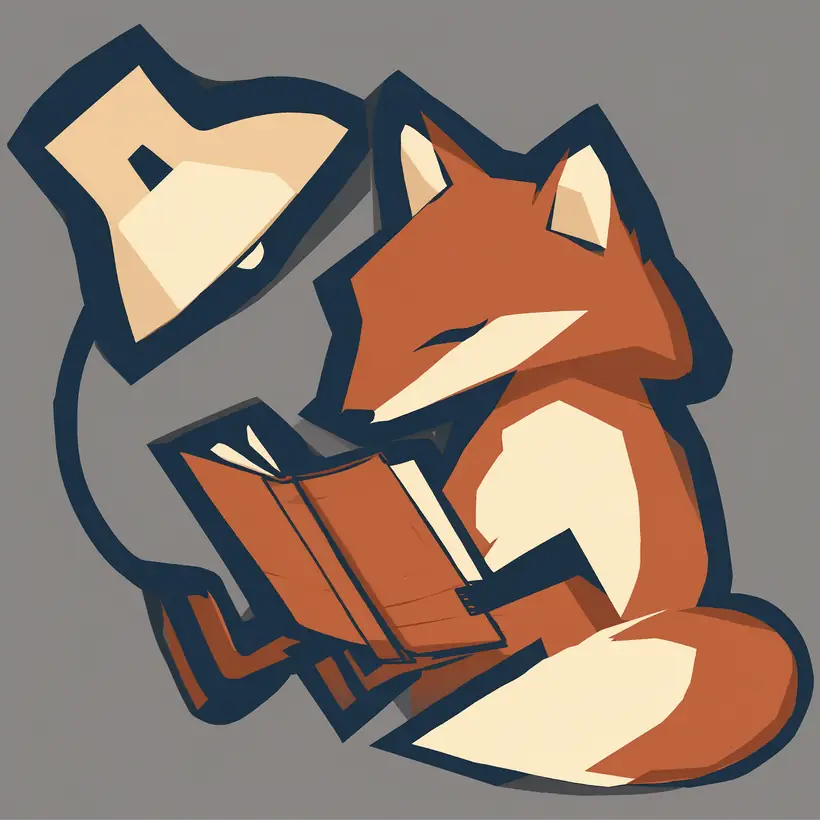
Ilustración vectorial - correcta, pero genérica. Aquí se ve el límite.
Preguntas frecuentes
¿Qué puntuación tiene Qwen-Image-2.1 en el benchmark?
60,28 puntos en Qwen-Image-Bench, séptimo lugar entre 29 modelos comparados.
¿Es el mejor modelo de imagen abierto?
En esta comparativa sí - supera a FLUX 2 Max (55,33), Hunyuan Image 3.0 (50,81) y GLM Image (48,19). Recuerda que el ranking proviene del fabricante.
¿Cuántos parámetros tiene?
7 mil millones en la parte que genera la imagen, en 32 capas DiT de flujo único.
¿Qué modelo gana el ranking?
GPT Image 2.5 Sunburst con 67,01 puntos, por delante de GPT Image 2 (64,69) y Grok Imagine 2.0 (63,47).
¿Es mejor que Nano Banana?
Según este ranking sí: 60,28 frente a 59,82 para Nano Banana 2.0 y 59,45 para Nano Banana Pro. La diferencia es, sin embargo, pequeña.
Fuentes y fecha de verificación
- Resultados extraídos el 22 de septiembre de 2026 del gráfico Qwen-Image-Bench publicado en el anuncio de lanzamiento en qwen.ai
- descripción de arquitectura y funciones del mismo anuncio y de la ficha del modelo Qwen/Qwen-Image-2.1. El fabricante proporcionó estos datos en forma de gráfico
- no de tabla - las cifras en la tabla anterior son una lectura de la redacción de ese gráfico. Las observaciones sobre textos y edad de personajes provienen de nuestras propias pruebas en RTX 4090
More on this from FULGOR

 revista·Versiones sin censura de Qwen-Image-2.1: qué hacen los pesosEl modelo ejecutado en local no tiene filtro porque el filtro es una capa separada en el servicio cloud. Qué significa esto en la práctica.