Gemma 4 31B en local con RTX 4090: VRAM, velocidad y análisis
Probamos Gemma 4 31B en local con una RTX 4090: rinde a 42 tok/s, consume 19 GB de VRAM y ofrece licencia Apache 2.0. Te contamos sus puntos clave y exigencias.
👁 115 lecturas
Gemma 4 31B de Google es el modelo denso con pesos abiertos más potente que cabe por completo en una sola tarjeta RTX 4090. Lo hemos ejecutado en Ollama en nuestro equipo de pruebas: genera unos 42 tokens por segundo, obtuvo un 9,5 sobre 10 en nuestras pruebas en polaco, pero ocupa casi los 24 GB de memoria de la gráfica y resulta implacable con discos lentos. Es la primera entrega de nuestra serie sobre modelos abiertos en local para tu ordenador.
Estado a 8 de octubre de 2026
- Modelo:
gemma4:31b-it-qaten Ollama 0.40.1 (versión con cuantización posterior al entrenamiento, archivo de 17,65 GB + 1,2 GB del módulo de imagen). - Licencia: Apache 2.0 (permite uso comercial).
- Velocidad: 40,7-43,4 tok/s de generación, aprox. 870-1240 tok/s en lectura del prompt.
- Memoria gráfica: 19,2 GB según Ollama, pico de 24,0 GB en toda la GPU (nvidia-smi).
- Pruebas en polaco: 9,5/10 en nuestras 5 tareas de evaluación.
- Descarga: 40 min 41 s. Carga desde disco USB: de 1 min 53 s a 14 min 33 s.
Por qué elegimos Gemma 4 31B para empezar la serie
Cada semana seleccionamos un modelo abierto, lo ejecutamos en una RTX 4090 (24 GB, Windows 11) y medimos los mismos aspectos: proceso de instalación, tiempos de carga, velocidad, consumo de memoria, rendimiento lingüístico y términos de licencia. Al repasar las novedades recientes para esta primera entrega, la mayoría quedaron descartadas:
- Ling 3.1 Flash: cuenta con 560.000 millones de parámetros y por ahora no dispone de pesos abiertos (lo detallamos en nuestro artículo sobre Ling 3.1 Flash).
- Mistral Small 4: pese a su nombre, integra 119.000 millones de parámetros; incluso con una cuantización muy agresiva no entra en 24 GB.
- GLM 5.3: carece de variante ligera «Air», y el más pequeño de la familia, GLM-5.3 Flash, suma 320.000 millones de parámetros.
- Hy Image 3.5: Tencent únicamente ha habilitado acceso mediante API, sin pesos descargables.
- Qwen 3.8 27B: ya lo analizamos a fondo en nuestra comparativa de 7 modelos locales.
Gemma 4 31B lleva disponible desde la primavera, pero aún no habíamos publicado mediciones directas en hardware real. Se trata del modelo más grande de la serie Gemma 4 y el único denso (completo) capaz de operar en una sola tarjeta gráfica de consumo.
Ficha técnica del modelo
| Característica | Gemma 4 31B |
|---|---|
| Desarrollador | Google DeepMind |
| Parámetros | 30.700 millones, arquitectura densa (todos activos en cada token) |
| Ventana de contexto | Hasta 256.000 tokens |
| Entrada y salida | Entrada multimodal (texto e imagen); salida exclusivamente texto |
| Idiomas | Más de 140 en entrenamiento, unos 35 con soporte directo según Google |
| Licencia | Apache 2.0 |
| En Ollama | gemma4:31b-it-qat (Q4_0, 19 GB), gemma4:31b-it-q8, gemma4:31b-it-bf16 (63 GB) |
| Parámetros recomendados | temperature 1.0, top_p 0.95, top_k 64 |
La variante QAT se entrenó contemplando específicamente la cuantización a 4 bits, por lo que sufre una degradación de calidad notablemente menor que una cuantización estándar a 4 bits. Para una gráfica de 24 GB es la única opción sensata: la compilación q8 sobrepasa los 30 GB.
Nuestras pruebas de rendimiento en una RTX 4090
| Medición | Resultado | Observaciones |
|---|---|---|
| Descarga (18,2 GB) | 40 min 41 s | Velocidad oscilando entre 4 y 29 MB/s |
| Primera carga en memoria | Error tras 5 min | Mensaje «timed out waiting for llama-server to start» (ver solución abajo) |
| Carga desde disco USB | 8 min 32 s y 14 min 33 s | Unidad D: externa por USB, entre 44 y 66 MB/s |
| Carga desde caché del sistema | 1 min 53 s | El archivo permanecía en la RAM tras la lectura previa |
| Generación (5 tareas) | 40,7-43,4 tok/s | Contexto de 8192, sin modo de pensamiento |
| Texto largo (1438 tokens) | 41,3 tok/s | Aprox. 800 palabras procesadas en 35 s |
| Generación con contexto de 32 768 | 42,2 tok/s | Sin pérdida de rendimiento |
| Lectura del prompt | 870-1240 tok/s | Primera petición más lenta (24 tok/s, fase de inicialización) |
| Memoria de tarjeta según Ollama | 19,2 GB (8k) / 19,3 GB (32k) | 100% asignado a la GPU |
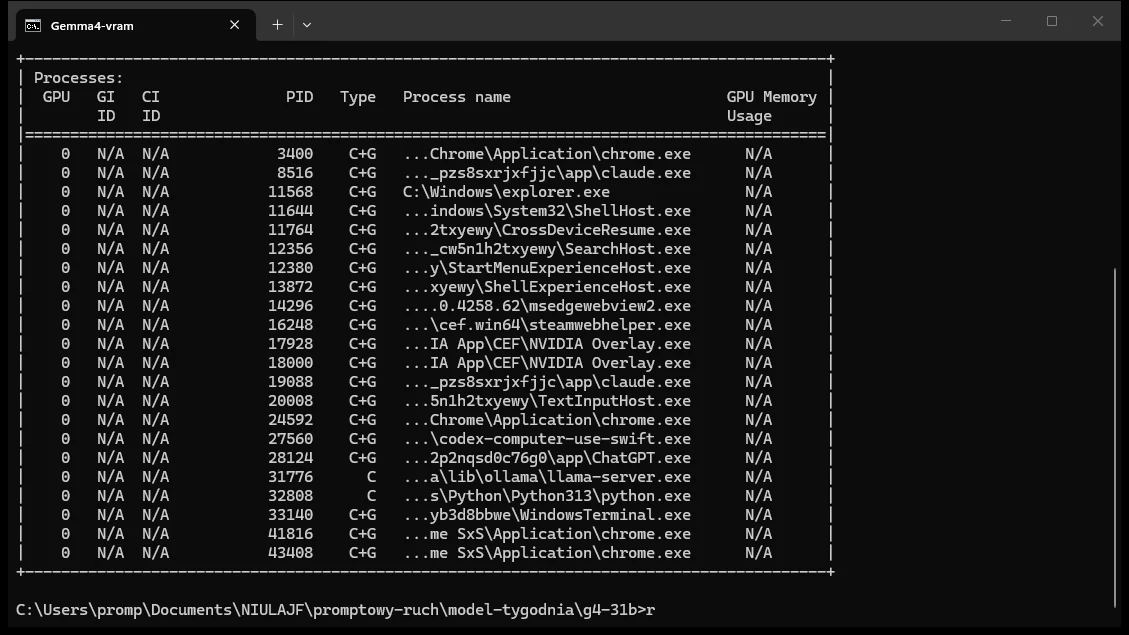
| Uso total según nvidia-smi | 21,8 GB tras cargar, 24,0 GB en pico | Incluye entorno de escritorio y navegador (~0,8 GB antes de iniciar) |
Una velocidad de 41 a 43 tokens por segundo supera la velocidad habitual de lectura humana. A modo comparativo: en nuestra comparativa de modelos locales, la versión reducida Gemma 4 12B alcanzaba 104 tok/s en 8 GB, mientras que Qwen 3.8 27B rendía a la mitad y requería 17 GB. La versión 31B es la más lenta de este grupo, pero mantiene una fluidez perfecta para diálogo interactivo.
Lección clave: no compartas la tarjeta con otra aplicación
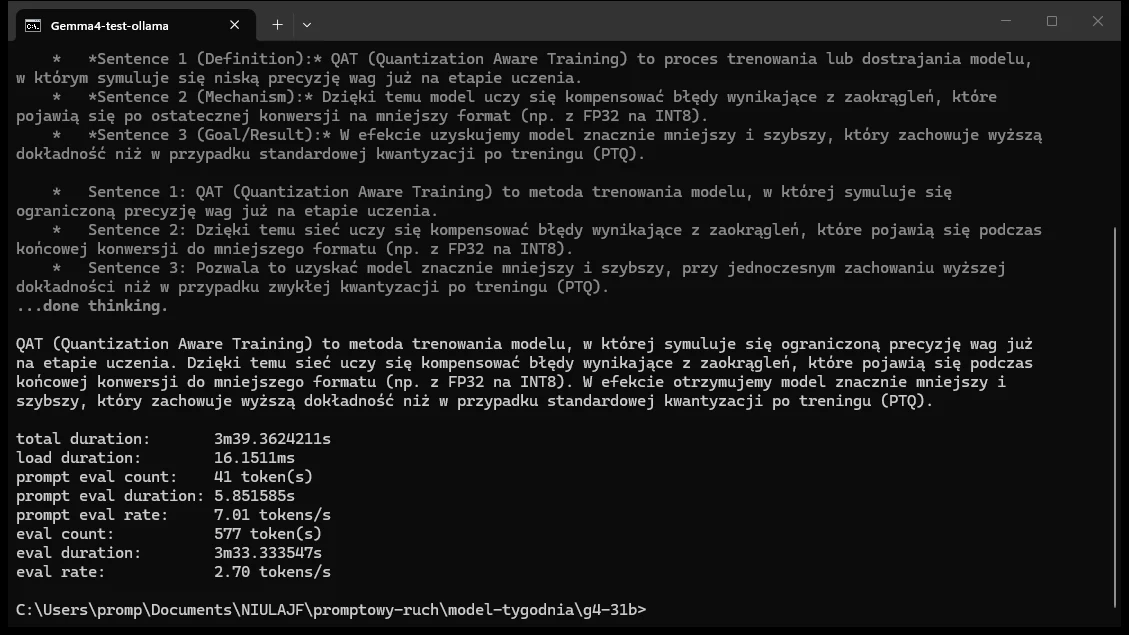
Al capturar las pantallas del test, iniciamos en segundo plano una tarea de generación de imágenes en ComfyUI en esa misma gráfica. La memoria de vídeo quedó completamente saturada (23,9 de los 24 GB disponibles), Windows comenzó a paginar memoria hacia la RAM convencional del sistema y la tasa de generación se hundió de 42 a 2,7 tok/s, llegando en una prueba sucesiva a solo 0,5 tok/s. El modelo 31B no deja margen de maniobra: resulta incompatible con la ejecución simultánea de generadores de imagen y un navegador con múltiples pestañas abiertas puede apropiarse de varios cientos de megabytes críticos.
Pruebas lingüísticas: 5 tareas en polaco
Probamos el modelo en polaco a través de cinco tareas complejas para evaluar su dominio gramatical y de razonamiento fuera del inglés. Aplicaremos estas mismas pruebas a cada modelo de la serie para facilitar la comparativa, puntuando cada una de 0 a 2 puntos.
| Tarea | Puntuación | Observaciones |
|---|---|---|
| Correo de disculpa (declinación: Brzęczyszczykiewicz, Szczebrzeszyn) | 1,5/2 | Declinó con acierto «do Szczebrzeszyna» y propuso descuento del 10% con código, pero omitió el apellido («Szanowny Panie Grzegorzu») |
| Corrección de más de 8 faltas | 2/2 | Localizó todas las incorrecciones léxicas, ortográficas y 5 errores de puntuación |
| Factura: 3 partidas, IVA al 23% y 5% | 2/2 | Cuotas de IVA de 1314,00 y total de 7073,90: cálculo exacto sin fallos |
| 5 preguntas sobre Polonia | 2/2 | Zielona Góra y Gorzów, Prus, Rysy 2499 m, 1410 y 16 voivodatos |
| 3 frases hechas con ejemplos | 2/2 | Definición precisa del significado y ejemplos contextuales naturales |
| Puntuación total | 9,5/10 |
Encontramos dos particularidades formales: el modelo abusa de estructuras Markdown (listas con asteriscos, negritas frecuentes) y en la corrección textual intercaló flechas con formato LaTeX ($rightarrow$), incompatibles con interfaces de chat sin renderizador matemático. En el modo de pensamiento (activo por defecto en ollama run), razona internamente en inglés antes de redactar la respuesta definitiva en el idioma solicitado.
Correo de disculpa: respuesta íntegra del modelo (185 tokens, 42,5 tok/s)
Instrucción en polaco: Napisz krótki e-mail (do 120 słów) do klienta, pana Grzegorza Brzęczyszczykiewicza ze Szczebrzeszyna, z przeprosinami za 5-dniowe opóźnienie dostawy krzesła biurowego. Zaproponuj rabat 10% na kolejne zamówienie. Ton uprzejmy, bez przesady. Użyj poprawnej odmiany nazwiska i nazwy miejscowości. (Pide redactar un correo breve de disculpa por un retraso de 5 días en la entrega de una silla de oficina, con descuento del 10% y declinaciones gramaticales complejas de nombre y ciudad polacos).
Temat: Przeprosiny za opóźnienie w dostawie zamówienia

Szanowny Panie Grzegorzu,

chciałbym najmocniej przeprosić za 5-dniowe opóźnienie w dostawie Pana krzesła biurowego do Szczebrzeszyna. Bardzo nam przykro z powodu zaistniałej sytuacji.

W ramach rekompensaty przygotowaliśmy dla Pana kod rabatowy o wartości 10% na kolejne zamówienie w naszym sklepie: RABAT10.

Mamy nadzieję, że produkt spełni Pana oczekiwania, a ten gest pozwoli nam zachować Pana zaufanie. W razie dodatkowych pytań pozostaję do dyspozycji.

Z poważaniem,

[Twoje Imię i Nazwisko]
[Nazwa Firmy]
Corrección de texto: respuesta íntegra del modelo (306 tokens, 40,7 tok/s)
Instrucción en polaco: Popraw błędy w tekście i wypisz listę poprawek (każda w osobnym punkcie: było -> jest). Tekst: «Wczoraj poszłem do sklepu żeby kupić chleb, ale okazało się że był zamknięty. W poniedziałek napewno pójde jeszcze raz, bo mam nadzieje że będzie otwarte. Moja koleżanka która tam pracuje mówiła, że wogóle nie zamykają przed 18.« (Pide corregir las faltas de un texto informal en polaco y detallar los cambios aplicados en una lista).
Oto poprawiony tekst:

„Wczoraj poszedłem do sklepu, żeby kupić chleb, ale okazało się, że był zamknięty. W poniedziałek na pewno pójdę jeszcze raz, bo mam nadzieję, że będzie otwarty. Moja koleżanka, która tam pracuje, mówiła, że w ogóle nie zamykają przed 18.”

Lista poprawek:
* poszłem $rightarrow$ poszedłem (błąd fleksyjny)
* sklepu żeby $rightarrow$ sklepu, żeby (brak przecinka przed spójnikiem)
* okazało się że $rightarrow$ okazało się, że (brak przecinka przed spójnikiem)
* napewno $rightarrow$ na pewno (pisownia rozdzielna)
* pójde $rightarrow$ pójdę (brak polskiego znaku)
* nadzieje $rightarrow$ nadzieję (brak polskiego znaku)
* że będzie otwarte $rightarrow$ że będzie otwarty (błąd składniowy - sklep jest rodzaju męskiego)
* koleżanka która $rightarrow$ koleżanka, która (brak przecinka przed zdaniem podrzędnym)
* pracuje mówiła $rightarrow$ pracuje, mówiła (brak przecinka zamykającego zdanie podrzędne)
* wogóle $rightarrow$ w ogóle (pisownia rozdzielna)
Factura con IVA: respuesta íntegra del modelo (176 tokens, 41,4 tok/s)
Instrucción en polaco: Policz fakturę. Pozycje netto: laptop 4200,00 (VAT 23%), książka 59,90 (VAT 5%), usługa szkolenia 1500,00 (VAT 23%). Podaj VAT dla każdej pozycji, sumę netto, sumę VAT i sumę brutto. Kwoty zaokrąglaj do grosza. Na końcu jedna linia: BRUTTO = … (Pide calcular los importes netos, cuotas de IVA y total con IVA de tres conceptos comerciales redondeados a dos decimales).
Oto wyliczenia dla poszczególnych pozycji:

*   Laptop: netto 4200,00 $rightarrow$ VAT (23%): 966,00
*   Książka: netto 59,90 $rightarrow$ VAT (5%): 3,00
*   Usługa szkolenia: netto 1500,00 $rightarrow$ VAT (23%): 345,00

Suma netto: 5759,90
Suma VAT: 1314,00
Suma brutto: 7073,90

BRUTTO = 7073,90
5 preguntas sobre Polonia: respuesta íntegra del modelo (60 tokens, 43,4 tok/s)
Instrucción en polaco: Odpowiedz krótko na 5 pytań, każde w jednej linii: 1) Jakie miasta są siedzibami władz województwa lubuskiego? 2) Kto napisał «Lalkę«? 3) Jak wysoki jest najwyższy szczyt Polski i jak się nazywa? 4) W którym roku odbyła się bitwa pod Grunwaldem? 5) Ile województw ma Polska? (Cuestionario sobre capitales administrativas, literatura clásica, altitud geográfica, fechas históricas y división territorial).
1) Zielona Góra i Gorzów Wielkopolski.
2) Bolesław Prus.
3) 2499 m n.p.m., Rysy.
4) 1410.
5) 16.
Modismos y frases hechas: respuesta íntegra del modelo (303 tokens, 42,0 tok/s)
Instrucción en polaco: Wyjaśnij prostym językiem znaczenie trzech polskich frazeologizmów i do każdego podaj jedno zdanie przykładowe: «wyjść jak Zabłocki na mydle«, «rzucać grochem o ścianę«, «mieć muchy w nosie«. (Petición de explicar con claridad tres expresiones idiomáticas polacas y aportar una frase de ejemplo para cada una).
Oto wyjaśnienia tych frazeologizmów napisane prostym językiem:

1. Wyjść jak Zabłocki na mydle
*   Znaczenie: Oznacza ponieść klęskę, sromotnie przegrać lub zostać z niczym, mimo że miało być inaczej (często po tym, jak ktoś wierzył w łatwy zysk).
*   Przykład: *Kupiłem ten tani telefon przez internet, ale okazał się zepsuty i sprzedawca nie chce oddać pieniędzy - wyszedłem jak Zabłocki na mydle.*

2. Rzucać grochem o ścianę
*   Znaczenie: Mówić do kogoś, kto zupełnie nie słucha, nie rozumie lub ignoruje nasze argumenty i prośby.
*   Przykład: *Tłumaczę synowi już godzinę, że musi posprzątać pokój, ale to jak rzucanie grochem o ścianę.*

3. Mieć muchy w nosie
*   Znaczenie: Być w złym humorze bez wyraźnego powodu, być marudnym lub poirytowanym.
*   Przykład: *Nie podchodź teraz do Anny, bo od samego rana ma muchy w nosie i na wszystko się gniewa.*
Licencia: qué permite su uso comercial
Gemma 4 se distribuye bajo licencia Apache 2.0. Representa un avance notable frente a Gemma 3, que dependía de condiciones de uso propietarias de Google con prohibiciones específicas. En la práctica implica que:
- Puedes utilizar el modelo con fines comerciales, incluso integrado en aplicaciones para clientes finales.
- Puedes realizar ajustes finos (fine-tuning) y distribuir versiones modificadas siempre que mantengas los avisos de licencia.
- No pagas ninguna tarifa a Google: tu gasto se limita al hardware y al consumo eléctrico.
Cómo instalarlo y ejecutarlo paso a paso
- Instala Ollama desde ollama.com (hemos empleado la versión 0.40.1). Si almacenas tus modelos en otra unidad, define la variable de entorno
OLLAMA_MODELS(en nuestro casoD:AIollama). Puedes consultar los detalles en nuestra guía de Ollama. - Descarga el modelo (~18 GB):
ollama pull gemma4:31b-it-qat
- Si almacenas los modelos en un disco lento, amplía el tiempo de espera. Ollama aplica un límite de 5 minutos por defecto. En nuestro disco USB la lectura tardó entre 8 y 14 minutos, provocando el fallo «timed out waiting for llama-server to start». Para solucionarlo en PowerShell (cerrando previamente Ollama desde la bandeja del sistema):
$env:OLLAMA_LOAD_TIMEOUT = "30m"
ollama serve
La mejor alternativa técnica sigue siendo alojar este modelo en una unidad interna NVMe.
- Inicia y comprueba el rendimiento desde otra ventana:
ollama run gemma4:31b-it-qat --verbose "Explica en tres frases en qué consiste la cuantización QAT."
El modificador
--verboseañade al cierre el «eval rate» en tokens por segundo. Para omitir la fase de razonamiento interno, añade--think=false. - Revisa la ocupación de la GPU:
ollama ps
nvidia-smi
En la columna PROCESSOR debe figurar «100% GPU». Si aparece repartido entre CPU y GPU, disminuye la ventana de contexto o cierra procesos que ocupen VRAM.
- Configuración de contexto mediante la API (método empleado para nuestras mediciones de tabla):
curl http://127.0.0.1:11434/api/chat -d "{"model":"gemma4:31b-it-qat","messages":[{"role":"user","content":"Hola"}],"think":false,"options":{"num_ctx":32768}}" - Descarga el modelo de la memoria al terminar:
ollama stop gemma4:31b-it-qat
A quién le conviene usar Gemma 4 31B en local
- Sí, si cuentas con una gráfica de 24 GB (RTX 4090, 3090 o 5090) y requieres máxima calidad de generación sin transferir información confidencial a servidores externos.
- Sí, para tratamiento de documentación privada, revisiones de estilo o tareas de síntesis: sus 42 tok/s ofrecen agilidad suficiente para flujos de trabajo diarios.
- No, si dispones de 16 GB de VRAM o menos: es más recomendable optar por Gemma 4 12B, que demostró un comportamiento sobresaliente en pruebas de texto y resulta unas 2,5 veces más veloz.
- No, si planeas generar vídeo o imágenes al mismo tiempo en la misma tarjeta.
Hemos analizado el resto de alternativas de código abierto en nuestra guía sobre IA en local, y detallamos el reparto de memoria según la escala del modelo en nuestro artículo sobre cuánta VRAM necesitas.
Preguntas frecuentes
¿Cuánta VRAM necesita Gemma 4 31B?
En su compilación QAT (cuantizada a 4 bits), Ollama consume 19,2 GB con un contexto de 8.000 tokens y 19,3 GB con 32.000 tokens. El uso global del sistema en GPU alcanzó picos de 24,0 GB, por lo que exige en la práctica una tarjeta con 24 GB de memoria de vídeo dedicada sin otros procesos en paralelo.
¿Funciona bien Gemma 4 31B en una RTX 4090?
Sí, se ejecuta íntegramente en la GPU con un rendimiento sostenido de 40 a 43 tokens por segundo. La condición imprescindible es que ninguna otra aplicación sature la VRAM: al compartir recursos con ComfyUI la velocidad se redujo drásticamente hasta cifras de 0,5 a 2,7 tok/s.
¿Qué tal se desenvuelve Gemma 4 31B en tareas de idiomas complejos?
Ofrece un rendimiento sobresaliente: obtuvo un 9,5 sobre 10 en nuestras cinco pruebas en polaco, resolviendo con precisión cálculos matemáticos y datos factuales. Su único desliz fue prescindir del apellido en la redacción del correo formal.
¿Se puede utilizar comercialmente Gemma 4?
Sí, la licencia Apache 2.0 autoriza su aprovechamiento comercial, la adaptación mediante ajuste fino y la redistribución del software.
¿Por qué falla Ollama al cargar Gemma 4 31B?
El motivo habitual radica en una velocidad de disco reducida: el tiempo límite de espera por defecto es de 5 minutos. Conviene definir OLLAMA_LOAD_TIMEOUT=30m o migrar los pesos a un SSD NVMe. Otra causa frecuente es la falta de VRAM libre, lo que exige cerrar cualquier otra aplicación que emplee aceleración por hardware.
¿Conviene elegir Gemma 4 31B o 12B?
Para tarjetas de 24 GB, el modelo 31B es la elección óptima cuando prima la profundidad analítica. Para hardware con menos memoria o cuando la prioridad es la tasa de generación, la versión 12B resulta más práctica (alcanzó 104 tok/s ocupando 8 GB en nuestros análisis previos).
Fuentes y fecha de verificación
- Ficha técnica de Gemma 4 31B en Hugging Face (licencia, especificaciones y ajustes recomendados).
- Catálogo de versiones de gemma4 en Ollama.
- Mediciones propias en hardware de pruebas (RTX 4090 24 GB, Windows 11, Ollama 0.40.1), realizadas a 8 de octubre de 2026.
More on this from FULGOR

 benchmarks·Miniaturas de YouTube con IA: probamos su legibilidad en móvilGeneramos miniaturas de YouTube con IA y evaluamos su legibilidad reducidas a 320 píxeles, el tamaño habitual en un móvil.